

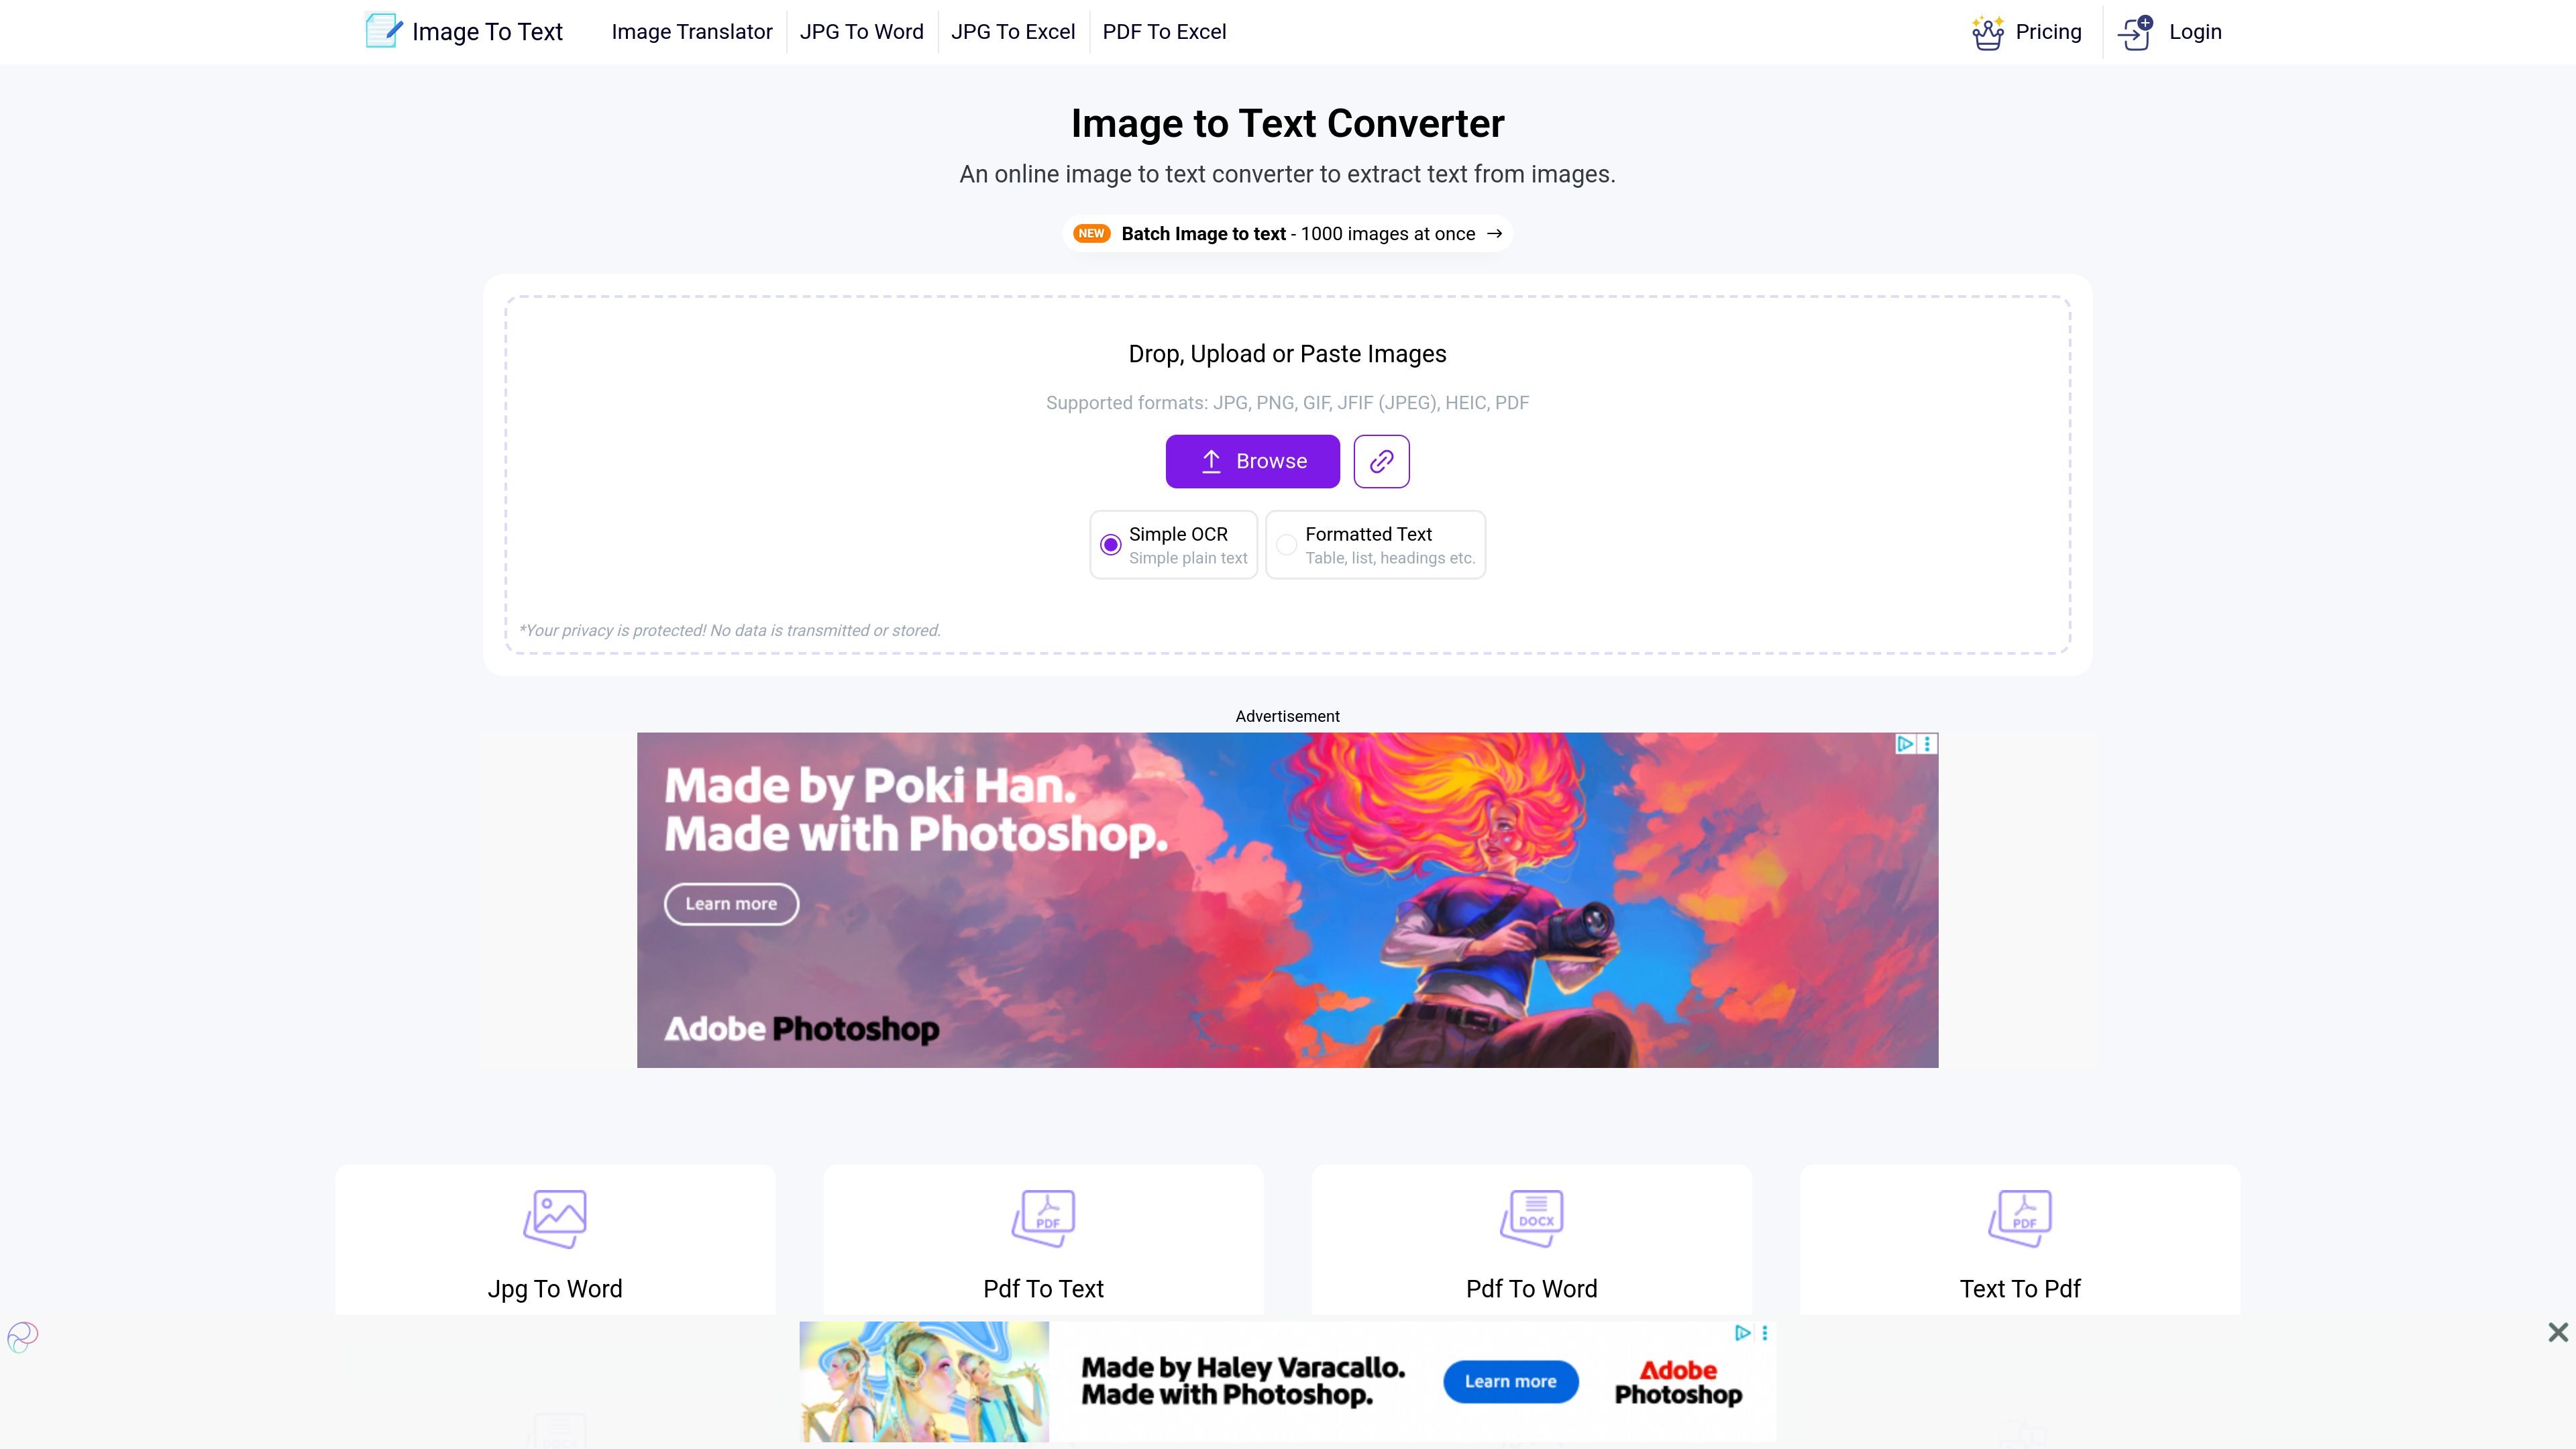
複数の入力方法
ファイルをアップロードする、変換ツールにドラッグ&ドロップする、または画像URLを貼り付けて、ブラウザからOCRを開始できます。
Image to Text は、画像やその他のアップロードファイルから直接ブラウザ内でテキストを抽出できるオンラインOCRツールです。ホームページでは、単一画像、画像の一括アップロード、貼り付け入力やURLからの画像テキスト変換に対応する無料サービスとして紹介されています。
基本的な使い方はシンプルです。ファイルをアップロードし、画像リンクを貼り付けるか、コンテンツをドラッグ&ドロップしてからOCRを実行し、抽出したテキストをコピーまたはダウンロードします。サイトには、シンプルなプレーンテキストモードに加えて整形テキストモードもあり、素早いテキスト取得だけでなく、文書、メモ、スクリーンショットなどのレイアウトを考慮した抽出にも使えます。
製品サイトには、PDF to Text や一括画像テキスト変換ツールなどの関連コンバーターもあり、より多くの処理量が必要なユーザー向けにプレミアムプランも用意されています。これらの有料プランでは、より大きな送信上限、より高速な処理階層、そして無料のブラウザツール以上のワークフローオプションが追加されます。
ファイルをアップロードする、変換ツールにドラッグ&ドロップする、または画像URLを貼り付けて、ブラウザからOCRを開始できます。
1枚の画像を変換することも、大量のファイルをまとめて処理するバッチワークフローを使うこともでき、ホームページでは最大1,000枚を一度に処理できると案内されています。
シンプルなOCRのプレーンテキストと、表、リスト、見出しなどのレイアウト要素の保持を目指す整形テキストモードを選べます。
サイトでは、Tesseract OCR を基盤としており、英語、スペイン語、フランス語、ドイツ語、日本語、中国語、アラビア語を含む複数言語に対応していると説明しています。
変換後は、結果をクリップボードにコピーしたり、テキストファイルとしてダウンロードしたりでき、対応ページでは追加の形式オプションも表示されます。
ホームページでは、アップロードは送信も保存もされないと記載されており、プライバシー重視のワークフローであることが示されています。
スクリーンショット、標識の写真、カメラで撮った画像を、すばやくコピペしやすい編集可能なテキストに変換します。
授業ノート、スキャンした手書きメモ、紙の文書を、後で編集や共有ができるデジタルテキストに変換します。
大量のOCR処理が必要なときに、画像を1件ずつ変換する代わりに、1回のセッションで多くのファイルを処理します。
表、見出し、リスト構造など、読みやすさを保ちたい元データには整形テキストモードを使います。
元の素材が単体画像ではなくPDFのときは、PDF to Text などサイト内の関連OCRツールを使います。
はい。Image to Text は無料のオンラインOCRツールとして説明されており、ホームページでは、登録なしで画像をアップロード、ドラッグ&ドロップ、または貼り付けてテキストを抽出できると案内されています。
ホームページには、このツールが JPG、PNG、GIF、JFIF(JPEG)、HEIC、PDF に対応していると記載されており、説明文では TIFF やその他の一般的な画像形式にも触れられています。
このツールには、プレーンテキストモードと整形テキストモードがあります。表示されるページでは、対応するワークフローでテキストファイル出力、HTML、Markdown などのダウンロード विकल्पも表示されます。
はい。ホームページでは、バッチ画像テキスト変換が最大1,000枚の画像まで一度に対応すると案内されています。また、プレミアムページでは、より高い送信上限とバッチ上限を持つ有料プランが示されています。
ホームページでは、プライバシーが保護され、データは送信も保存もされないと説明されています。PDFからテキストへのページでも、同じ内容がそのワークフローについて繰り返し記載されています。
トラフィックデータは参考情報としてご利用ください。

www.browseract.com
BrowserAct is a no-code AI web scraping and browser automation platform that builds reusable Bots from plain-language data requests. It helps teams collect structured, refreshed web data in the cloud or give local AI agents a browser layer for web tasks.
starterbuild.com
Page to Markdown is a free Chrome extension that converts webpages or selected content into clean, usable Markdown. It is designed for notes, documentation, research, AI tools, and coding workflows.
microsoft.github.io
GraphRAG is a research project and data pipeline for extracting structured information from unstructured text with language models, then using graph-based context to support question answering over private data.

www.llamaindex.ai
LlamaParse is an AI document parsing platform that converts complex PDFs, office files, spreadsheets, images, and other documents into structured, AI-ready data. It is designed for developers and enterprise teams building retrieval, extraction, and document automation workflows.

python.useinstructor.com
Instructor is a developer library for extracting structured, validated data from large language models. It uses Pydantic schemas, automatic retries, streaming, and a consistent interface across cloud, local, and routed LLM providers.

upstage.ai
Upstage AIは、複雑なファイルの変換、構造化データの抽出、文書ワークフローの構築を支援する文書処理ツールと大規模言語モデルを提供します。API、Studio、AWS Marketplace、オンプレミスに対応。