
数式と表の文書OCR
PDFや画像から数式、表、その他の文書構造を認識し、複雑な行列、行ごとの数式、多段階の表ヘッダーにも対応します。

Doc2Xは、PDFや画像から数式・表・構造化テキストを抽出し、Word、LaTeX、HTML、Markdownなどの編集可能形式へ変換するAI文書処理ツールです。多言語PDF翻訳とAPI一括処理にも対応。
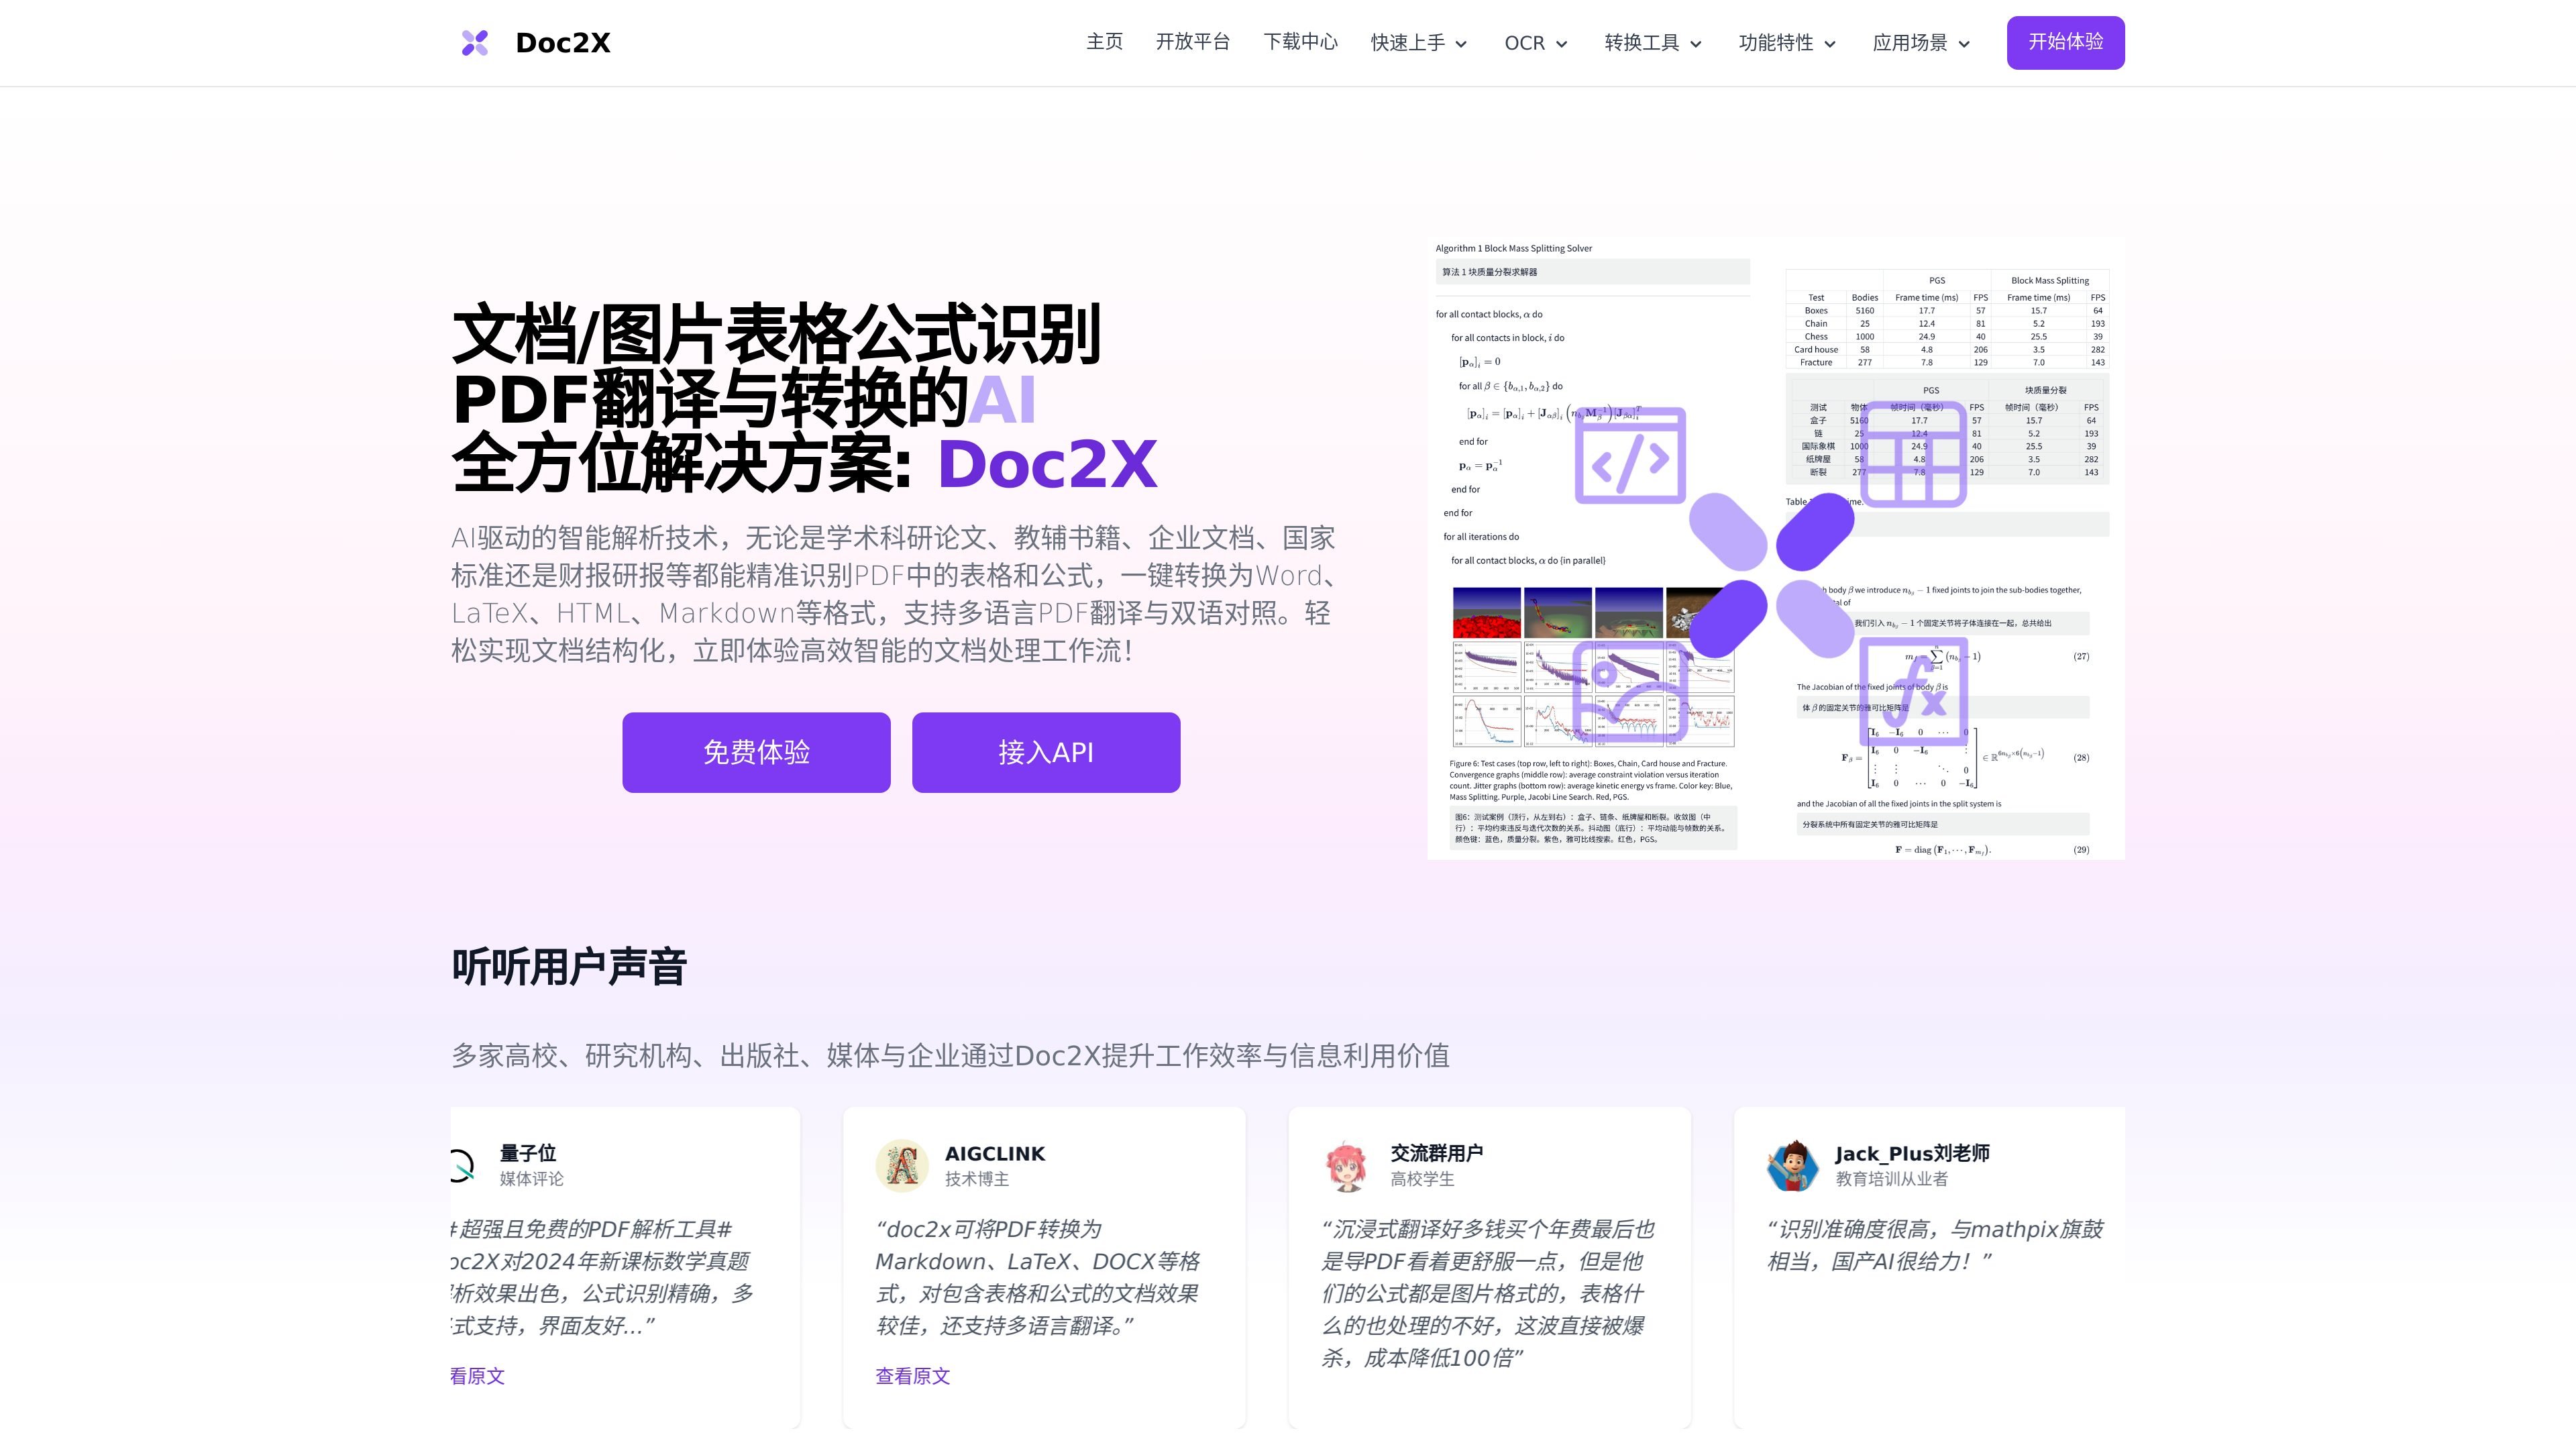
Doc2Xは、PDFや画像向けのAI文書処理製品で、OCR、翻訳、形式変換に重点を置いています。学術論文、教科書、企業文書、規格、財務報告書などから、数式、表、構造化コンテンツを抽出したいユーザー向けに位置づけられています。
この製品は、アップロードした文書をWord、LaTeX、HTML、Markdownなどの編集可能な出力に変換し、多言語PDF翻訳とバイリンガル比較もサポートしています。サイトでは、文書の構造化、編集可能な数式処理、そして大量のコンテンツを処理するチーム向けの高ボリュームAPIワークフローが強調されています。
PDFや画像から数式、表、その他の文書構造を認識し、複雑な行列、行ごとの数式、多段階の表ヘッダーにも対応します。
PDFをWord、LaTeX、HTML、Markdown、DOCX形式の出力へ変換でき、編集やエクスポート前に元のPDFと比較しながらプレビューできます。
多言語PDF翻訳をサポートし、バイリンガル比較表示や元文と訳文間の双方向ジャンプが可能です。
画像内数式のOCRワークフローを提供し、モデル出力の比較、認識した数式の編集、学術用途やオフィス作業向けのテンプレート利用ができます。
大量のPDF認識、変換、データ抽出ワークフローに向けたバッチ処理とAPIアクセスを提供します。
研究者や学生は、論文PDFを編集可能なテキスト、数式、表に変換して、文献調査、ノート作成、論文準備に活用できます。
教師は、問題集や教科書をデジタル化し、その抽出内容を教材、バイリンガル資料、オンライン問題バンクとして再利用できます。
財務・コンプライアンス担当チームは、報告書、規格、提出書類から構造化された表やテキストを抽出し、分析や社内ナレッジワークフローに活用できます。
出版・メディアチームは、スキャンされた書籍や定期刊行物をレビュー、レイアウト、Web公開向けの編集可能なファイルに変換できます。
技術チームは、APIとバッチツールを使用して、大量の文書セットをデータ抽出、RAGパイプライン、学習コーパス準備のために処理できます。
Doc2Xは、PDFまたは画像ファイルをアップロードし、数式、表、文書構造を編集可能な出力へ抽出するためのツールです。ソースでは、変換と翻訳はブラウザ内およびAPIワークフロー経由で処理できるとも記載されています。
ソースによると、Doc2XはPDFをWord、LaTeX、HTML、Markdownに変換でき、PDF翻訳とバイリンガル比較にも対応しています。さらに、画像内数式の認識と編集可能な数式ワークフローもサポートしています。
サイトでは、Doc2Xが複雑な数式や表に対して大規模モデルのOCR技術を使用していること、またホームページから無料トライアルを利用できることが示されています。さらに、追加の連携のためのAPIドキュメントとサンプルも案内されています。
ソースによると、アップロードされた文書は暗号化され、変換後に一時サーバーファイルを削除するよう選択できます。提供されたページには、それ以外の広範なコンプライアンス認証は記載されていません。