
公式和表格文档 OCR
识别 PDF 或图片中的公式、表格和其他文档结构,包括复杂矩阵、逐行方程和多级表头。

Doc2X 是一款面向 PDF 和图片的 AI 文档处理工具,可提取公式、表格和结构化文本,并转换为 Word、LaTeX、HTML、Markdown 等可编辑格式;支持多语言 PDF 翻译、双语对照和 API 批量处理。
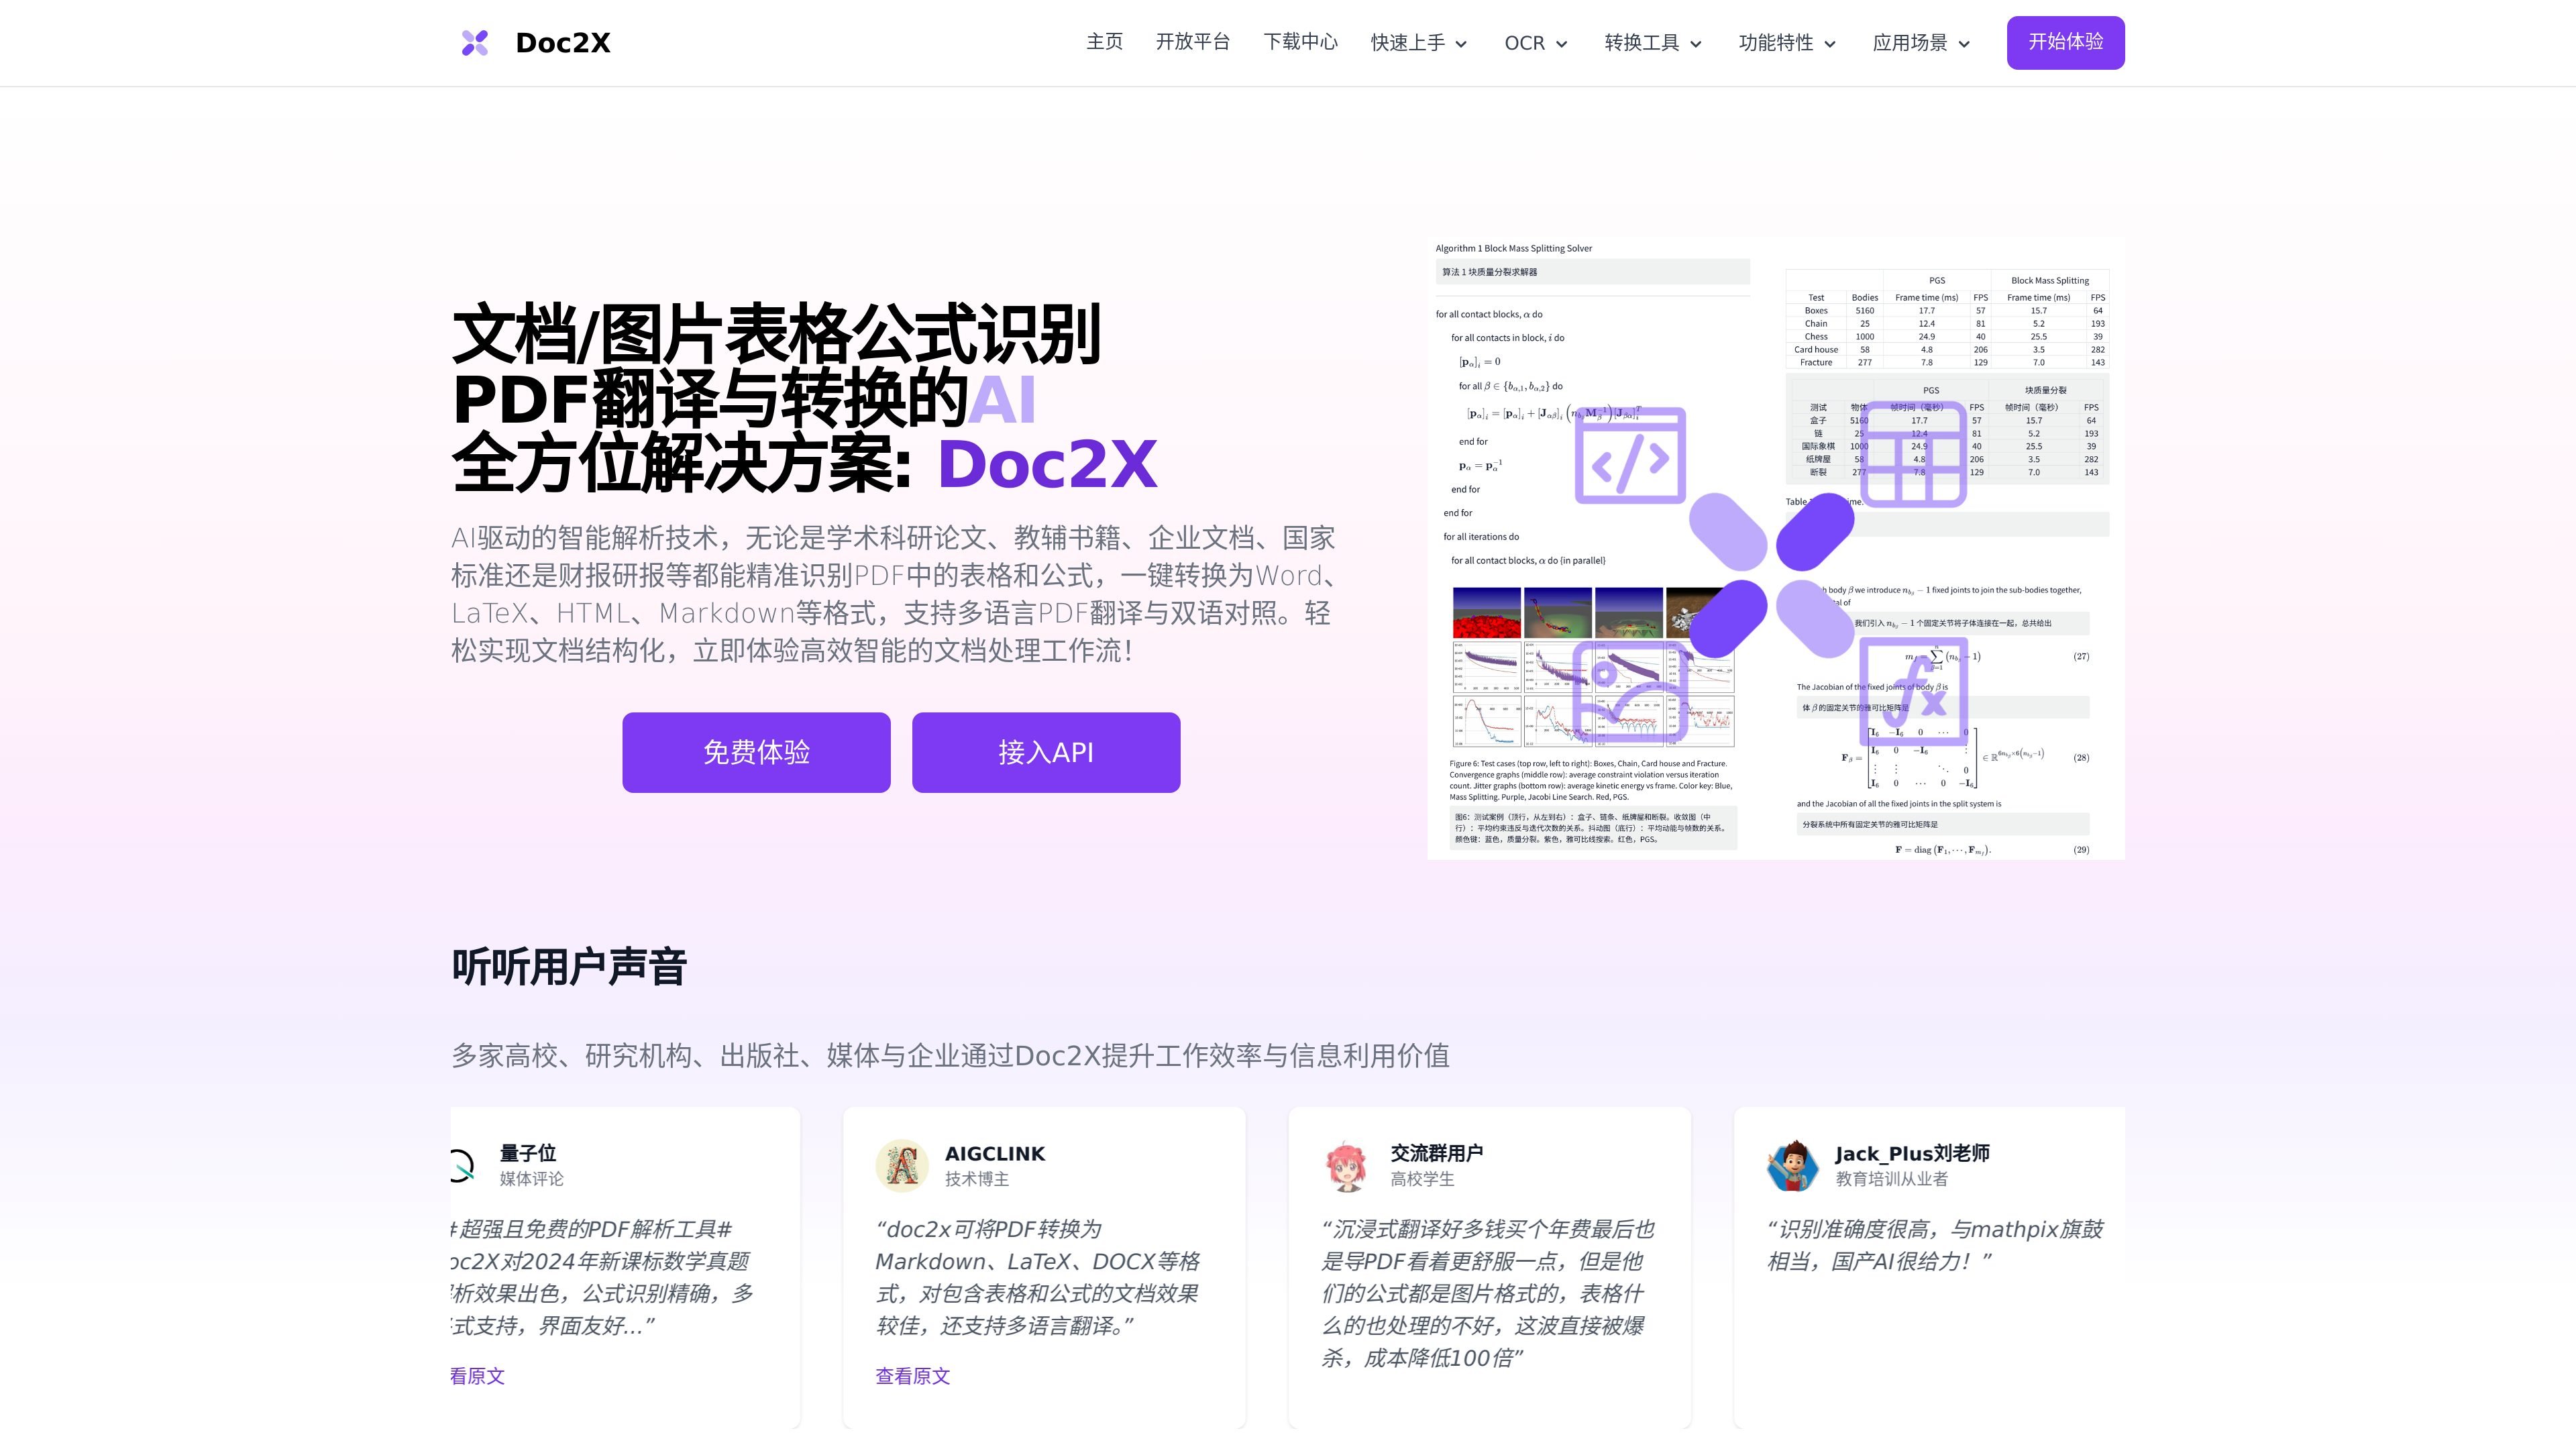
Doc2X 是一款面向 PDF 和图片的 AI 文档处理产品,重点提供 OCR、翻译和格式转换能力。它面向需要从学术论文、教材、企业文档、标准和财务报告中提取公式、表格和结构化内容的用户。
该产品可将上传文档转换为 Word、LaTeX、HTML 和 Markdown 等可编辑输出,同时还支持带双语对照的多语言 PDF 翻译。网站强调文档结构化、可编辑公式处理,以及适用于处理大量内容团队的高吞吐量 API 工作流。
识别 PDF 或图片中的公式、表格和其他文档结构,包括复杂矩阵、逐行方程和多级表头。
将 PDF 转换为 Word、LaTeX、HTML、Markdown 和 DOCX 风格输出,并支持在编辑或导出前与原始 PDF 进行预览对照。
支持多语言 PDF 翻译,提供双语对照视图,并可在原文和译文之间双向跳转。
提供图片公式 OCR 工作流,可对比模型输出、编辑识别出的公式,并使用适用于学术或办公场景的模板。
提供批量处理和 API 访问,用于大规模 PDF 识别、转换和数据提取工作流。
研究人员和学生可以将论文 PDF 转换为可编辑文本、公式和表格,用于文献综述、笔记整理和论文准备。
教师可以将练习题和教材数字化,然后将提取的内容复用于课件、双语材料或在线题库。
金融和合规团队可以从报告、标准和申报文件中提取结构化表格和文本,用于分析和内部知识工作流。
出版和媒体团队可以将扫描书籍或期刊转换为可编辑文件,用于审校、排版和网页发布。
技术团队可以使用 API 和批量工具处理大量文档集,用于数据提取、RAG 流水线或训练语料准备。
Doc2X 适用于上传 PDF 或图片文件,并将公式、表格和文档结构提取为可编辑输出。来源还说明,可在浏览器中以及通过 API 工作流完成转换和翻译。
来源显示,Doc2X 可以将 PDF 转换为 Word、LaTeX、HTML 和 Markdown,也支持带双语对照的 PDF 翻译。它还支持图片公式识别和可编辑公式工作流。
网站说明,Doc2X 使用大模型 OCR 技术处理复杂公式和表格,并且用户可以从首页获取免费试用。它还提到提供 API 文档和示例,便于进一步集成。
来源称,上传的文档会被加密,用户可以选择在转换后删除服务器上的临时文件。所提供页面中未说明更广泛的合规认证。