AI 音频 API 为应用提供语音识别、文字转语音、声音克隆、音频分析与实时处理能力,方便开发者快速集成语音功能。
AI Audio API
为 Web、移动端、原生、桌面和服务器应用添加实时通话、录制及 AI 代理工作流的 SDK 与基础设施
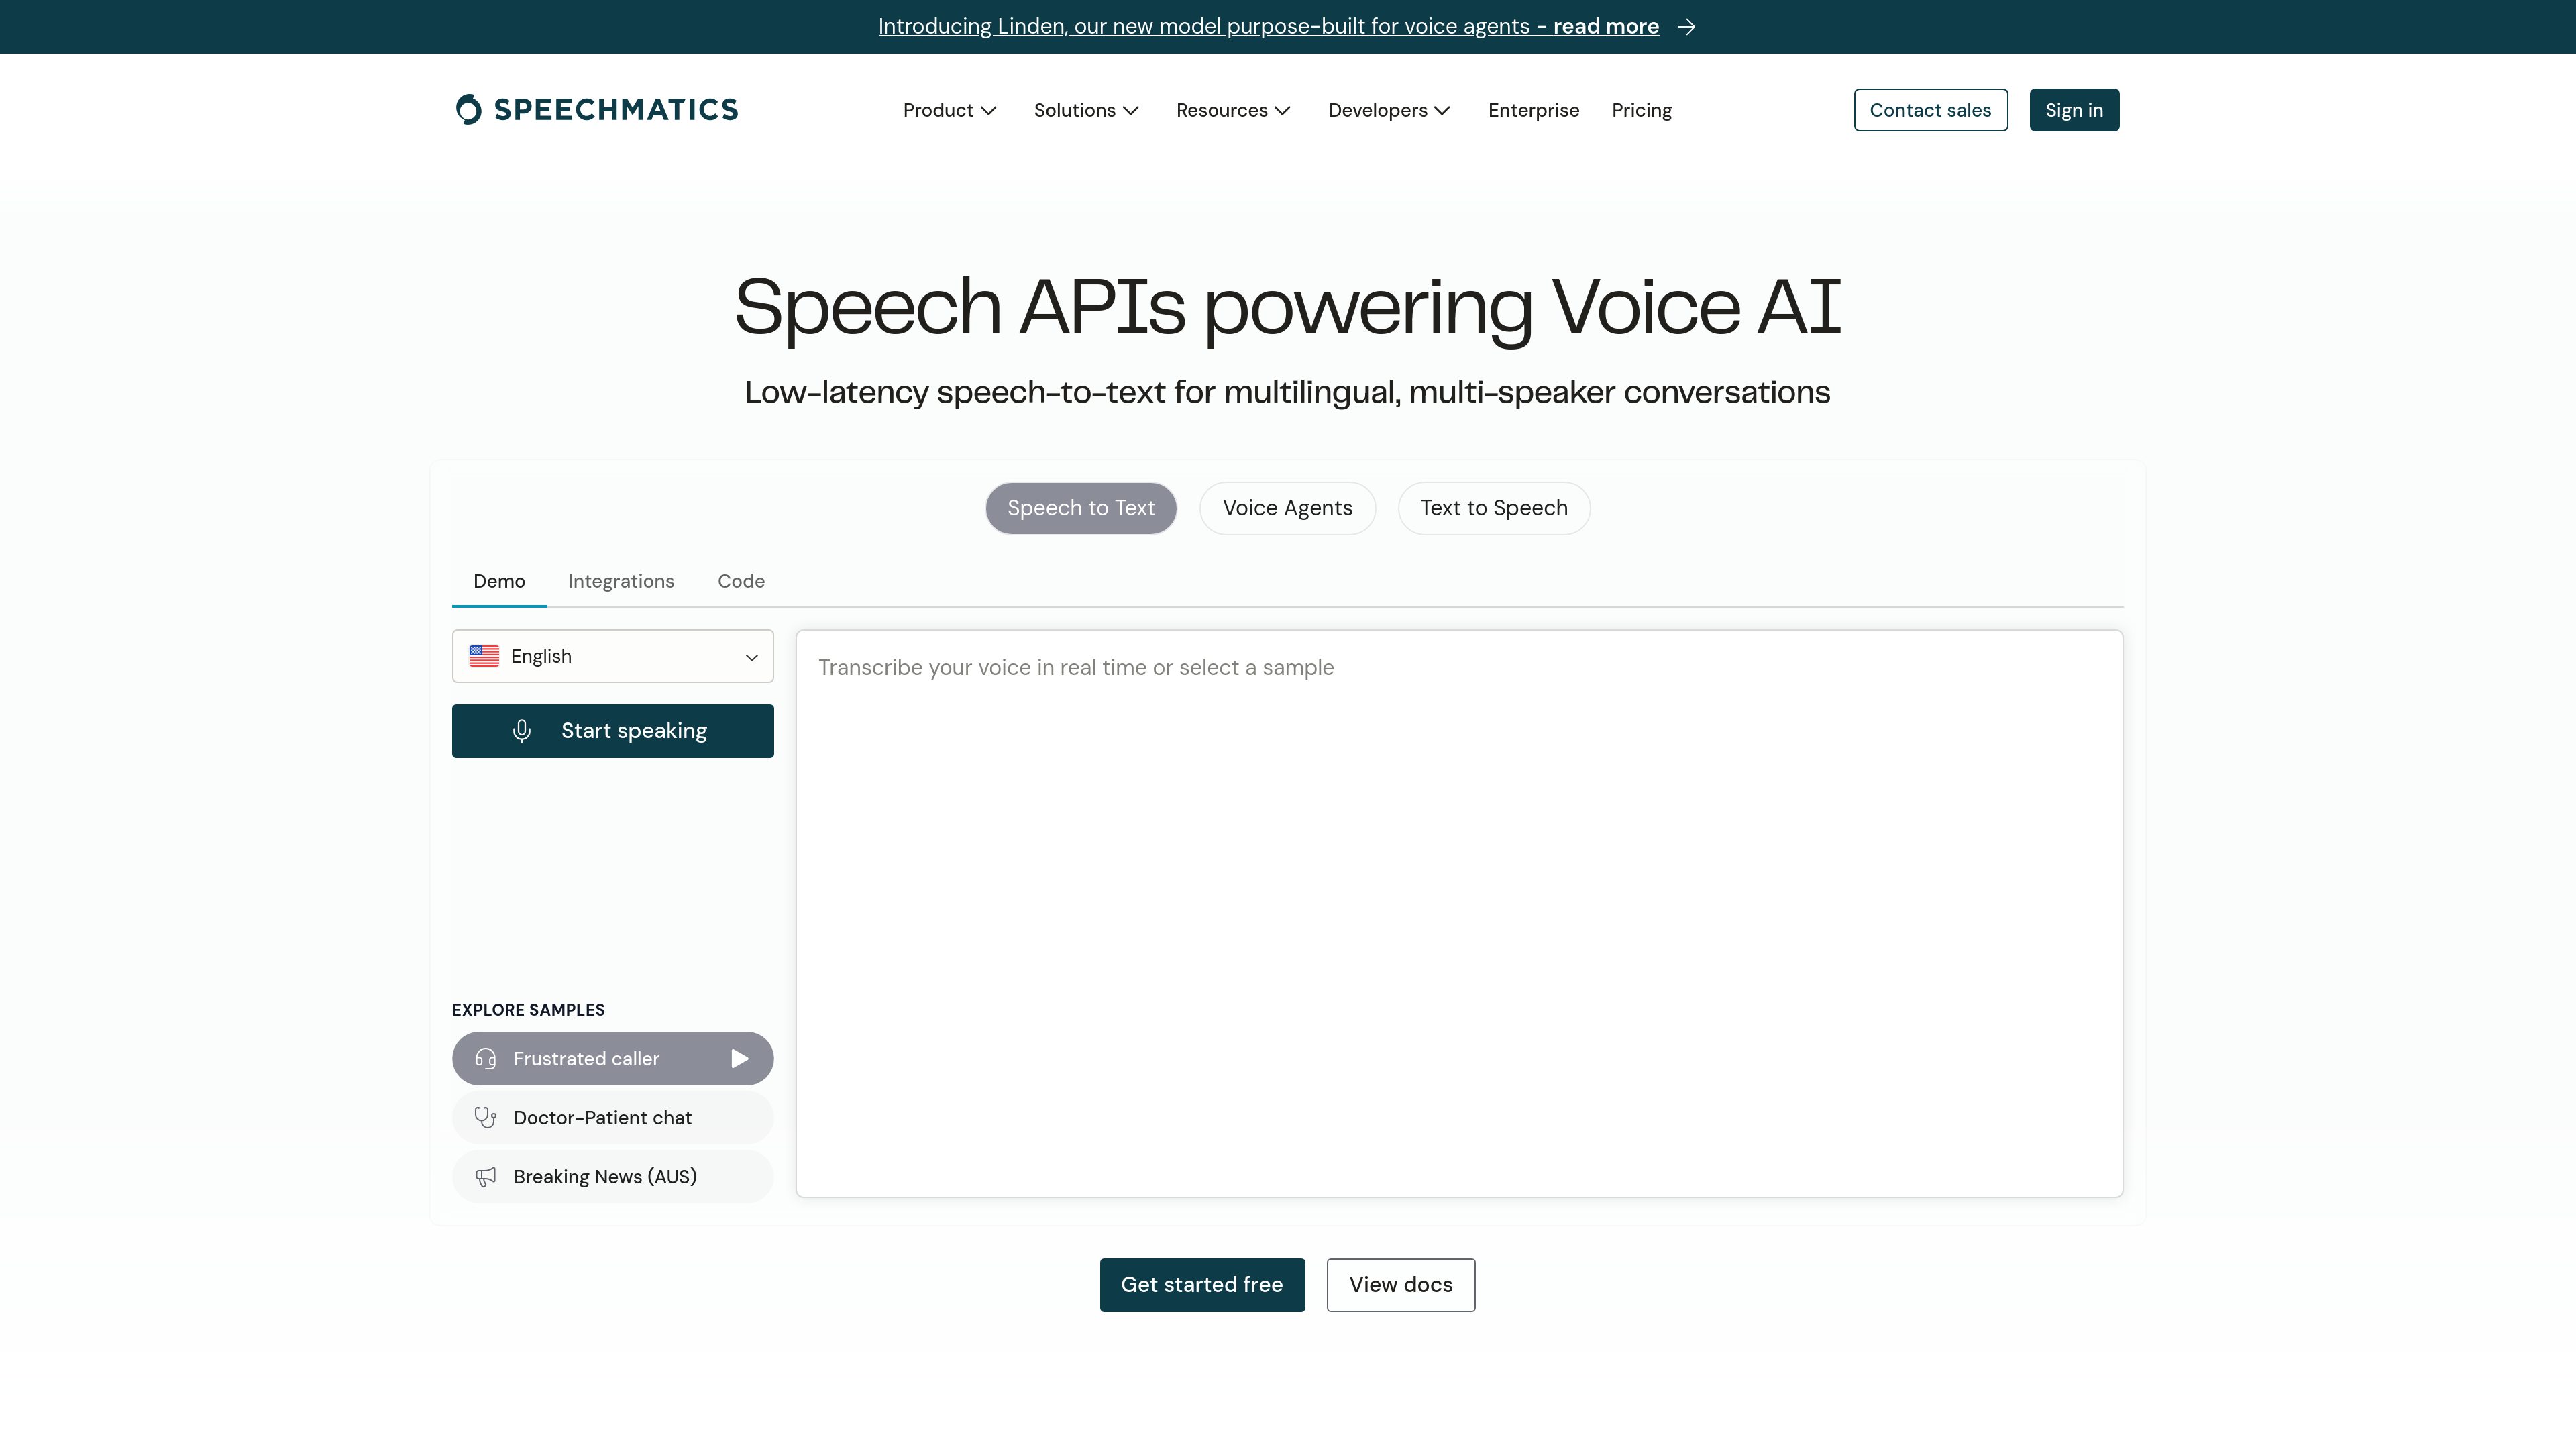
Speechmatics 提供语音转文字 API,支持预录制和实时音频、多语言语音、多位说话人及语音代理工作流,面向构建转录与语音 AI 应用的团队。
AI音乐生成器
面向创作者、制作人和开发者的一站式 AI 音乐平台
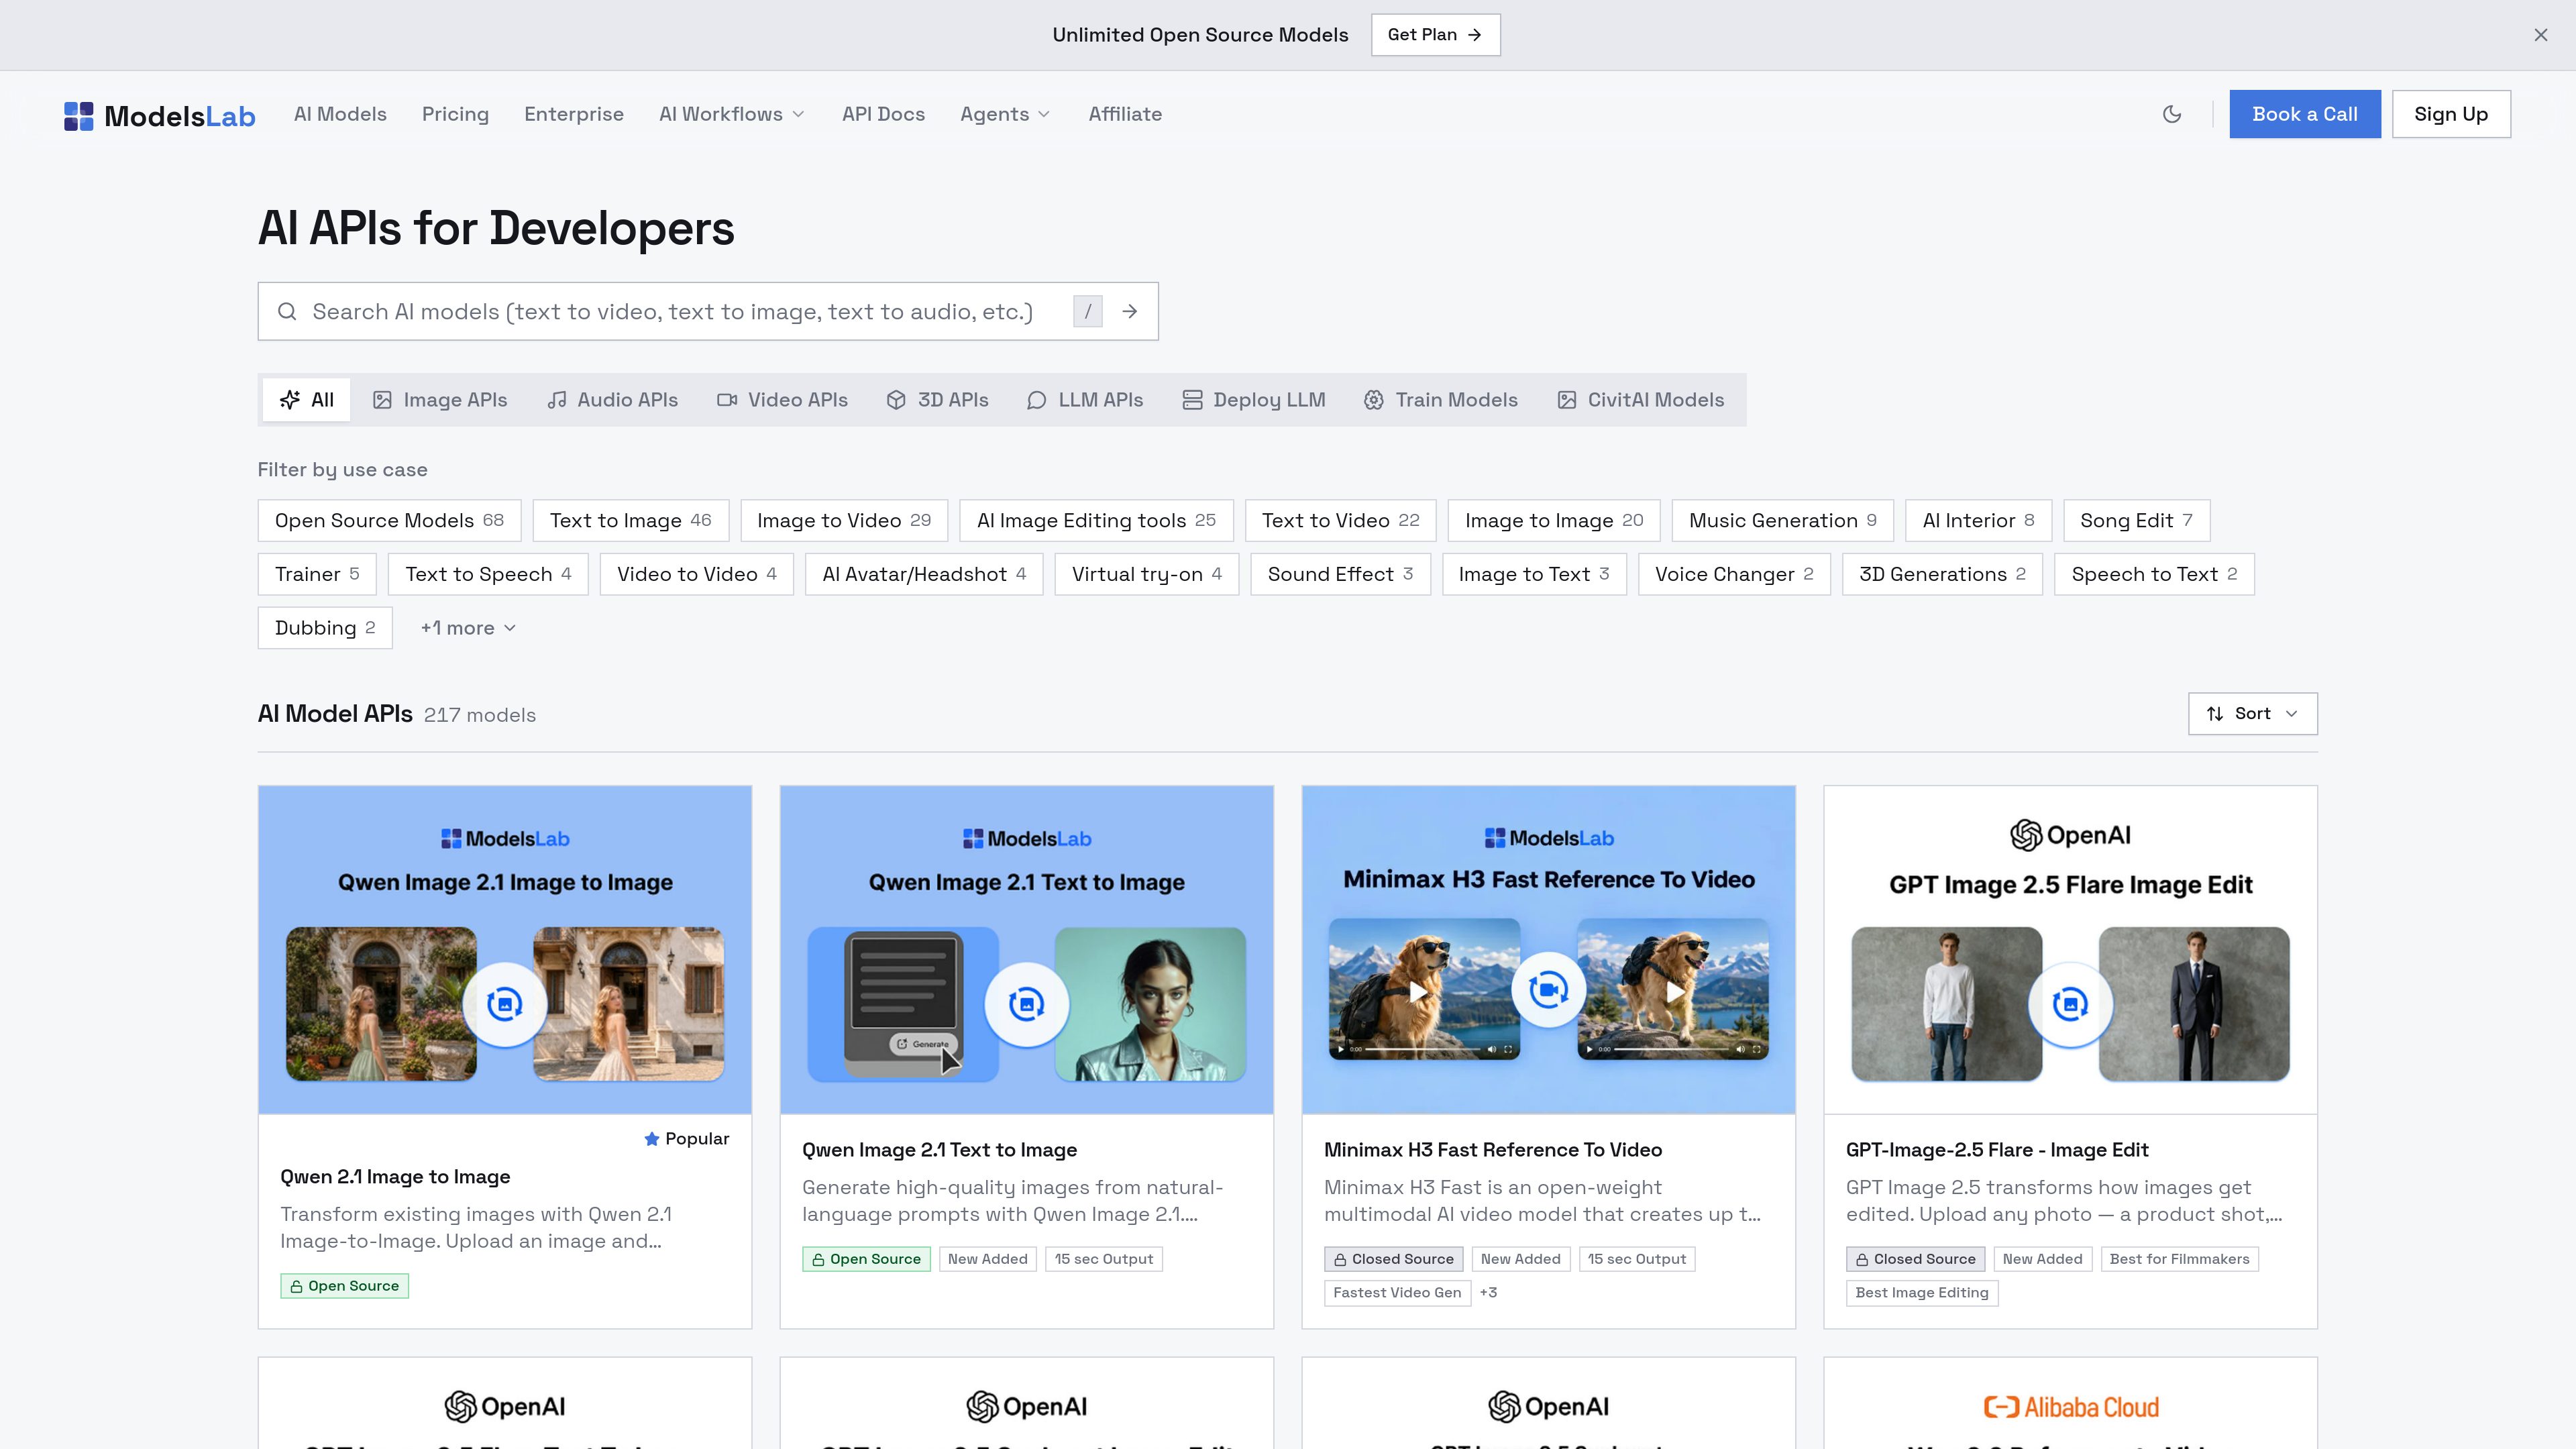
ModelsLab 面向开发者提供统一的生成式 AI API 服务,支持图像、视频、音频、3D 和大语言模型生成,帮助团队构建生成式媒体功能,无需分别集成各个模型提供商。
面向媒体与广告行业的 AI 音频制作平台,将创意简报或原始内容转化为可直接播出的音频,支持自助创作、API 嵌入式工作流和动态个性化。
面向开发者的富有表现力的文本转语音与语音克隆 API,支持流式 Simba 模型、目录音色和克隆音色、SSML,以及免费起步额度,帮助将语音集成到应用中。
AI Voice Generator
基于浏览器的文本转语音平台,可生成并调校多语言、多格式的 AI 语音输出,适用于创作者、个人和团队。
Apiframe 是统一的 REST API,可生成 AI 图像、视频和音乐。开发者与自动化团队只需通过一个 API,即可接入媒体生成功能,并使用异步任务、Webhook、SDK 和 CDN 托管输出。
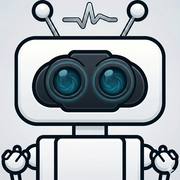
API in One 是面向网站所有者和开发者的统一 AI API 网关,通过一个 API 密钥和共享信用额度提供图像、视频、音乐、语音、聊天及 AI 工具能力。
面向企业和开发者的 API 聚合网关,通过一个访问层接入来自多个提供商的文本、图像、视频和音频模型,支持 OpenAI 兼容访问、按用量计费、模型路由与故障转移工作流。
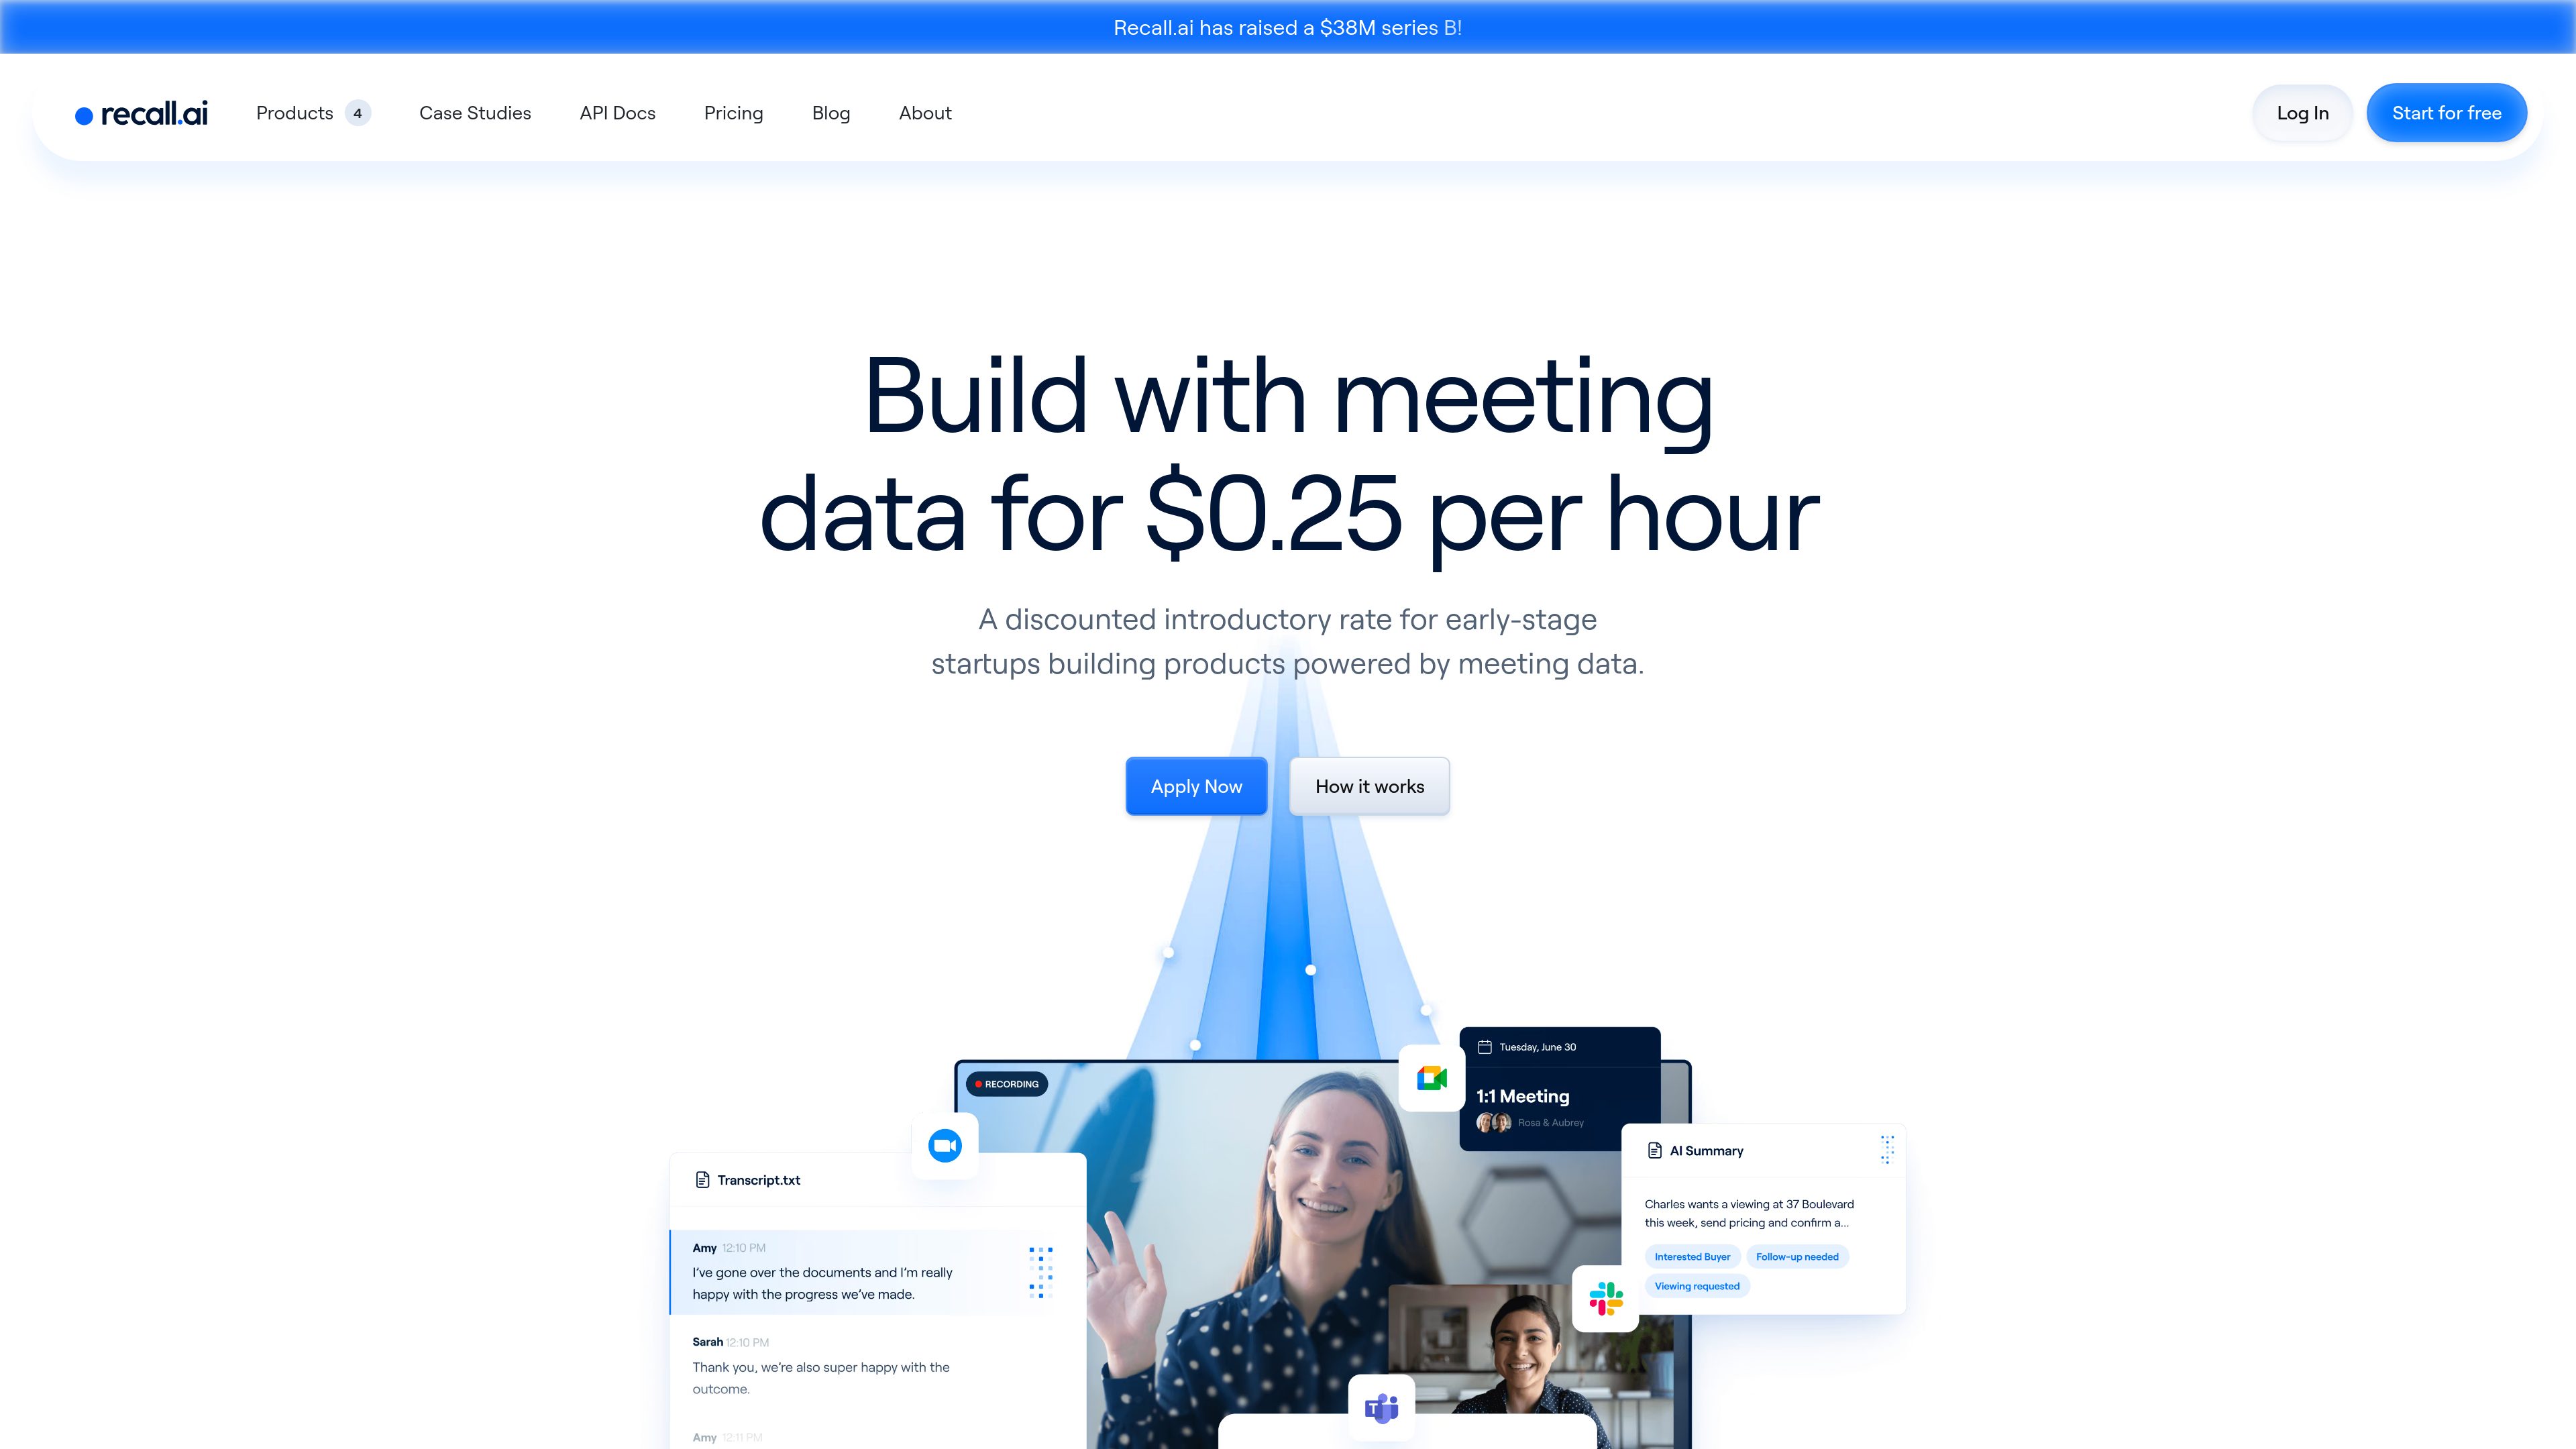
面向早期初创公司的计划,助力团队利用会议与对话数据构建产品。获批申请者可享受录音用量折扣、使用 Recall.ai 产品,并在开发和发布过程中获得支持。
AI 3D模型生成器
Stability AI 开发者平台提供 API,帮助开发者和团队将生成式音频、图像、图像编辑、放大、可控生成及 3D 资产创建功能集成到应用中。