
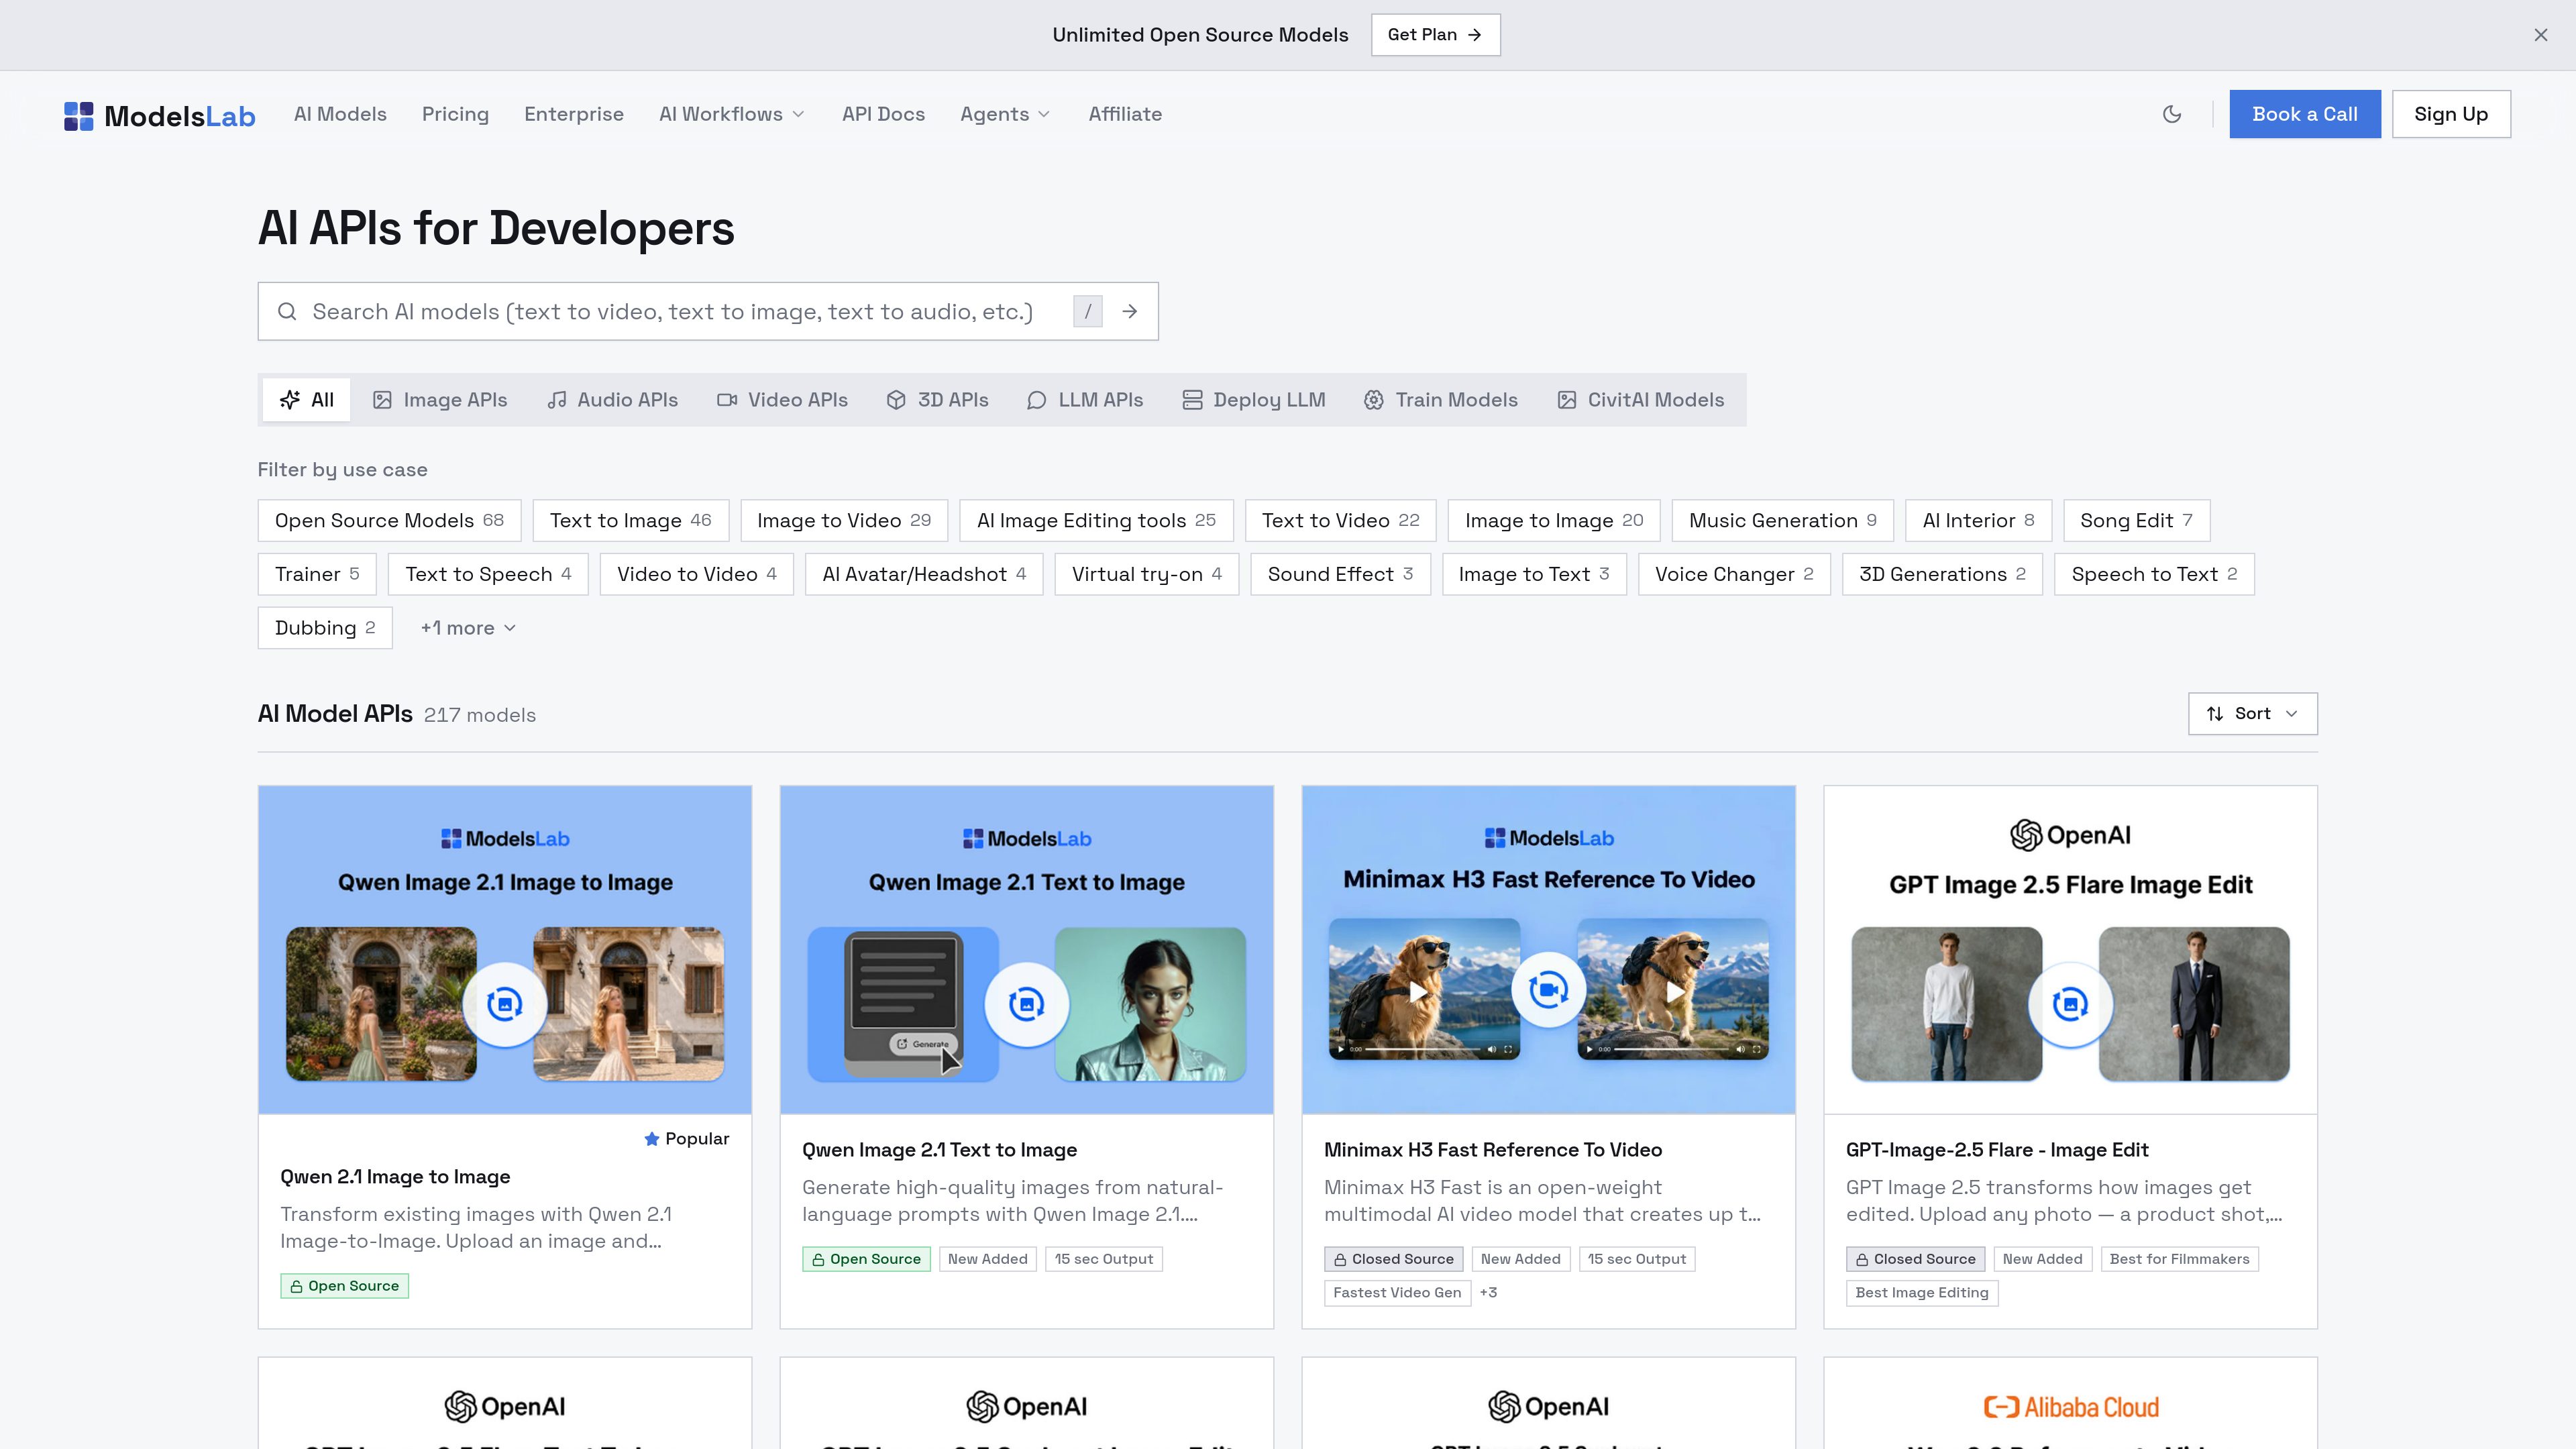
统一的生成式 AI API
通过 ModelsLab 服务访问图像、视频、音频、3D 和大语言模型(LLM)能力,无需为每种媒体类型分别选择 API。

ModelsLab 面向开发者提供统一的生成式 AI API 服务,支持图像、视频、音频、3D 和大语言模型生成,帮助团队构建生成式媒体功能,无需分别集成各个模型提供商。
ModelsLab 是面向开发者的生成式 AI API 平台。它通过一项服务提供图像、视频、音频、3D 和大语言模型(LLM)能力,其目录中同时提供开源和闭源模型。
支持的工作流包括文生图、图生图、图像编辑、文生视频、图生视频、参考图生视频、语音、音乐、配音、虚拟试衣和 3D 生成。模型页面提供描述、示例输出以及用于评估的请求正文,方便在使用前进行测试。
ModelsLab 采用付费套餐,并设有不同的调用额度和并发限制。高级第三方模型从钱包中单独计费,而 Open Source Unlimited 套餐涵盖托管开源模型的无限次生成。使用还受请求时间窗口、并发生成限制以及部分模型池上限的约束。
通过 ModelsLab 服务访问图像、视频、音频、3D 和大语言模型(LLM)能力,无需为每种媒体类型分别选择 API。
可选择文生图、图生图、图像编辑、文生视频、图生视频、参考图生视频、语音、音乐、配音和 3D 等工作流。
可用的视频模型支持组合使用文本、图像、视频和音频输入。具体模型支持基于参考内容的一致性、视频转换以及同步音频或原生音频。
模型页面展示示例输出和确切的请求正文,开发者可以在使用模型前查看其效果和调用格式。
套餐规定调用额度和并发生成限制,同时通过独立的速率时间窗口和模型池上限管理共享 GPU 容量的访问。
生成产品图像,修改背景或光照,在图像中创建可读文本,并根据文本或参考图像制作短 promotional 视频片段。
将提示词或静态图像转换为视频片段,使用参考输入在不同镜头中保持角色或物体的一致性,并在支持的情况下选择带同步音频或原生音频的模型。
通过 API 调用,将图像生成、图像编辑、语音转换、转录、配音或大语言模型推理功能添加到应用中。
查看模型示例和请求格式,然后在付费套餐下测试不同的图像、视频、音频或语言模型,再选择用于生产环境的工作流。
不能。该服务不提供免费套餐、免费额度或试用套餐。套餐起价为每月 21 美元。
该套餐每月 149 美元,可在托管的开源模型(如 Flux、SDXL、SD 1.5 和 WAN)上无限生成,并支持 15 个并行请求。高级第三方模型仍从钱包中计费。
定价常见问题说明,每个套餐都可以使用所有模型;套餐之间的区别在于用量和并发能力。高级模型仍可能产生按调用计费的钱包费用。
视频定价取决于模型,可能按输出秒数计费,也可能按照模型费率的倍数计算。视频和 3D 使用单独的速率额度,因为它们通常比图像生成需要更多 GPU 时间。
可以。在付费套餐下,通过 API 生成的输出可以用于商业用途。单个第三方模型可能有自己的上游许可条款,因此应查看适用的模型页面。
流量数据仅供参考。