
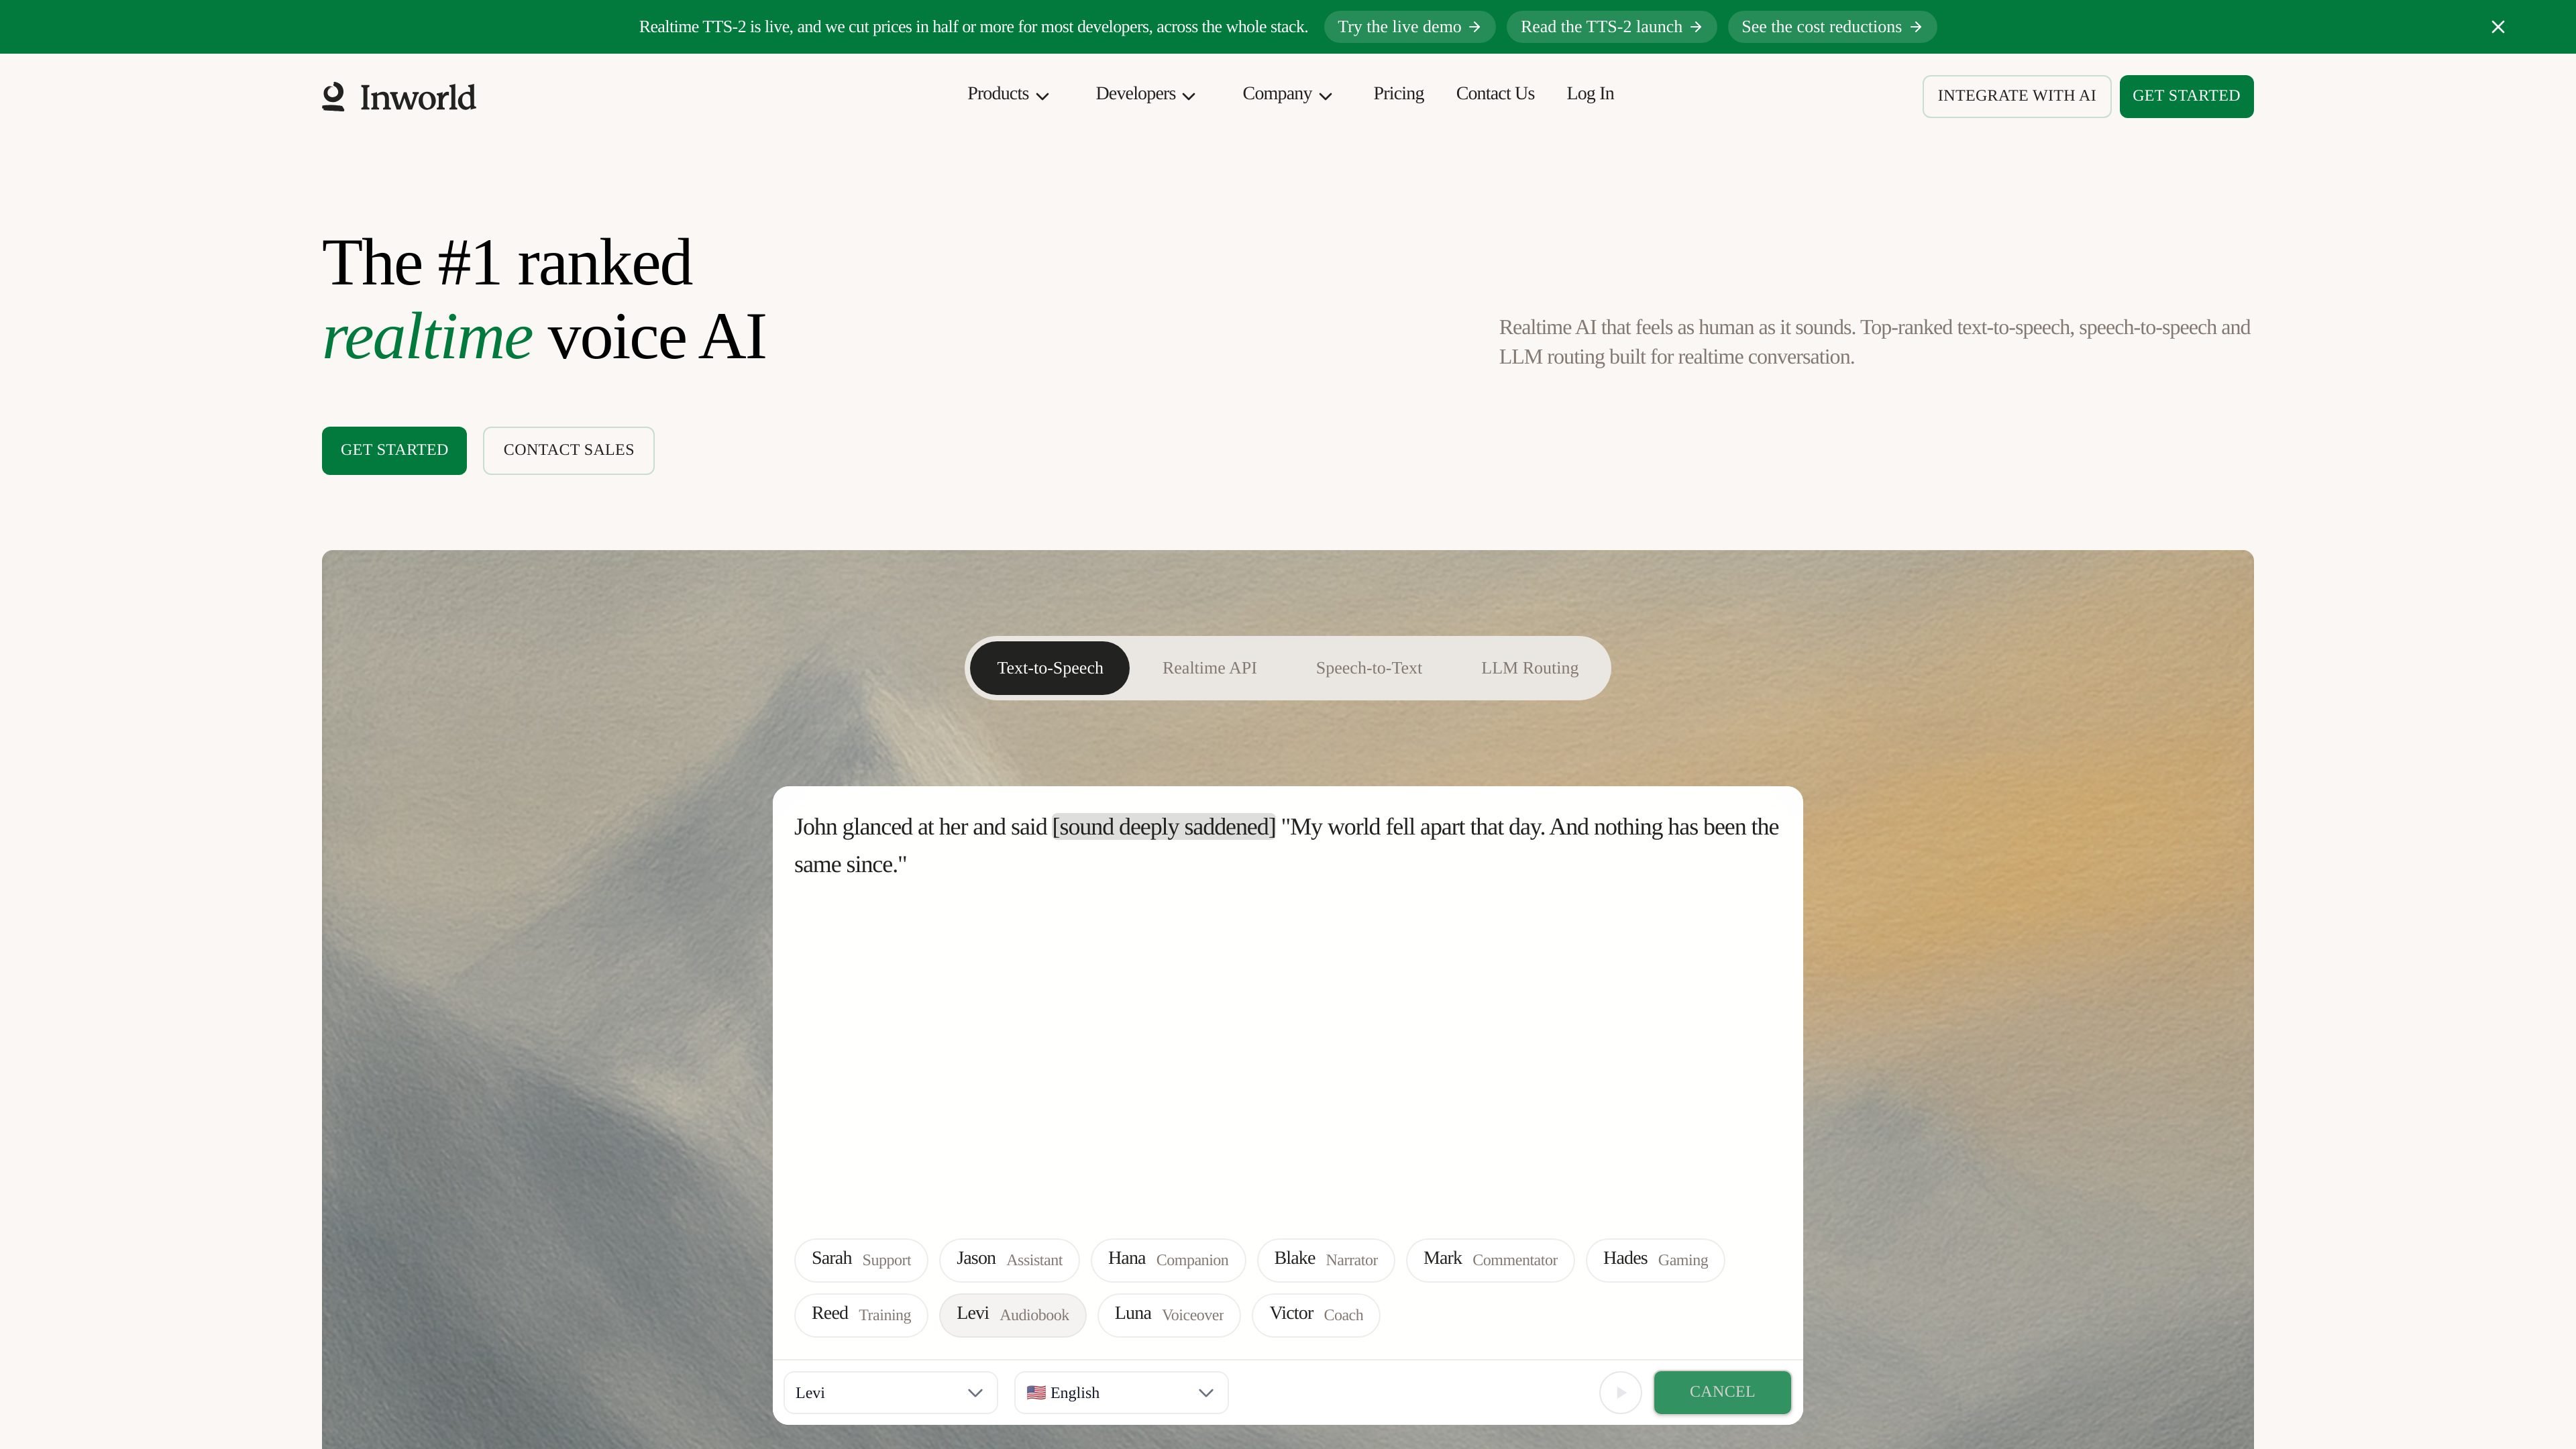
实时文本转语音
以流式方式输出生成的语音,并控制发音、时序和声音。TTS-2 支持在文本中插入声音表现指令,具体可用的控制功能取决于所选模型;宣传的延迟并不保证应用的端到端延迟。
Inworld AI 提供用于语音生成、语音转写、实时语音对话和语言模型路由的开发者 API。您可以单独使用各项服务,也可以在实时对话中结合语音输入、选定的语言模型和合成语音输出。该平台适用于语言练习、互动角色、陪伴应用和语音客服等应用场景。
首先创建 Inworld AI 账户,并参照相应的 Voice 或 Inference 快速入门指南,然后配置凭证、模型和应用行为。在生产环境中使用时,需要关注使用成本、请求和连接限制、允许的数据处理方式,以及生成回答的质量。语音合成和推断出的语音特征信号并不能证明回答或个人特征的准确性。
以流式方式输出生成的语音,并控制发音、时序和声音。TTS-2 支持在文本中插入声音表现指令,具体可用的控制功能取决于所选模型;宣传的延迟并不保证应用的端到端延迟。
通过双向 WebSocket 流式传输转写实时音频,或对文件使用同步转写。语音特征分析输出包括音高、风格、情绪、年龄和口音等推断信号;应将这些估计视为模型输出,而非经过核实的个人事实。
在实时会话中结合语音输入、语言模型和语音输出。实时控制功能包括轮次交替、工具调用、提供商选择和上下文管理;请针对目标客户端和工作流程进行配置与测试。
通过路由接口访问多个语言模型,并控制模型选择和回退行为。根据应用需求和提供商条款选择模型;统一接口并不意味着各模型的结果都同样准确。
根据参考音频创建声音,或用文字描述声音。请使用您已获得适当授权的声音和录音,并核实所选模型及套餐对声音克隆和语言的支持情况。
为语言学习应用添加口语练习和角色声音。应测试发音、支持的语言以及底层模型提供的教学回答,不应假定语音质量就能证明教学内容正确。
消费级应用可以将持久语音会话与选定的语言模型及合成声音结合,构建以语音为主的互动体验。
利用合适的声音控制功能和时序输出,生成角色对话和语音媒体内容。在集成播放功能前,请核实所选模型提供的时间戳格式,以及项目所需的声音使用授权。
结合实时转写、选定的 LLM 和合成语音回复,构建客服或电话智能体工作流程。在允许智能体代表用户执行操作前,请配置获准执行的工具操作、升级处理方式和回复检查。
应用团队可以在外部和托管的 LLM 之间路由请求,使模型选择符合特定用户交互或部署需求。
可以。Realtime API 在实时会话中将语音输入和输出与选定的语言模型结合。它提供轮次交替、工具调用、提供商和上下文控制功能。客户端连接和可用行为需要配置与测试。
创建 Inworld AI 平台账户,并按照开发者文档中的 Voice 或 Inference 快速入门指南操作。创建具备所需权限的凭证。不要将 API 密钥放入浏览器或移动客户端代码中;请使用后端或适当的短期客户端令牌。
不是。请核实所选模型对语言、声音克隆、时序和声音表现控制的支持情况。例如,价格表注明声音表现控制仅适用于 Realtime TTS-2。不要假定每个模型或套餐都提供相同的语音工作流程。
不是。情绪、年龄、口音、音高和风格信号都是模型推断的输出。使用前,请评估其适用性和相关数据使用权限,尤其是在错误推断可能影响个人的场景中。
付费套餐提供点数余额,并按套餐的计量费率扣除;LLM 使用量按提供商成本计费。限额和权益各不相同。按需使用(On-Demand)包含有限的免费评估额度,并非可持续无限使用的语音服务。请核实充值或自动充值设置,以及计费周期的相关条件。
不能。零数据保留和适用于受监管工作负载的选项被列为特定套餐的附加服务,而企业条款可能包含额外的数据区域和访问安排。发送敏感数据前,请确认所选协议及相关提供商的要求。
流量数据仅供参考。