2026 最佳大语言模型评测工具

发现大语言模型评测工具、基准测试与平台,衡量模型质量、对比输出、识别风险并持续改进 AI 应用。

AI 基础设施

探索此分类集合

产品

Arena preview
Arena logo

Arena

AI聊天机器人

公开的 AI 模型排行榜与对比平台,支持聊天、比较回答,并为文本、视觉、图像、视频、搜索和智能体任务投票。

免费及付费方案
Outlier AI preview
Outlier AI logo

Outlier AI

大语言模型评测

远程 AI 训练平台,连接专家参与灵活项目并按周获得报酬

免费及付费方案
Artificial Analysis preview
Artificial Analysis logo

Artificial Analysis

大语言模型评测

用于比较模型、提供商和硬件的 AI 基准测试与洞察平台,提供 Pro、Enterprise 计划及免费 API。

免费及付费方案
micro1 preview
micro1 logo

micro1

大语言模型评测

micro1 将领域专家与软件工作流结合,帮助 AI 实验室和企业团队制作训练数据集、评估模型与智能体表现,并针对任务失败制定改进数据。

免费及付费方案
Weights & Biases preview
Weights & Biases logo

Weights & Biases

AI 可观测性

用于实验跟踪、制品管理、GenAI 追踪与评估的机器学习和 AI 平台。

免费及付费方案
OpenTrain AI preview
OpenTrain AI logo

OpenTrain AI

大语言模型评测

OpenTrain AI 是一个市场与托管服务平台,可招聘经过预审的 AI 训练师、数据标注员和领域专家,用于 RLHF、评估、红队测试、标注及智能体工作流。

免费及付费方案
Horizon preview
Horizon logo

Horizon

大语言模型评测

Horizon 是 Labelbox 面向后训练与评估的强化学习环境产品,帮助 AI 团队构建软件环境、偏好信号和长时程任务评测标准。

免费及付费方案
Scale AI preview
Scale AI logo

Scale AI

大语言模型评测

为构建可靠生产级 AI 系统的团队提供数据、评测和企业级 AI 工具

Langfuse preview
Langfuse logo

Langfuse

AI 可观测性

开源 AI 工程平台,用于追踪、评估和改进 LLM 应用与智能体。

免费及付费方案
SuperAnnotate preview
SuperAnnotate logo

SuperAnnotate

大语言模型评测

面向图像、视频、文本和音频工作流的 AI 数据标注与评估管线平台。

免费及付费方案
Pydantic preview
Pydantic logo

Pydantic

AI 网关与路由

用于构建类型安全应用、观测 AI 系统、评估输出和路由模型访问的 AI 工程技术栈

免费及付费方案
Mindgard preview
Mindgard logo

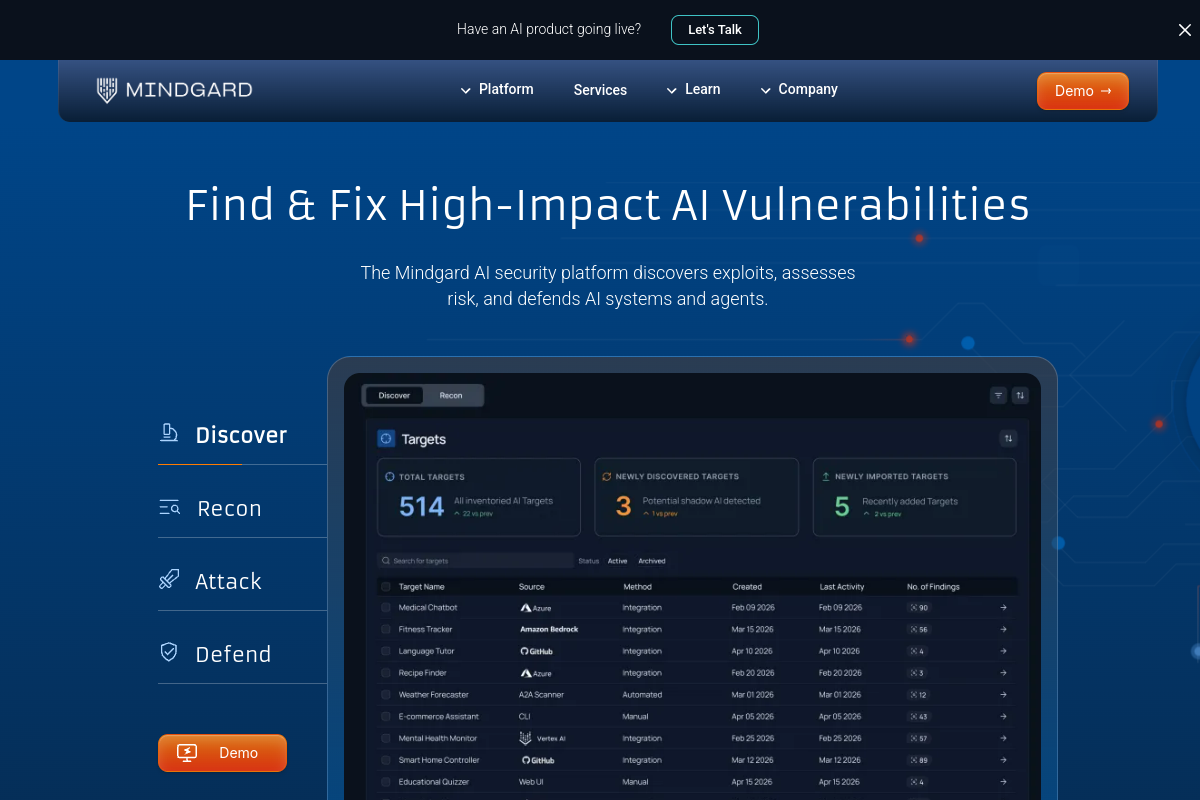
Mindgard

AI 测试助手

Mindgard 面向部署模型、智能体和 AI 应用的企业团队,帮助发现 AI 攻击面、执行对抗性安全测试,并定位可利用的安全弱点。

免费及付费方案
Future AGI preview
Future AGI logo

Future AGI

AI 可观测性

Future AGI 为开发和运营 AI 智能体的团队提供评测、模拟对话、运行时护栏和生产追踪工具,帮助定位故障并在发布前验证改动。

免费及付费方案
Evidently AI preview
Evidently AI logo

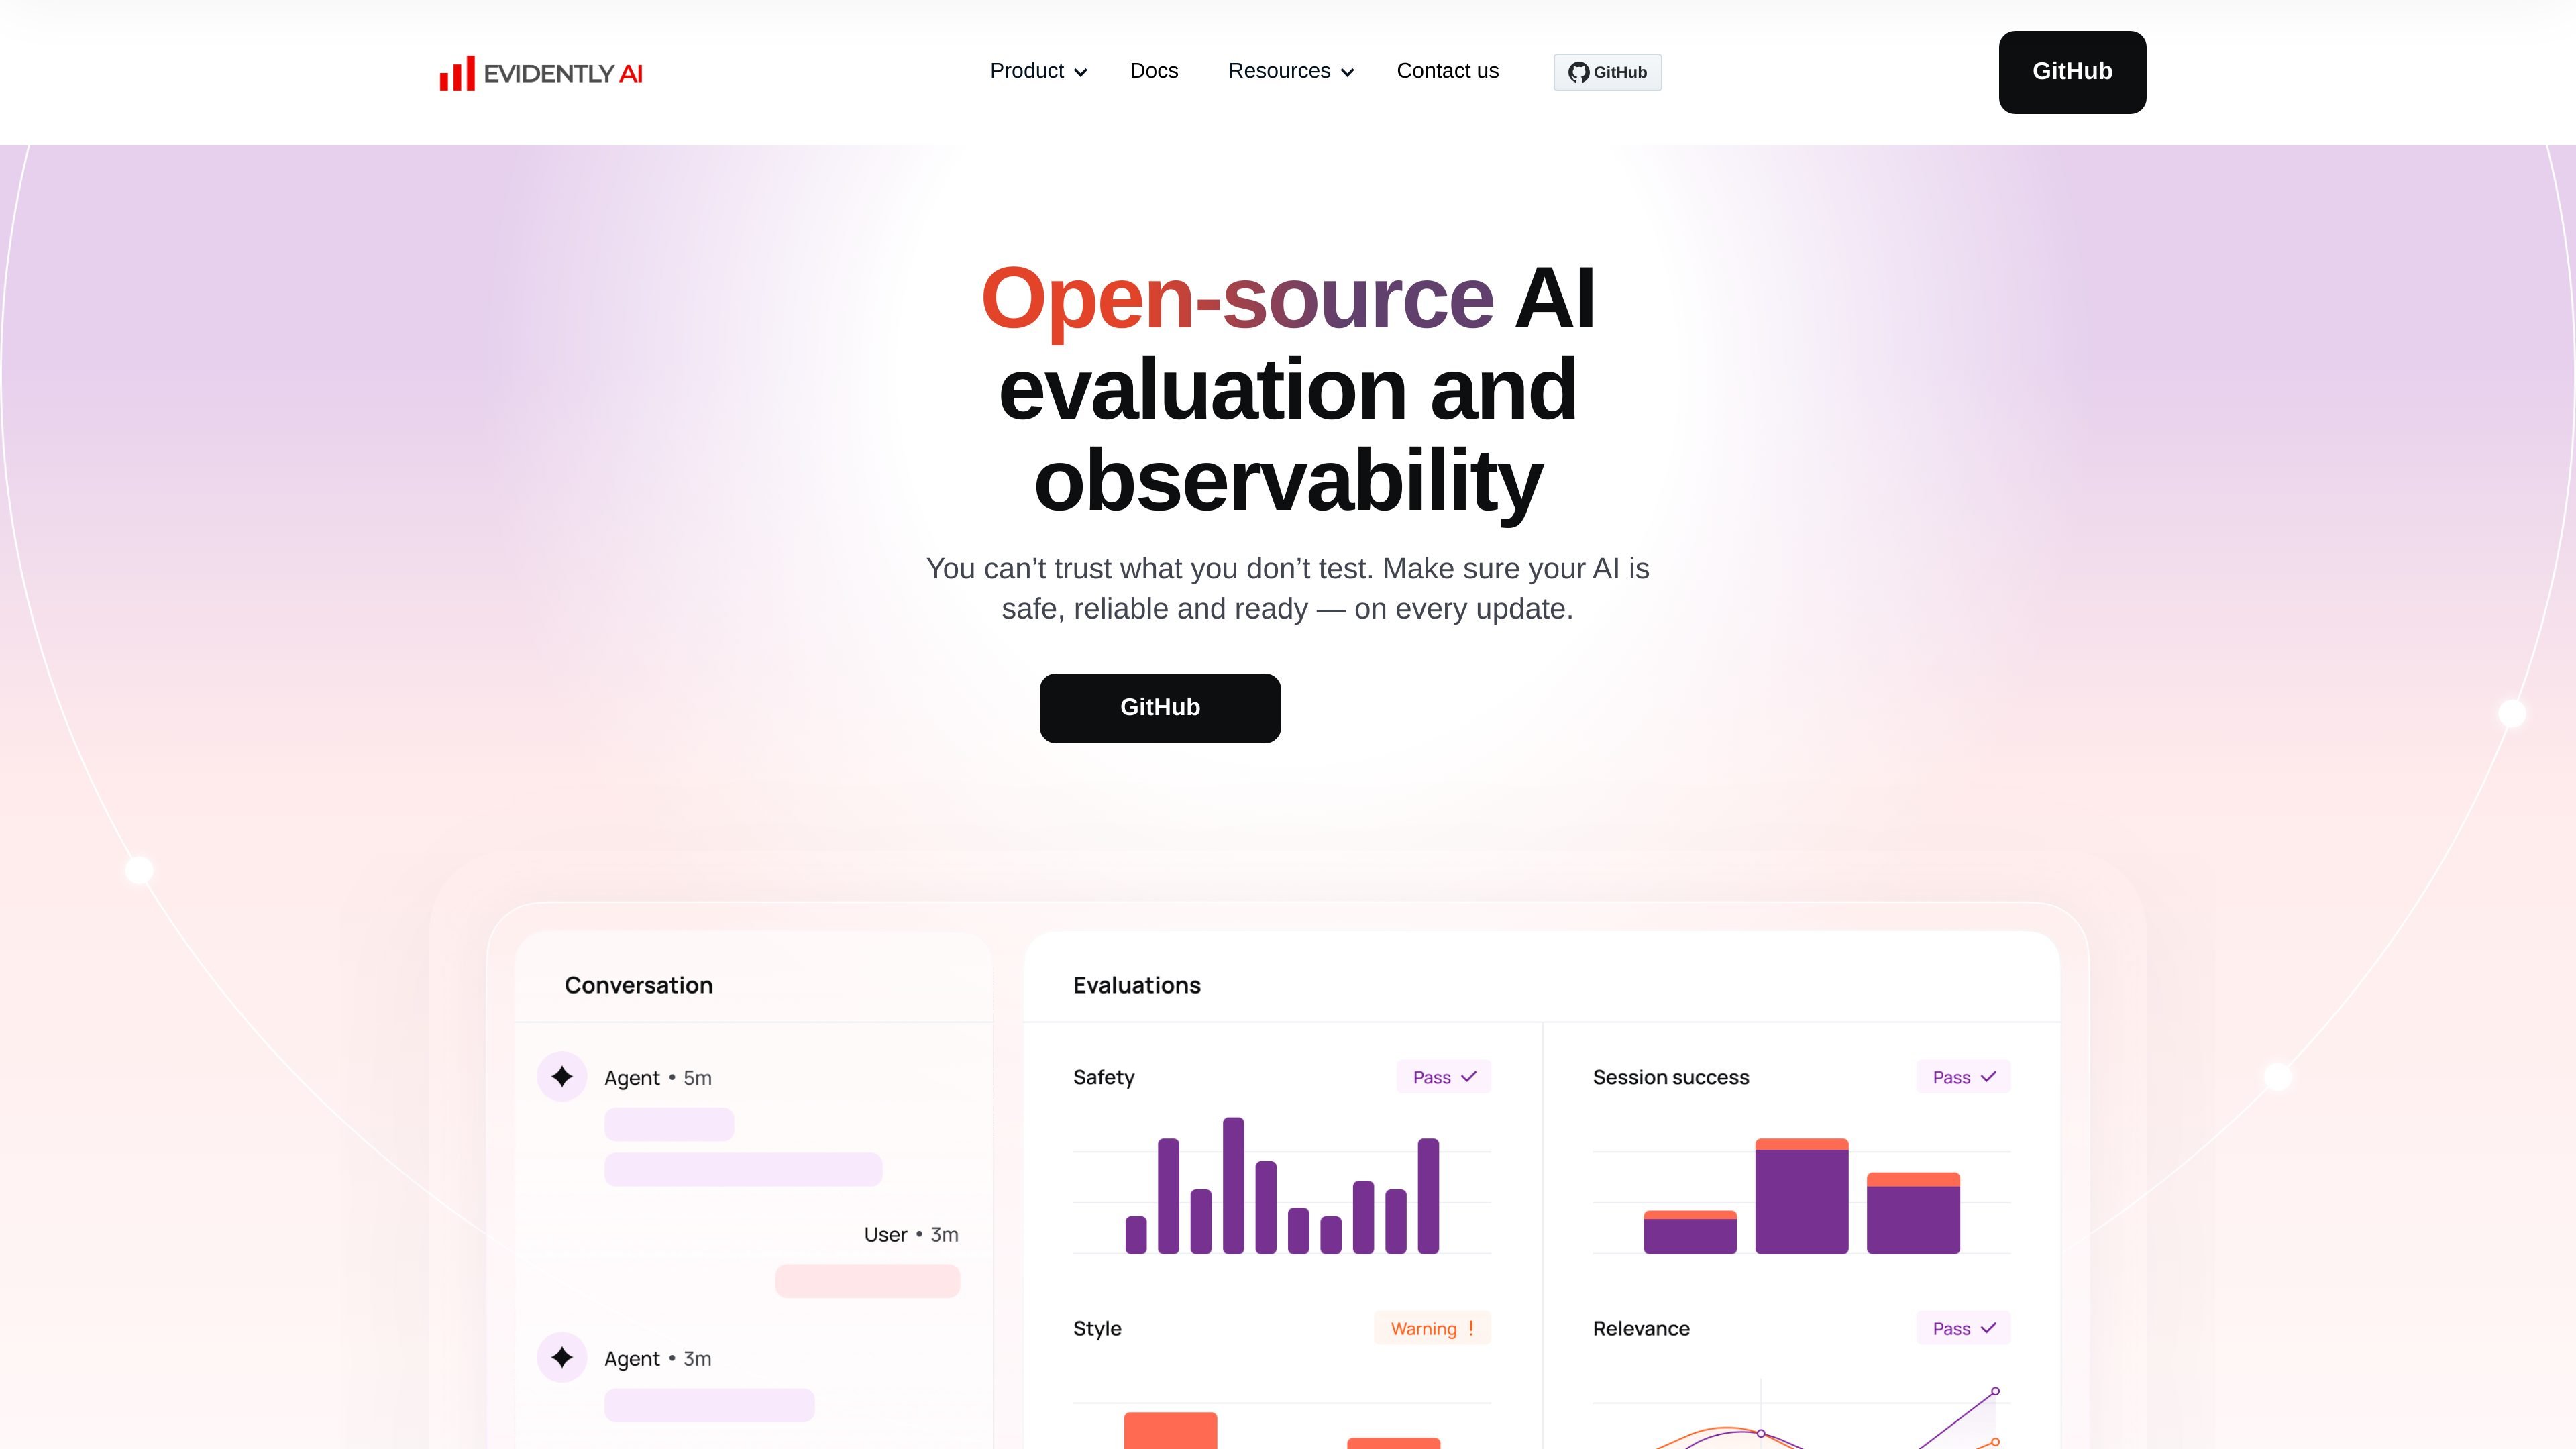
Evidently AI

AI 可观测性

Evidently AI 是一个开源框架,用于评估、测试和监控大语言模型应用、RAG 系统、AI 智能体及预测型机器学习模型。团队可结合内置指标与自定义规则检查输出质量、安全性和可靠性,并通过报告与监控视图跟踪部署后的变化。

免费及付费方案
Promptfoo preview
Promptfoo logo

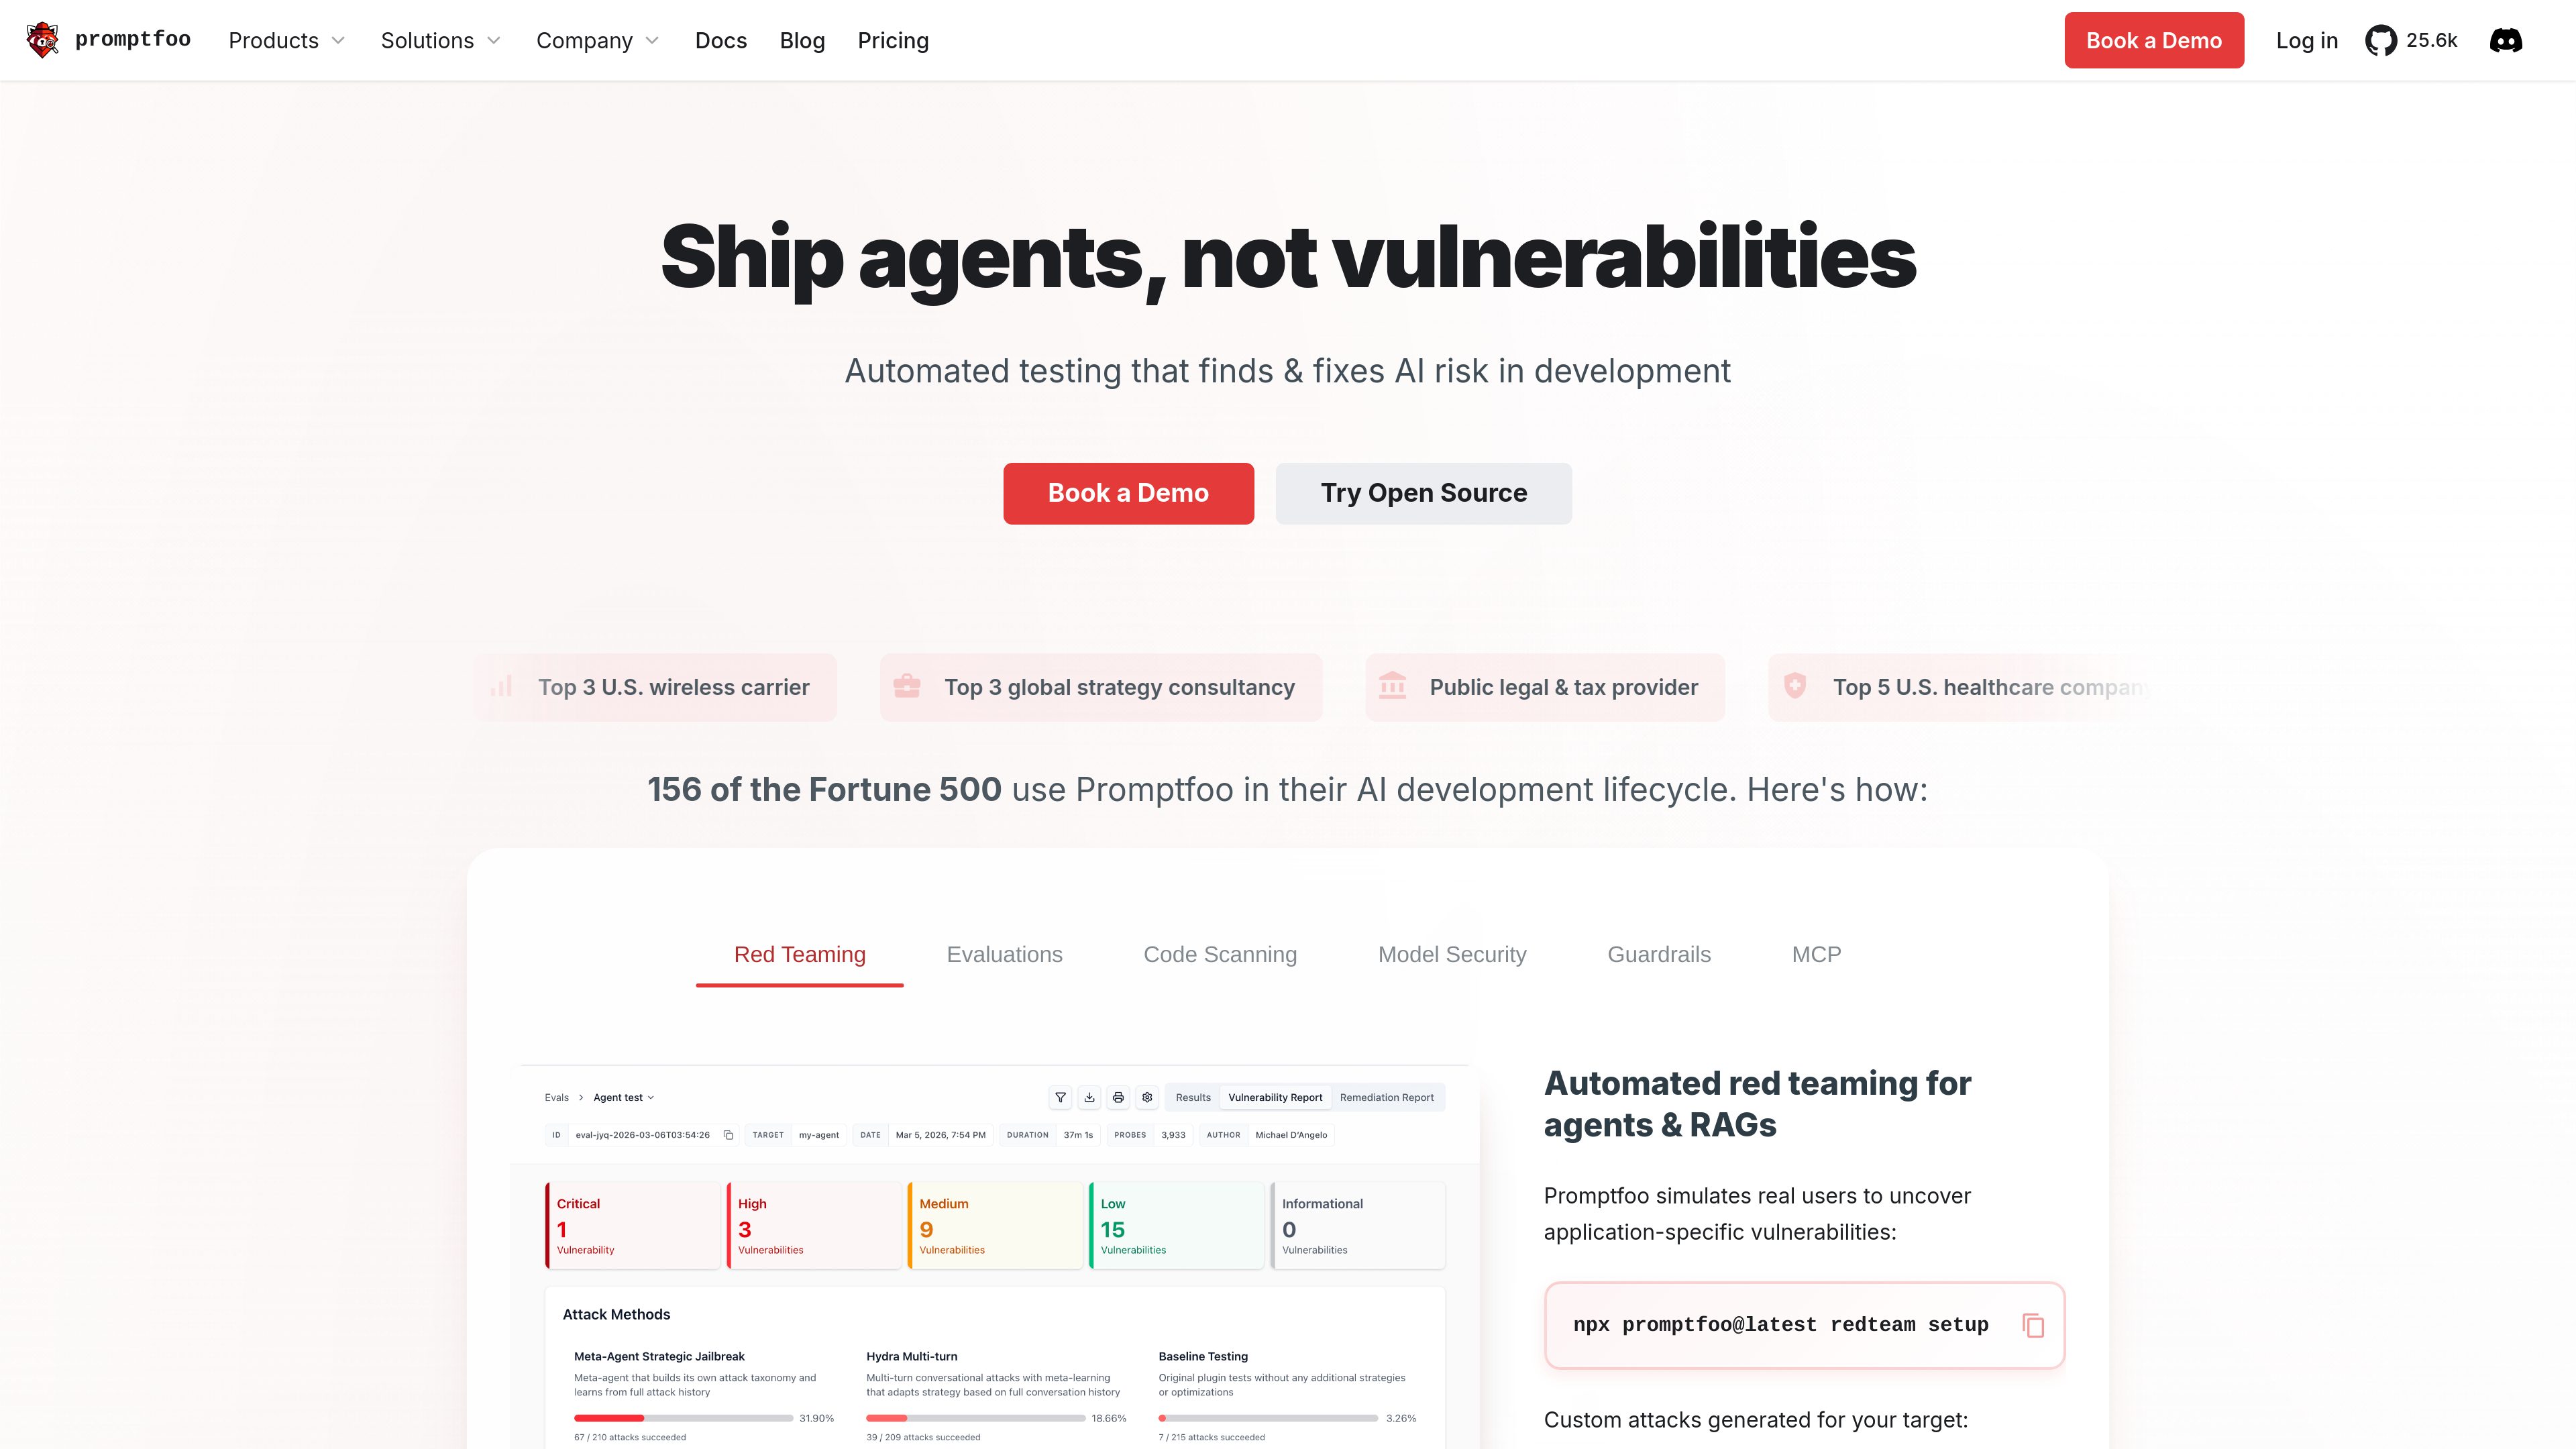
Promptfoo

AI 测试助手

Promptfoo 是一个用于评估大语言模型应用、智能体、模型及工作流的 AI 安全与测试平台,帮助开发者和安全团队发现漏洞、验证防护措施并跟踪修复。

免费及付费方案
Galileo preview
Galileo logo

Galileo

AI 可观测性

Galileo 是一个用于测试、调试和治理大语言模型及智能体系统的 AI 可观测性与评估平台,覆盖开发和生产环境,帮助团队将评估结果转化为生产防护措施,并规模化监控 AI 行为。

免费及付费方案
DeepEval preview
DeepEval logo

DeepEval

AI 测试助手

DeepEval 是一个开源的大语言模型评测框架,用于测试和基准评估 AI 应用,支持基于 pytest 的评测、输出与智能体轨迹评分,以及文本、图像、音频和语音工作流迭代。

免费及付费方案
huntr preview
huntr logo

huntr

大语言模型评测

huntr 面向 AI 安全研究者和黑客,提供限时挑战,用于测试 AI 防御、完成指定目标,并通过排行榜争夺现金奖励。

免费及付费方案
Context preview
Context logo

Context

AI 智能体构建工具

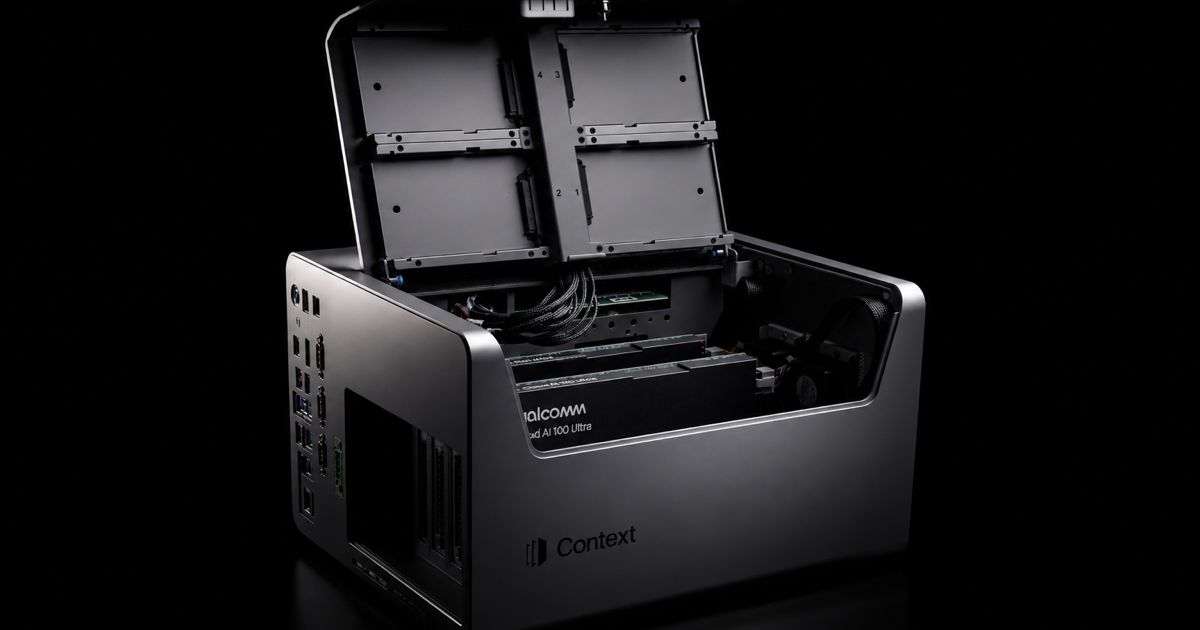
面向企业的 AI 智能体平台,可在客户基础设施上构建、部署和持续改进智能体,整合工作区、运行时、上下文与评估工具,并通过受权限控制的连接器和基于身份提供商的访问控制保障安全。

免费及付费方案
Giskard preview
Giskard logo

Giskard

AI 测试助手

Giskard 面向负责 AI 系统可靠性的团队,可通过 API 对话式大语言模型智能体进行黑盒测试,覆盖上线前评估与上线后的持续安全和质量检查。

免费及付费方案

常见问题

大语言模型评测主要解决什么问题?

发现大语言模型评测工具、基准测试与平台,衡量模型质量、对比输出、识别风险并持续改进 AI 应用。

接口协议兼容,就能直接替换现有供应商吗?

还要实测工具调用、流式输出、错误格式、上下文限制和多模态输入。模型名称相同也不代表路由和计费一致。先回放一组真实请求,记录输出差异与失败情况,再逐步切换流量。

模型单价低,为什么总成本反而可能更高?

总成本还受缓存、输出长度、重试、并发限制和延迟影响。自托管也要考虑显存、空闲资源与维护。使用自己的请求分布测算每个成功任务的花费,比只比较标价更接近实际。

上线前应该怎样测试稳定性和数据边界?

覆盖超时、限流、上游故障和密钥轮换,确认重试不会重复执行有副作用的操作。核对数据保存地区、日志脱敏和供应商保留政策,并为回退、预算告警和访问审计留好入口。