
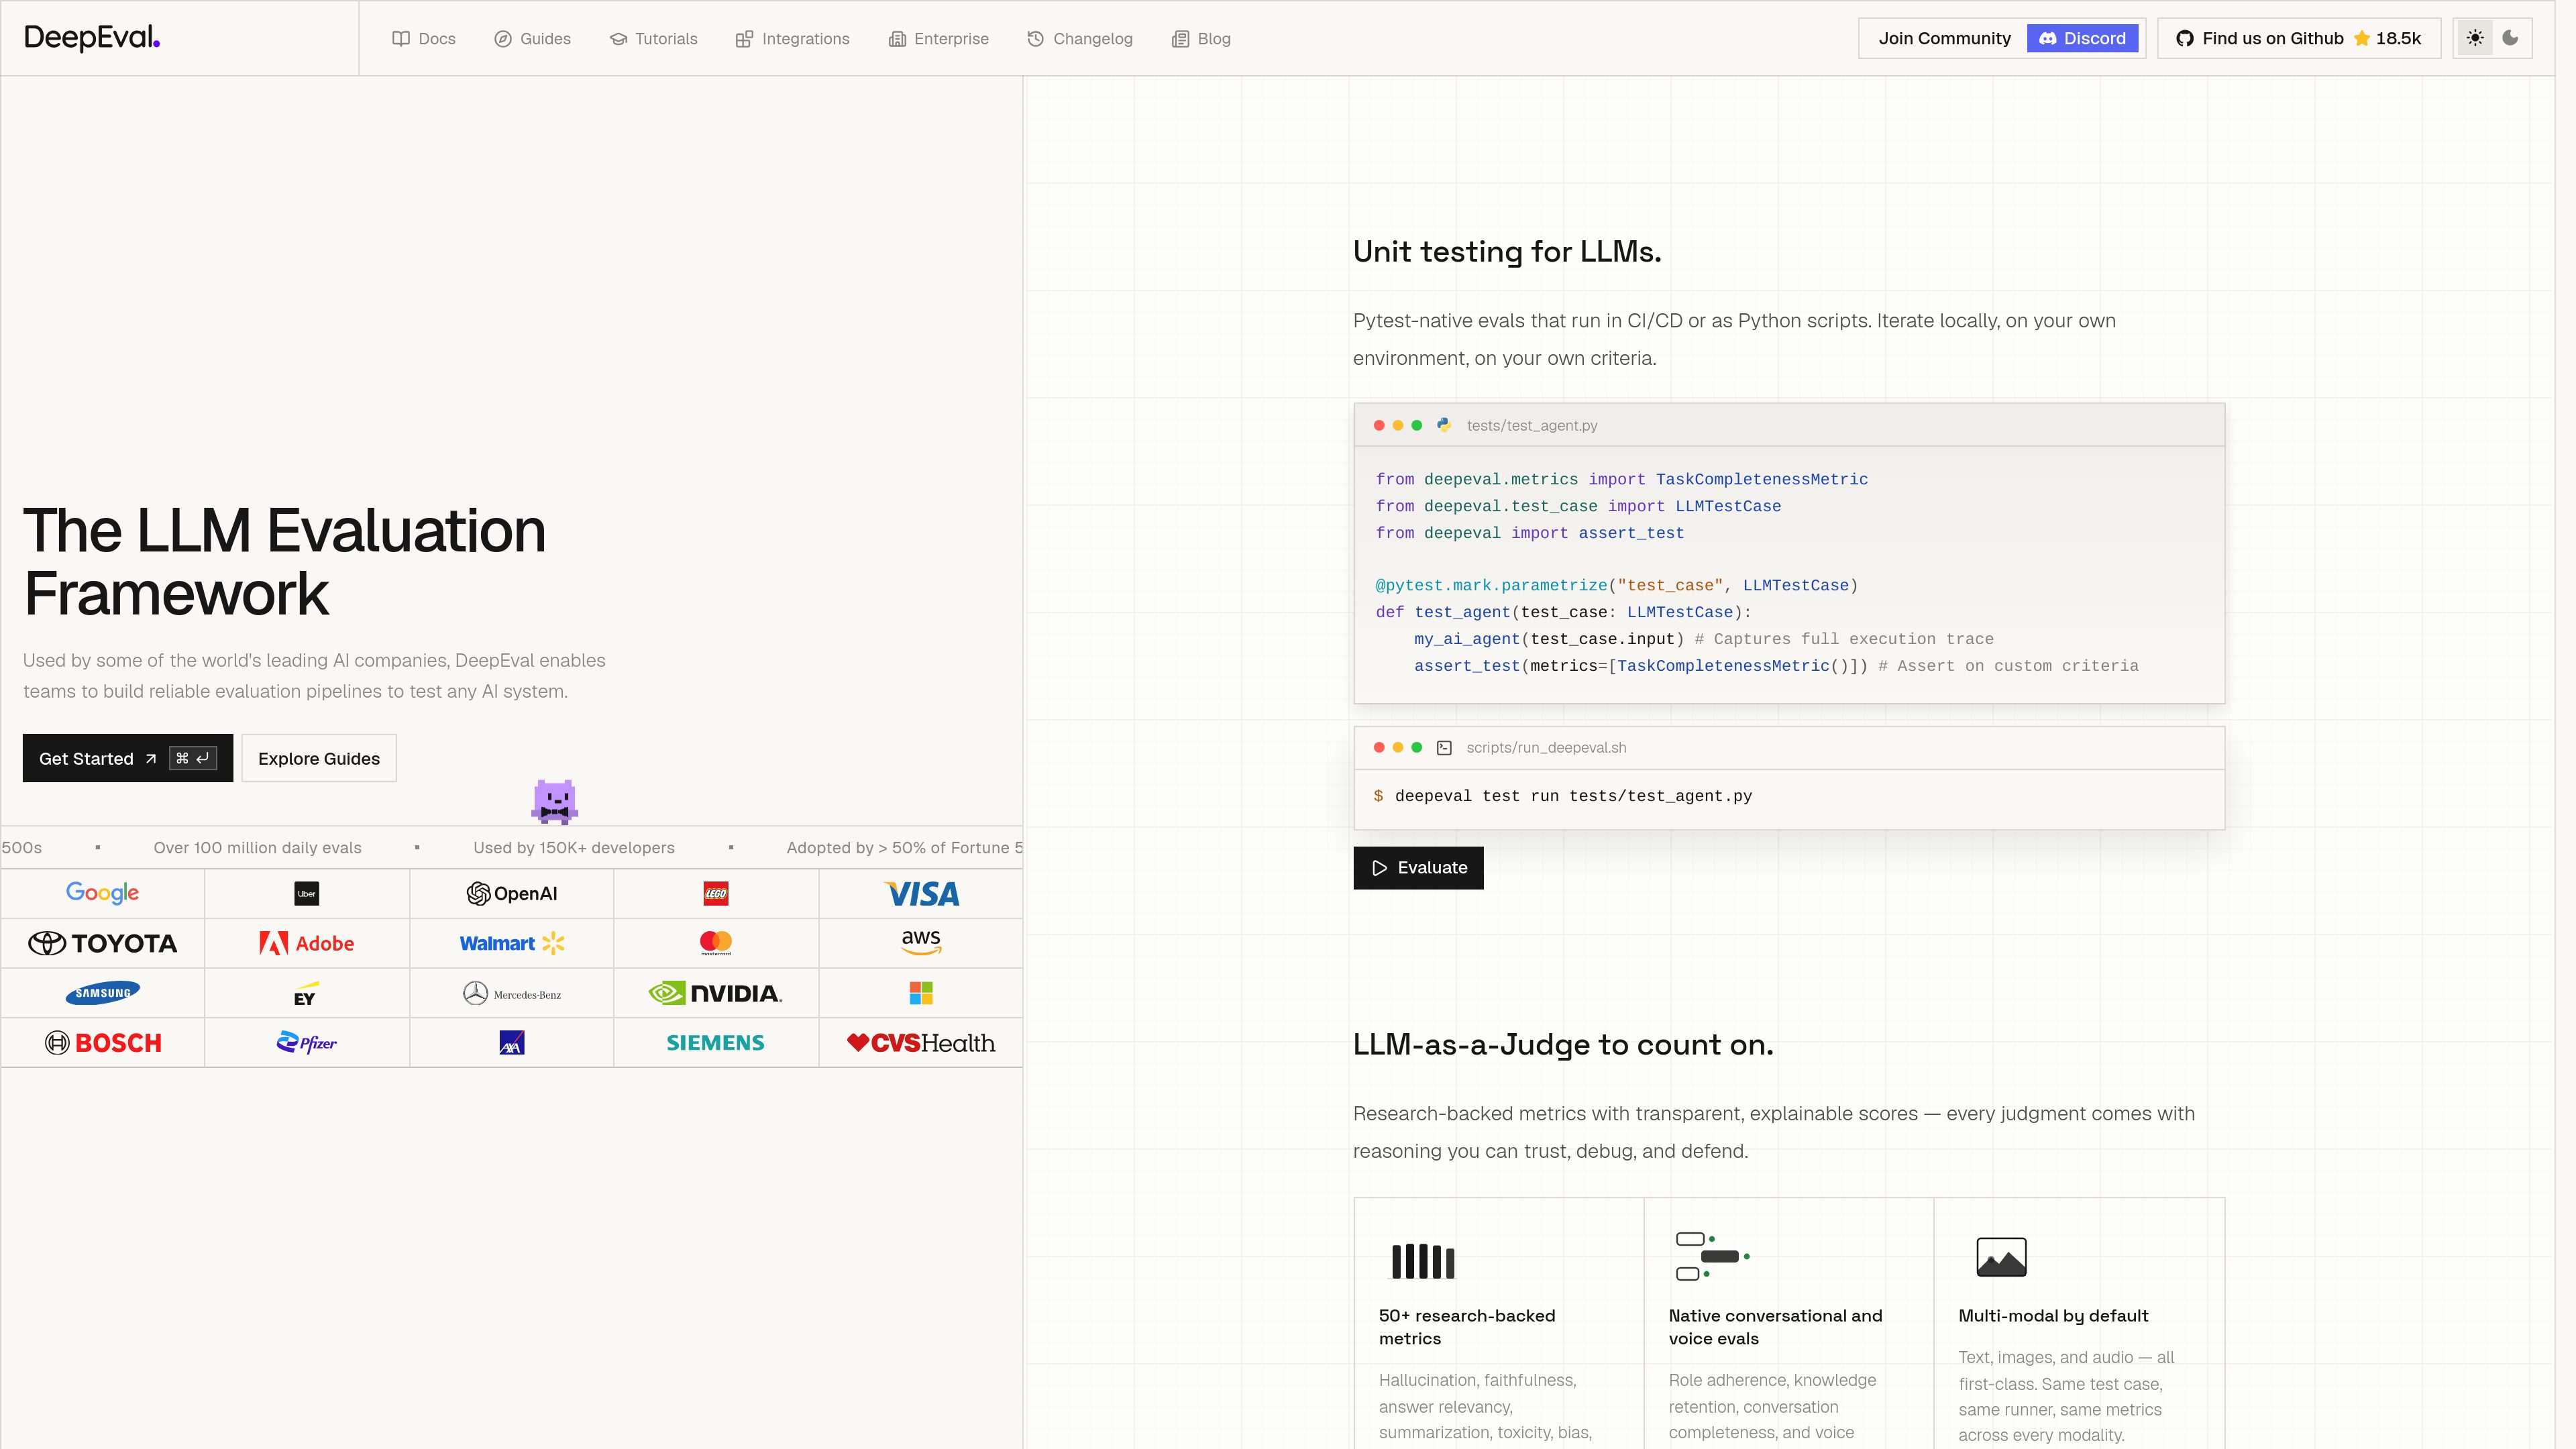
基于 pytest 的评测
将 LLM 测试编写为 Python 测试,可在本地或 CI/CD 中运行,并通过 `deepeval` CLI 调用。

DeepEval 是一个开源的大语言模型评测框架,用于测试和基准评估 AI 应用,支持基于 pytest 的评测、输出与智能体轨迹评分,以及文本、图像、音频和语音工作流迭代。
DeepEval 是一个开源的大语言模型评测框架,用于评测 LLM 应用。它提供基于 pytest 的测试和基于 Python 的评测流程,可在本地、CI/CD 中运行,也可通过 deepeval CLI 调用。团队可以使用可配置的指标和测试用例,评测黑盒输出、完整的智能体轨迹以及单个组件的决策。
该框架提供 50 多个开箱即用的指标,涵盖幻觉、忠实性、答案相关性、摘要、毒性、偏见、智能体任务完成度、工具正确性、检索质量和多轮对话行为等领域。指标通常会返回 0 到 1 之间的分数及评分理由;当测试分数达到配置的阈值时,测试即通过。DeepEval 还支持通过 G-Eval、JevEval、DAG 指标和自定义代码指标等技术定义自定义标准。
DeepEval 在同一评测模型中支持文本、图像和音频。它可以跟踪智能体执行过程,让团队检查并评估有序的步骤、工具、检索器和模型调用。该框架还提供面向智能体框架、模型提供商、语音系统、向量数据库和常见 CI/CD 平台的集成。对于共享报告和更广泛的评测运营,DeepEval 可连接 Confident AI 平台。
将 LLM 测试编写为 Python 测试,可在本地或 CI/CD 中运行,并通过 `deepeval` CLI 调用。
使用适用于智能体、RAG、聊天机器人、安全性、多模态评测、幻觉、JSON 正确性、摘要及相关标准的现成指标。
捕获有序的智能体执行过程,并评估完整轨迹或工具选择、参数构造等单个操作。
使用 G-Eval 定义自然语言标准,或使用 JevEval 定义有界问题;还可构建条件 DAG 指标或实现自定义代码指标。
从知识库文件等来源生成合成黄金测试用例,并在部署前基于不同用户角色模拟对话。
可连接 LangChain、LlamaIndex、CrewAI、LangGraph、OpenAI Agents、Pydantic AI 等框架;同时也记录了模型提供商、语音、向量数据库和 CI/CD 集成。
将评测用例加入 Python 测试套件,并在 CI/CD 工作流中重新运行,以便在发布变更前发现质量回归。
检查完整的智能体轨迹,然后评估规划、任务完成度、步骤效率、工具正确性或工具参数,以定位失败的操作。
将检索器上下文的相关性、精确率和召回率,与生成器答案的相关性和忠实性分开评估。
评估知识保持、角色遵循、对话完整性和相关性等多轮行为;语音工作流可使用语音和语音智能体集成。
从文档生成黄金测试用例,或在尚无人工标注数据集时模拟用户对话和边界情况。
它主要是一个代码优先的评测框架。测试可以在 Python 中、通过 pytest 或使用 `deepeval` CLI 运行;结果也可以发送到 Confident AI,以生成共享报告并支持更广泛的评测工作流。
文档中的指标和工作流涵盖 LLM 应用、AI 智能体、RAG 系统、聊天机器人、多模态应用和语音智能体。评测对象可以是最终输出、完整轨迹或单个组件。
大多数指标会生成 0 到 1 之间的分数,并包含评分理由。当指标分数达到配置的阈值时,即表示评测成功;根据指标文档,默认阈值为 0.5。
可以。DeepEval 支持通过 G-Eval、JevEval、DAG 指标和完全自定义代码指标定义评测标准,也包括基于 BLEU 或 ROUGE 等度量的指标。
目前提供的定价 URL 返回 404 页面,因此无法根据现有资料确认价格、方案限制和商业条款。该框架本身被描述为开源软件。