
自然语言数据发现
使用自然语言搜索数据集、指标、仪表板、表和列,而无需知道精确的技术名称。

CastorDoc Catalog 是一款数据目录与治理产品,帮助团队发现、理解并信任其数据资产。它结合自然语言搜索、血缘、文档和自助分析集成。
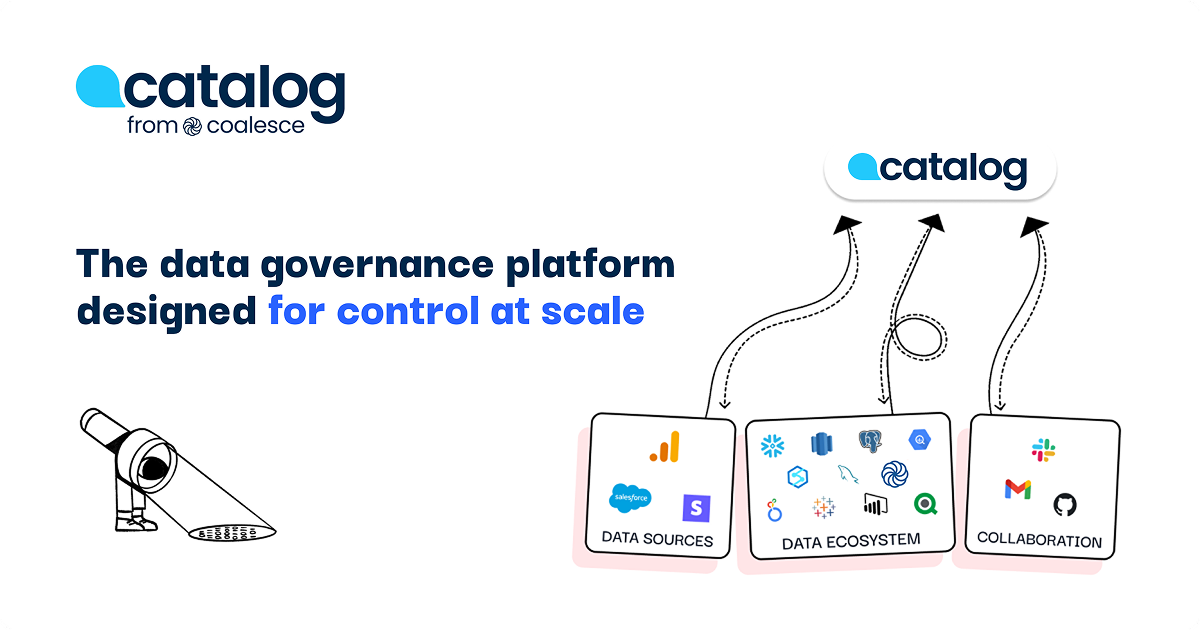
CastorDoc Catalog 是一款数据目录与治理产品,旨在帮助团队查找、理解并使用其数据资产。该网站将其描述为一款由数据治理驱动的 AI 助手,结合了搜索、文档、血缘以及面向自助分析的辅助功能。
其核心作用是在企业技术栈中提升数据的可发现性,并让人们更容易信任数据。产品页面强调基于自然语言的发现、从已连接工具自动生成文档、列级血缘,以及用于安全、合规和访问管理的控制。
使用自然语言搜索数据集、指标、仪表板、表和列,而无需知道精确的技术名称。
使用 AI 驱动的信任检查来评估可靠性、质量和使用热度,帮助团队判断某项资产是否适合使用。
映射数据在数据源、管道和 BI 工具之间的流转路径,并在可用时提供列级血缘。
通过从数据技术栈中摄取元数据并在已连接工具之间传播文档,实现目录文档自动化。
将自然语言问题转换为 SQL,帮助用户构造查询并减少手动编写查询的工作量。
连接 Slack、Gmail、Okta 和 Google SSO 等治理、协作与安全工具,以适配现有工作流。
数据分析师或业务用户可以使用自然语言搜索合适的表、指标或仪表板,然后直接使用发现的资产,而不必每次都依赖数据团队来查找。
数据平台或治理团队可以集中管理文档、血缘和信任信号,让利益相关方了解数据是如何生成的,以及其是否足够可靠可用。
分析团队可以跨数据源和 BI 工具追踪列级血缘,在更改管道或模型之前了解下游影响。
组织可以连接现有的数据仓库、BI 工具、转换工具、通知工具和身份提供商,使目录融入当前工作流,而不是独立于这些工作流之外。
经常收到有关定义或资产归属的临时问题的团队,可以使用目录和文档功能减少反复沟通,让答案更容易找到。
Catalog 是一款数据目录与治理产品,帮助团队在其技术栈中查找、理解并使用数据资产。该网站将其定位为一款由数据治理驱动的 AI 助手,具备数据发现、文档、血缘和自然语言访问等功能。
来源页面显示 Catalog 可在数据仓库和数据库、数据可视化工具、数据质量与转换工具、协作与通知工具以及安全工具之间运行。集成页面列举了 Snowflake、BigQuery、Redshift、Databricks、Tableau、Power BI、dbt、Fivetran、Slack、Okta 和 Google SSO 等示例。
该产品旨在从已连接工具摄取元数据,自动化文档,呈现血缘,并支持自然语言搜索和 SQL 辅助。网站还表示,团队可以通过来自多种工具的传播式文档,在几秒内为多达 90% 的数据库完成文档化。
所提供的定价页面内容未显示实际价格或方案层级。现有页面更多指向 request-pricing 和 request-demo 流程,而不是公开费率。
该网站面向希望实现自助分析、同时不放弃数据治理、安全和合规控制的团队。它似乎最适合数据团队、治理团队以及需要发现并信任数据资产的业务用户。