
自然言語によるデータ探索
正確な技術名を知らなくても、平易な言葉でデータセット、指標、ダッシュボード、テーブル、カラムを検索できます。

CastorDoc Catalogは、データ資産の発見、理解、信頼を支援するデータカタログ兼ガバナンス製品です。自然言語検索、リネージ、ドキュメント、セルフサービス分析向け連携を備えています。
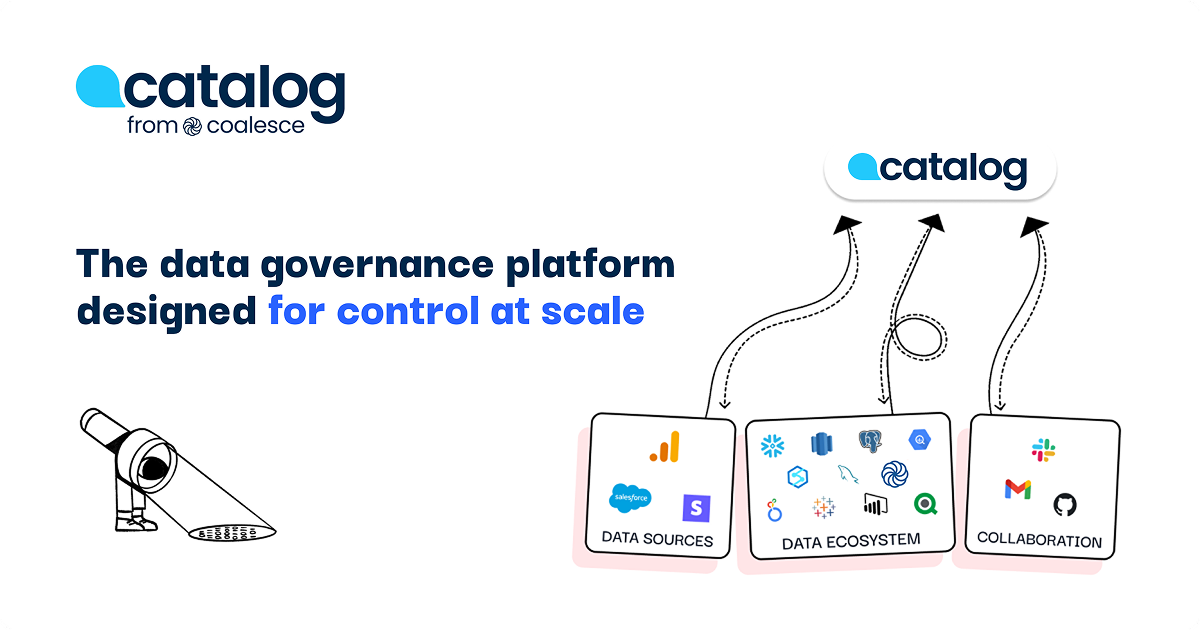
CastorDoc Catalogは、チームがデータ資産を見つけ、理解し、活用できるよう支援するデータカタログ兼ガバナンス製品です。サイトでは、データガバナンスによって支えられたAIアシスタントとして説明されており、検索、ドキュメント、リネージ、セルフサービス分析向けの支援を組み合わせています。
その中核的な役割は、組織の技術基盤全体でデータの発見しやすさと信頼性を高めることです。製品ページでは、平易な言葉による探索、接続済みツールからの自動ドキュメント生成、カラムレベルのリネージ、セキュリティ、コンプライアンス、アクセス管理のための制御が強調されています。
正確な技術名を知らなくても、平易な言葉でデータセット、指標、ダッシュボード、テーブル、カラムを検索できます。
AI主導の信頼チェックを使って、信頼性、品質、利用 জনপ্রול動向を評価し、資産が利用に適しているかを判断できます。
ソース、パイプライン、BIツールをまたいだデータの流れを把握でき、利用可能な場合はカラムレベルのリネージも確認できます。
データスタックからメタデータを取り込み、接続されたツール間でドキュメントを伝播させることで、カタログのドキュメント生成を自動化します。
自然言語の質問をSQLに変換し、ユーザーがクエリを作成しやすくし、手動でのクエリ作成の手間を減らします。
Slack、Gmail、Okta、Google SSOなどのガバナンス、コラボレーション、セキュリティツールを接続して、既存のワークフローに組み込めます。
データアナリストやビジネスユーザーは、平易な言葉で適切なテーブル、指標、ダッシュボードを検索し、見つけた資産を都度データチームに頼ることなく活用できます。
データプラットフォームチームやガバナンスチームは、ドキュメント、リネージ、信頼シグナルを一元化し、関係者がデータの作成経緯や利用可能な信頼性を理解できるようにできます。
分析チームはカラムレベルのリネージをソースやBIツールをまたいで追跡し、パイプラインやモデルを変更する前に下流への影響を把握できます。
組織は既存のウェアハウス、BIツール、変換ツール、通知ツール、IDプロバイダーを接続して、カタログを単独で並べるのではなく、現在のワークフローに組み込めます。
定義や資産の所有者に関する臨時の質問を頻繁に受けるチームは、カタログとドキュメント機能を使ってやり取りの繰り返しを減らし、答えを見つけやすくできます。
Catalogは、チームがスタック全体のデータ資産を見つけ、理解し、活用できるよう支援するデータカタログ兼ガバナンス製品です。サイトでは、データガバナンスによって支えられたAIアシスタントとして位置付けられており、データ探索、ドキュメント、リネージ、自然言語アクセスの機能を備えています。
ソースページでは、Catalogがデータウェアハウスやデータベース、データ可視化ツール、データ品質・変換ツール、コラボレーション・通知ツール、セキュリティツール全体で動作することが示されています。連携ページには、Snowflake、BigQuery、Redshift、Databricks、Tableau、Power BI、dbt、Fivetran、Slack、Okta、Google SSOなどの例が掲載されています。
この製品は、接続済みツールからメタデータを取り込み、ドキュメント生成を自動化し、リネージを表示し、自然言語検索とSQL支援をサポートするよう設計されています。サイトでは、複数のツールから伝播したドキュメントにより、データベースの最大90%を数秒でドキュメント化できるとも説明されています。
提供された価格ページの内容には、実際の価格やプランの階層は表示されていません。利用可能なページは、料金を公開する代わりに見積依頼やデモ依頼の導線を案内しています。
このサイトは、データガバナンス、セキュリティ、コンプライアンスを維持しながらセルフサービス分析を実現したいチームを対象にしています。データチーム、ガバナンスチーム、データ資産を見つけて信頼したいビジネスユーザーに特に適しているようです。