
一键安装
首页展示了使用 shell 安装程序的一行安装流程,使本地使用的设置保持简单。
BaseRT 是适用于 Apple Silicon 的本地 LLM 运行时,可一键安装,在本机部署并运行支持的模型,还能连接编码代理,无需向外部 API 发送数据。
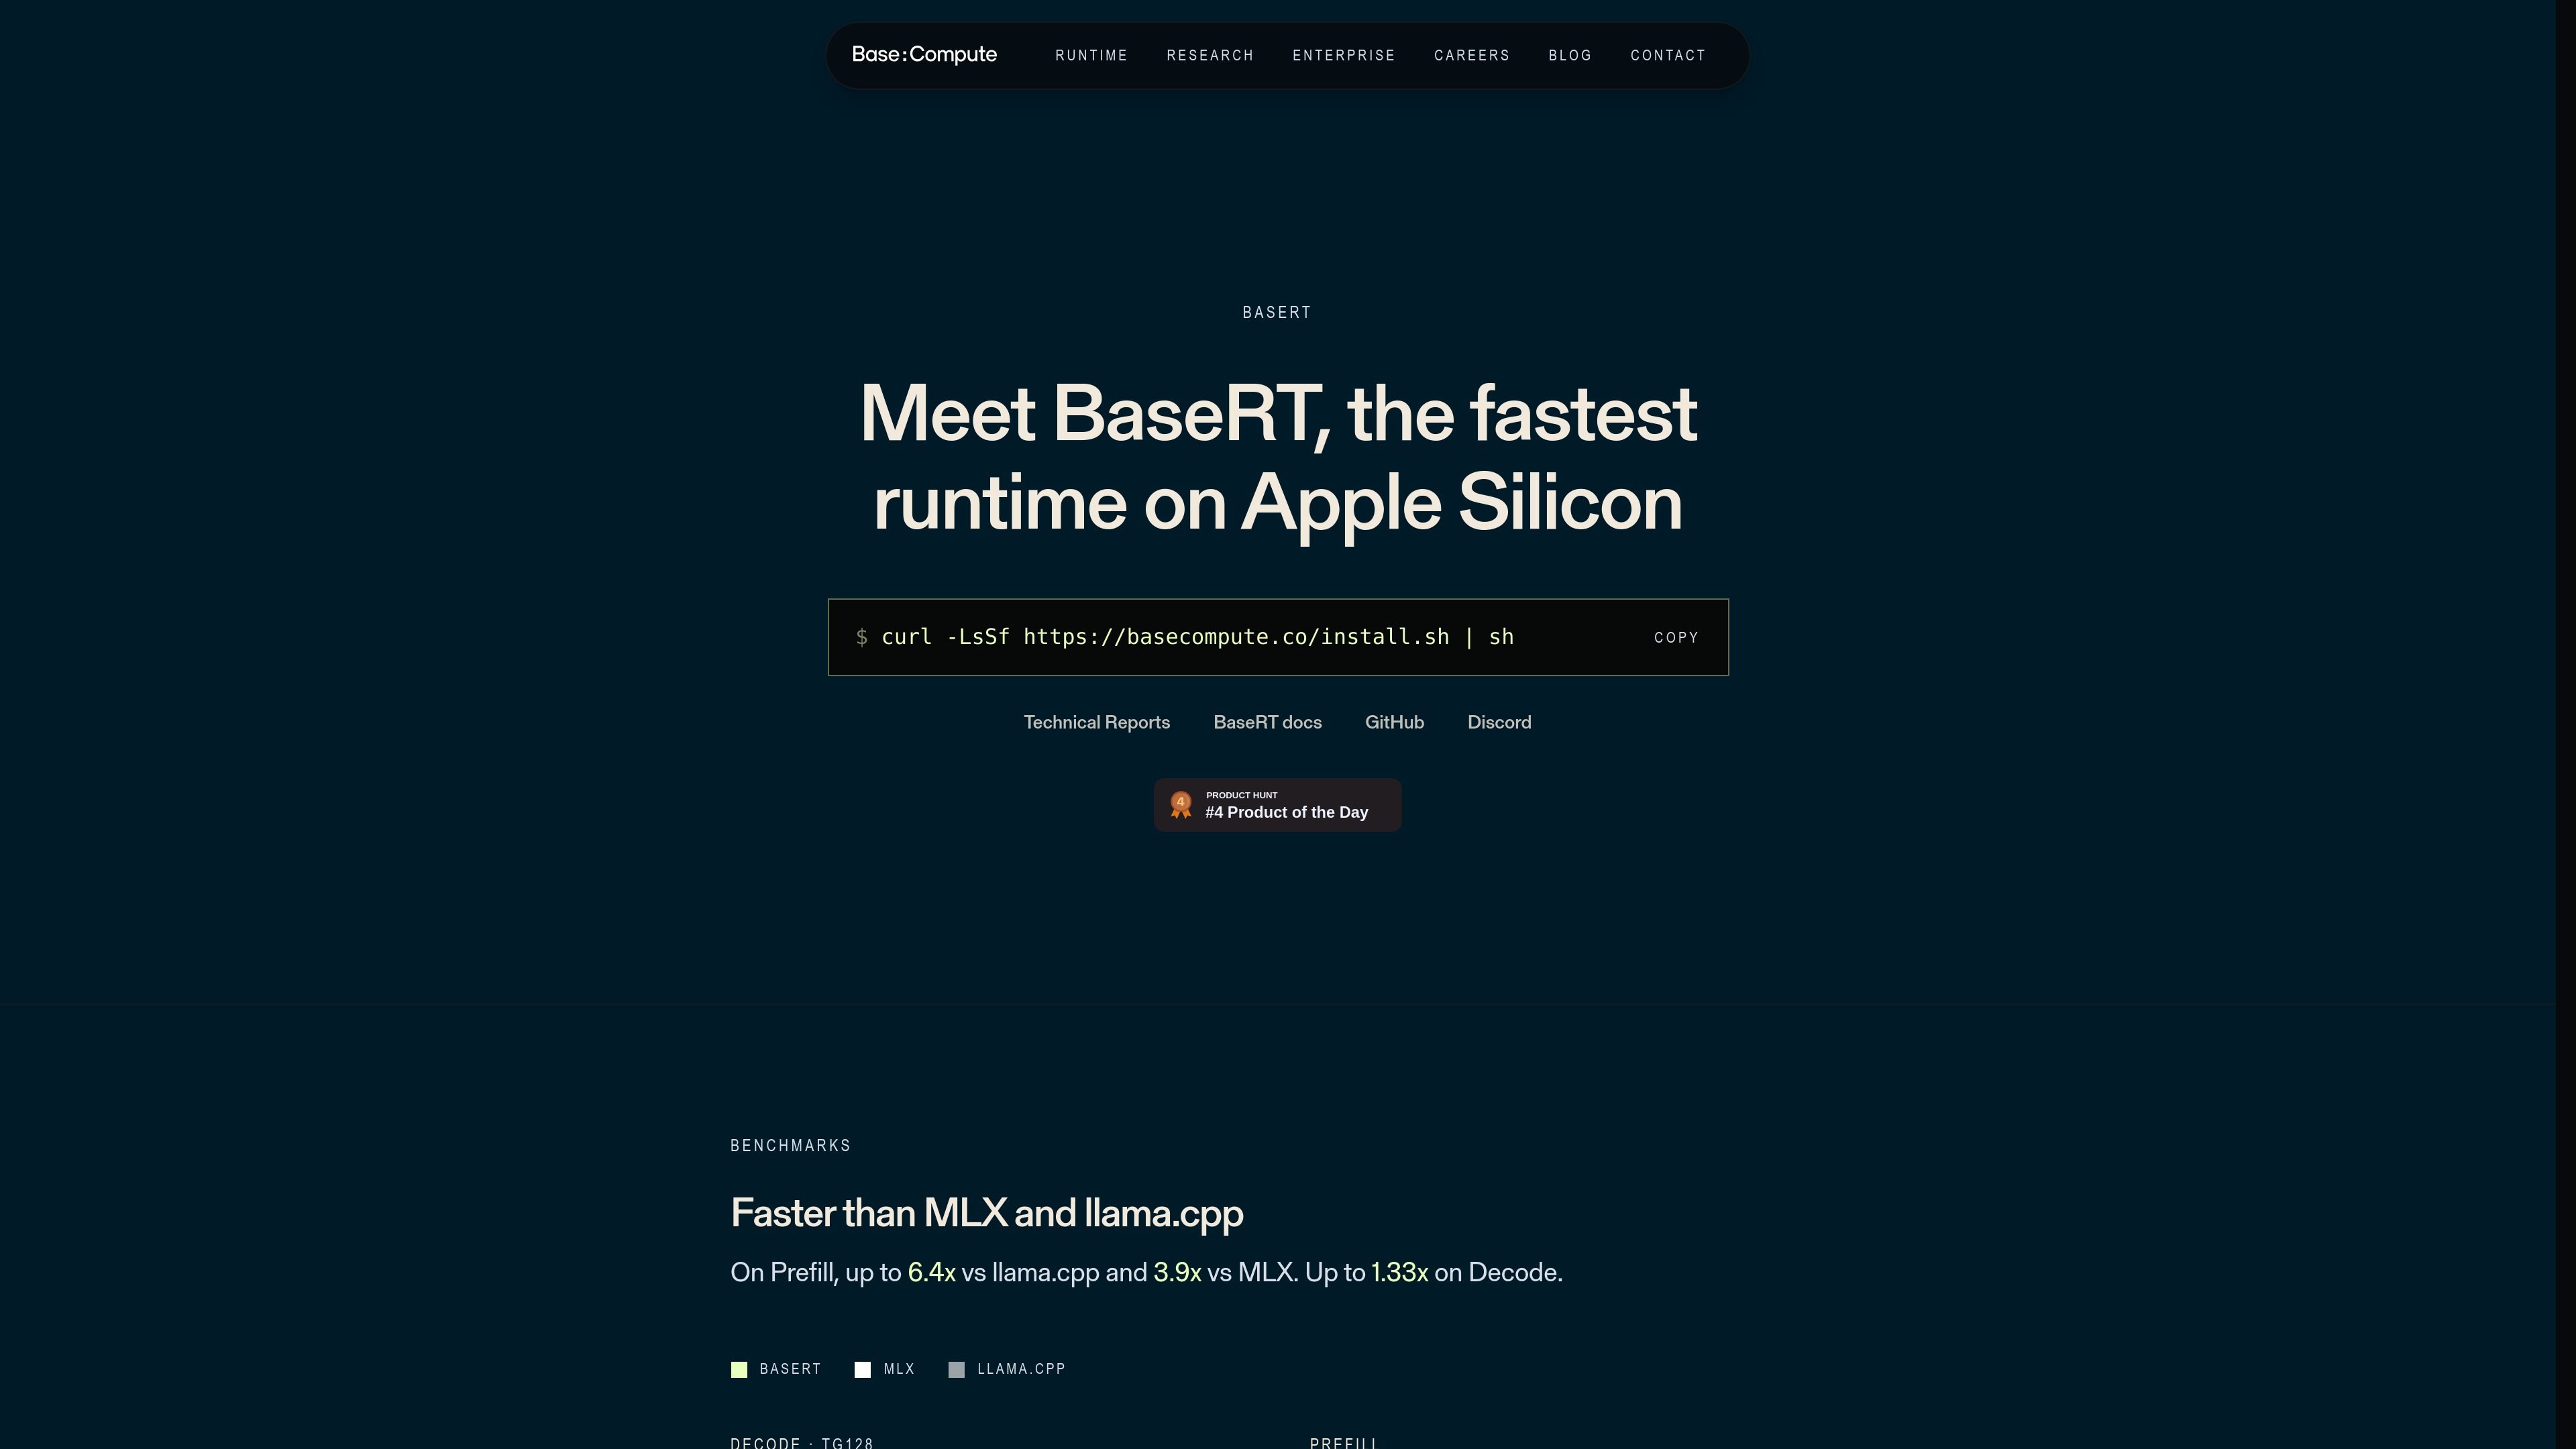
BaseRT 是 Base Compute 推出的适用于 Apple Silicon 的本地 LLM 运行时。首页将其描述为 Apple Silicon 上速度最快的 LLM 运行时,并展示了通过一条命令安装、在您自己的设备上运行模型的流程。
它的核心任务是在本地提供并运行开源模型,重点是将推理保留在设备上,面向个人开发者和编码代理工作流。产品页面明确展示了一个本地模型被提供服务,然后在不向外部 API 发送数据的情况下连接到编码代理。
Base Compute 的研究页面将 BaseRT 定位为适用于 Apple Silicon 的原生 Metal 推理运行时,技术报告主要关注相较 llama.cpp 和 MLX 的吞吐量提升。企业页面将这种设备端方式扩展到希望在自己已拥有的硬件上运行 AI 的团队。
首页展示了使用 shell 安装程序的一行安装流程,使本地使用的设置保持简单。
BaseRT 被描述为专为 Apple Silicon 构建的原生 Metal 推理运行时,技术报告解释了它使用芯片特定的内核融合和自定义调度逻辑。
产品页面说明 BaseRT 可以在本地提供模型服务,然后由同一台机器上的编码代理使用,保持提示和输出都在设备上处理。
首页列出了支持的模型家族,包括 Qwen3、Qwen3.5、Qwen3.6、Llama 3.1、Llama 3.2、Gemma 3、Gemma 4、Mistral、Phi-3 和 Nomic BERT。
研究页面说明,在 Apple M 系列设备上,支持从 Q2 到 FP16 的八种量化格式,覆盖广泛的模型家族。
网站提供技术报告、文档、GitHub 和 Discord 链接,为用户提供更深入的实现细节和社区支持路径。
开发者可以在自己的 Mac 上运行编码代理并连接到本地提供服务的模型,让整个流程保持本地化,而不是通过托管 API 路由提示词。
希望在 Apple Silicon 上试验开源模型的个人用户可以快速安装 BaseRT,并在自己的机器上运行推理。
工程团队可以使用企业工作流来评估本地 AI 如何适配现有的笔记本和工作站设备群,然后再更广泛地采用。
处理敏感材料的组织可以将 AI 辅助写作、摘要或分析保留在设备端,以避免将数据发送给第三方服务。
关注性能的团队可以使用研究和基准材料,在 Apple 硬件上比较 BaseRT 与 llama.cpp 和 MLX。
BaseRT 通过产品页面展示的一行安装脚本从命令行安装。安装完成后,您可以在本地运行受支持的模型,并将编码代理指向该服务器。
首页突出本地编码代理工作流,并说明 BaseRT 面向使用开源模型构建本地 AI 的用户。企业页面也将其定位为适合在已拥有的笔记本和工作站上运行 AI 的组织。
BaseRT 支持在 Apple Silicon 上进行本地模型服务,研究页面还说明它支持 Apple M 系列设备上的多种模型家族。首页列出了受支持的模型,包括 Qwen3、Qwen3.5、Qwen3.6、Llama 3.1、Llama 3.2、Gemma 3、Gemma 4、Mistral、Phi-3 和 Nomic BERT。
来源未说明 BaseRT 的公开定价页面。定价 URL 当前返回 404,因此现有证据无法验证价格和套餐详情。
产品页面聚焦于 Apple Silicon 和 Apple M 系列设备。企业页面提到 Windows 和 Linux 工作站作为通用的本地 AI 硬件,但 BaseRT 运行时本身在网站上被呈现为适用于 Apple Silicon 的运行时。
流量数据仅供参考。
| 4月 | 0 |
|---|---|
| 5月 | 0 |
| 6月 | 1355 |
暂无流量分析数据。