

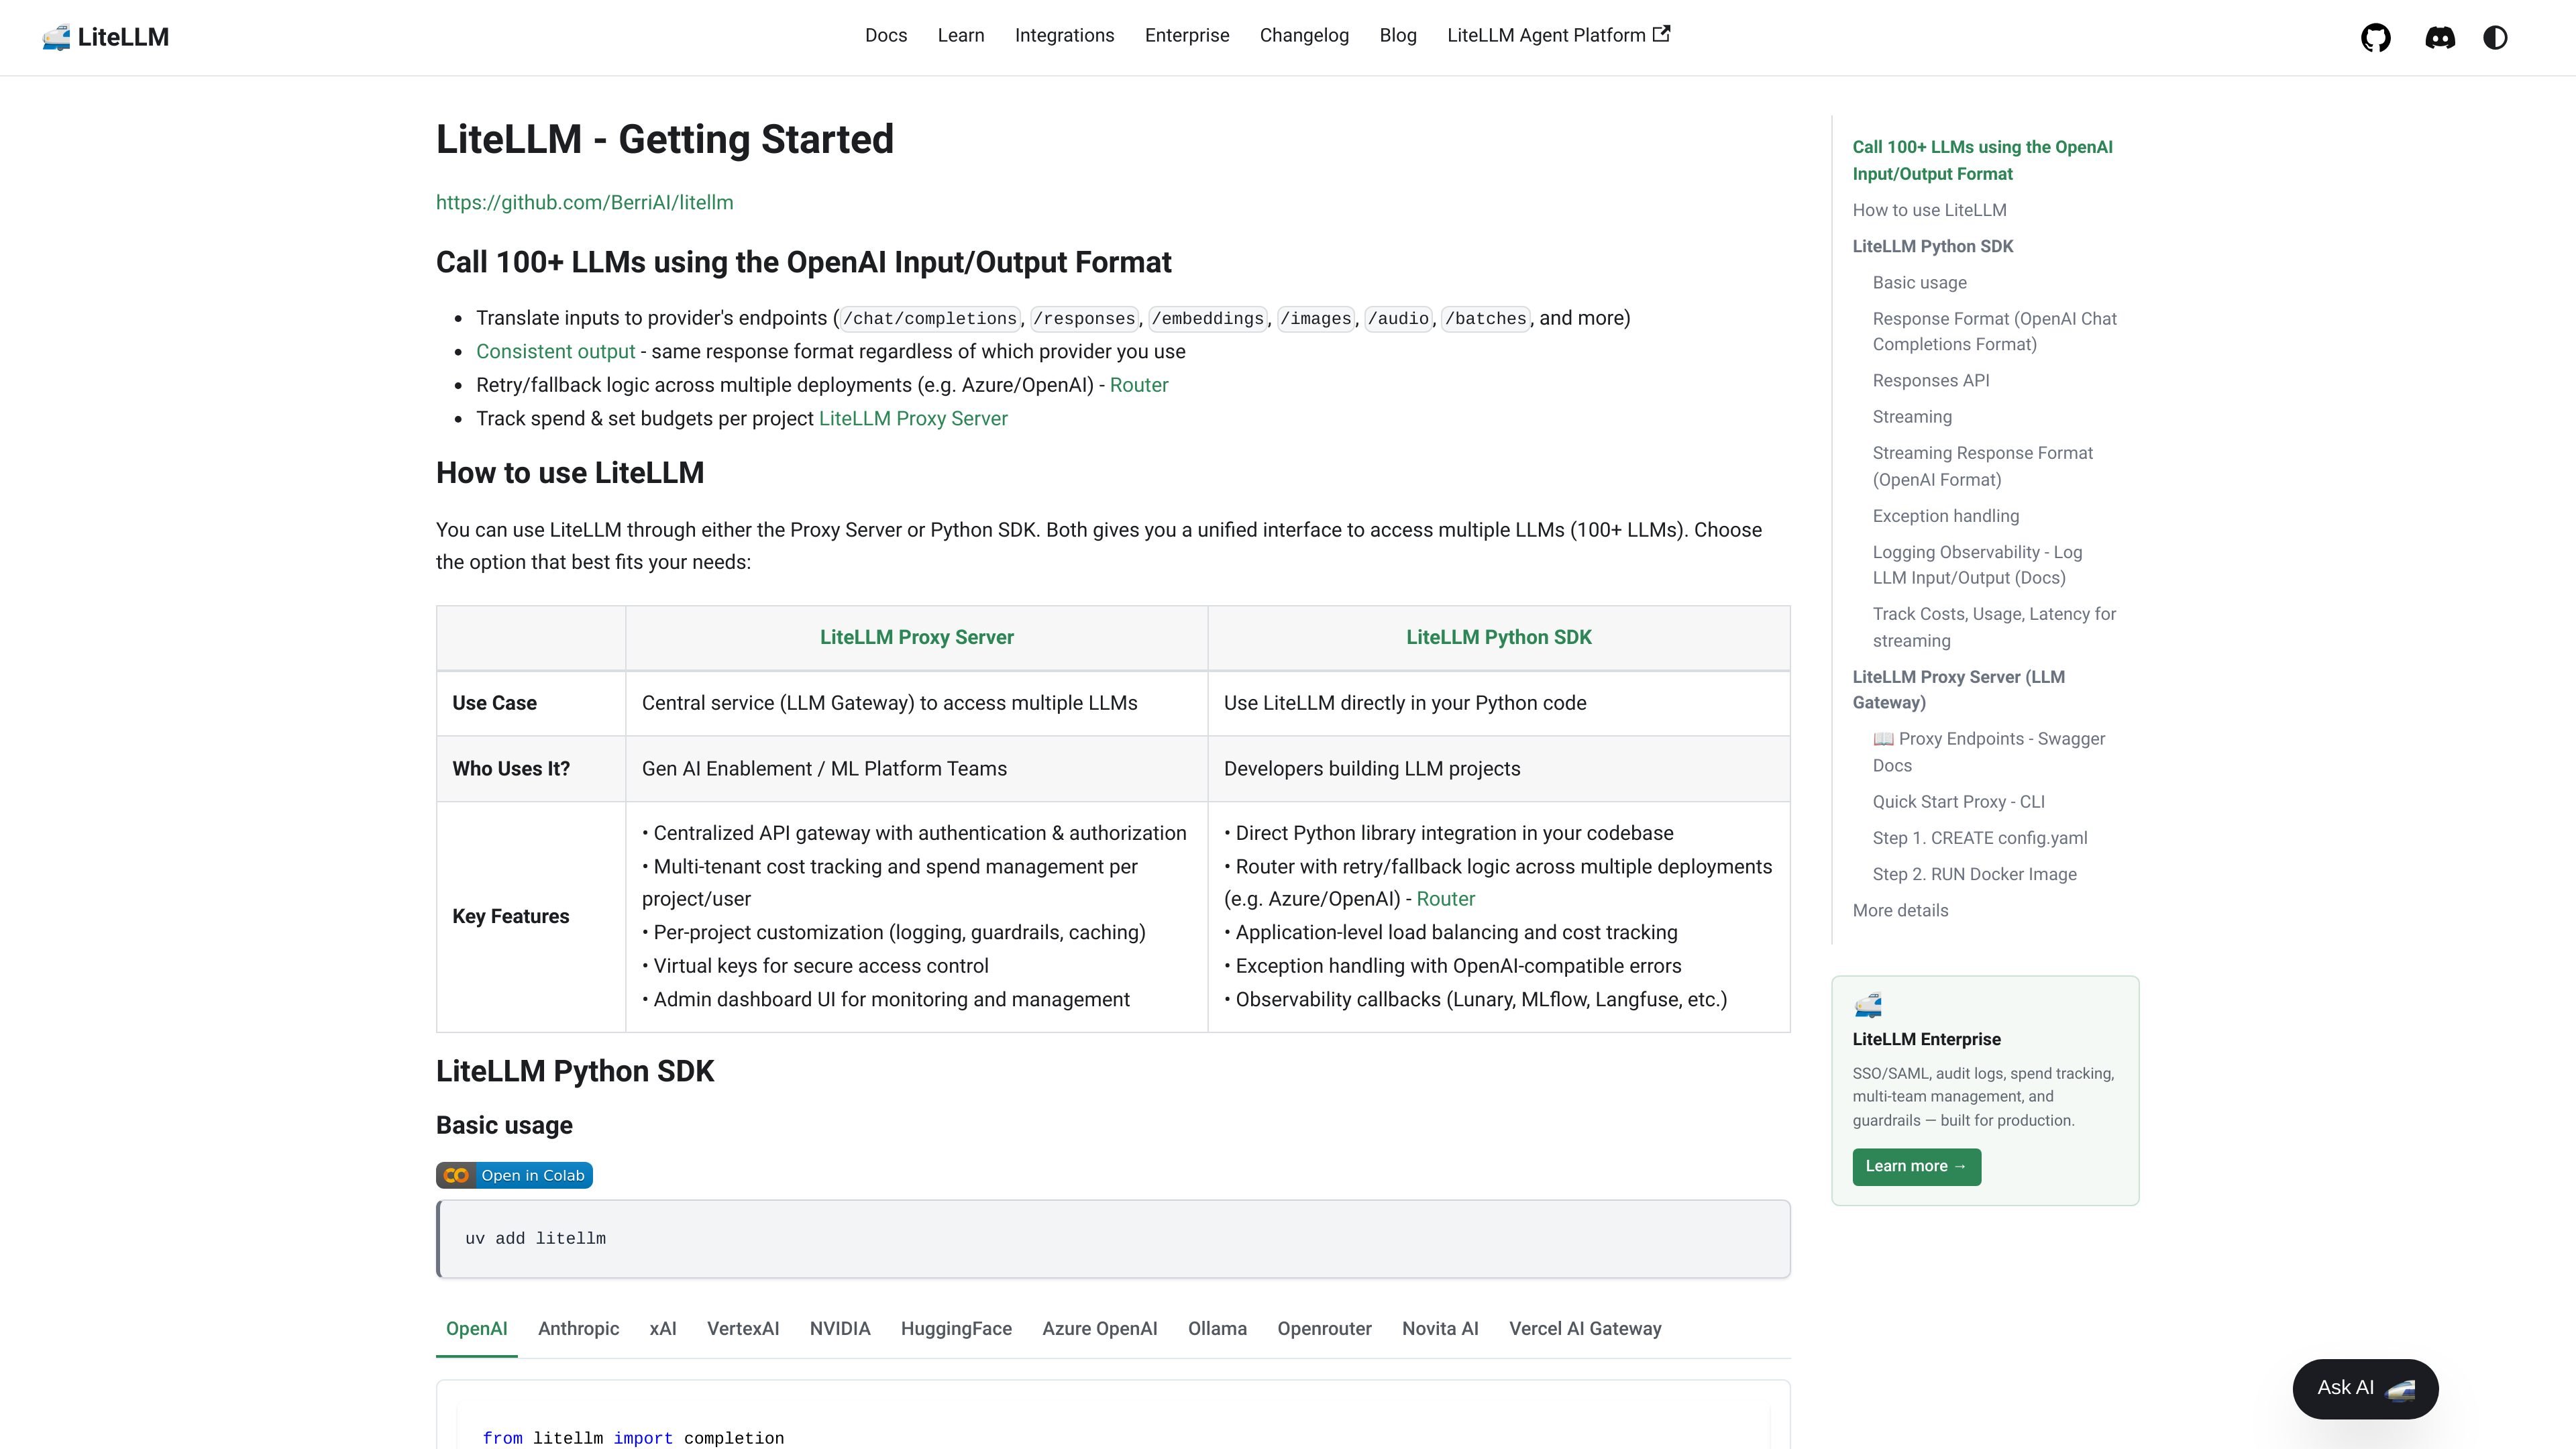
プロバイダーをまたいだOpenAI風アクセス
OpenAI互換のインターフェースで100以上のLLMを呼び出し、chat completions、responses、embeddings、images、audio、batchesなどのプロバイダー固有エンドポイントへの呼び出しに変換します。
LiteLLMは、Python SDKまたはプロキシサーバーのいずれかを通じて大規模言語モデルを呼び出し・管理できる開発者向けプラットフォームです。OpenAI互換のインターフェースを提供しつつ、内部では多数のプロバイダー固有エンドポイントへリクエストを変換することが中心的な役割です。
ドキュメントでは、LiteLLMが100以上のモデルと、chat completions、responses、embeddings、images、audio、batches、routing、プロキシベースのgateway workflowsを含む幅広いエンドポイント種別をサポートすると説明されています。そのため、複数プロバイダーのLLM利用、コスト追跡、リクエスト管理を1つのアクセス層でまとめたいチームに向いています。
OpenAI互換のインターフェースで100以上のLLMを呼び出し、chat completions、responses、embeddings、images、audio、batchesなどのプロバイダー固有エンドポイントへの呼び出しに変換します。
認証と認可、virtual keys、監視・管理用のadmin dashboardを備えた集中型LLM gatewayとしてproxyを利用できます。
projectとuserごとに支出を追跡し、budgetを設定し、logging、guardrails、cachingのようなproject単位のカスタマイズを適用できます。
retryとfallbackロジックでデプロイ間のリクエストをルーティングし、cooldowns、timeouts、queueing、Azure、OpenAI、その他のプロバイダー間でのload balancingをサポートします。
proxyを通じて、chat completions、embeddings、image generation、RAG endpoints、guardrails、memory、その他のプロバイダー固有エンドポイントなど、複数のサポート対象を公開します。
Lunary、MLflow、Langfuseなどのobservability callbackを統合し、アプリケーション側のハンドリングにはOpenAI互換のエラーを使用できます。
複数のアプリケーションが共有モデルプロバイダーへ制御されたアクセスを必要とする場合に、proxyを中央のLLM gatewayとして使います。ドキュメントでは、この構成のための認証、認可、virtual keys、admin monitoring、projectごとのポリシー制御が強調されています。
アプリケーションコードにLiteLLMを直接組み込みたい場合はPython SDKを使います。ドキュメントでは、別のproxyを運用せずに統一されたインターフェースが必要なLLMプロジェクト開発者向けの方法として位置づけられています。
同じモデルエイリアスの複数デプロイ間でトラフィックを分散する必要がある場合はRouterを使います。ルーティングのドキュメントでは、load balancing、retry、fallback、cooldowns、queueing、latencyやcostを考慮した戦略オプションが説明されています。
チームやプロジェクト全体の支出を追跡し、budgetを管理したい場合にプラットフォームを使います。ホームページではprojectごとのspend trackingとbudgetsが示され、proxyのドキュメントではマルチテナントのコスト管理とuser/projectレベルの制御が追加されています。
1つのインターフェースから多くのプロバイダー固有エンドポイントへ到達したい場合にLiteLLMを使います。対応エンドポイントのページでは、chat以外にもembeddings、images、audio、RAG、memory、guardrails、その他の特殊APIまでカバーしていることが示されています。
LiteLLMは、Proxy ServerまたはPython SDKのいずれかを通じて使用できます。ドキュメントでは、プロキシを中央のLLMゲートウェイとして、SDKをPythonコード内で直接使うための विकल्पとして、どちらも同じ製品の一部として示しています。
ドキュメントでは、LiteLLMがOpenAI風の入出力形式を保ちながら、リクエストをプロバイダー固有のエンドポイントに変換すると強調されています。chat completions、responses、embeddings、images、audio、batchesなどをサポートします。
LiteLLM Routerは、複数の同一モデルエイリアスのデプロイ間でロードバランスでき、retry、fallback、cooldowns、timeouts、queueingをサポートします。プロキシのドキュメントでは、本番環境でtoken-per-minuteとrequests-per-minuteの制限を管理する際のcooldownと使用量追跡にRedisベースの追跡も示されています。
収集したソースには公開価格の詳細は表示されていません。pricingのURLはページが見つからないメッセージを返すため、提供されたドキュメントからは価格は利用不可として扱うべきです。
プロキシはGenAI enablementチームとML platformチーム向け、Python SDKはLLMプロジェクトを構築する開発者向けとして説明されています。つまり、この製品は集中管理されたプラットフォーム運用と直接のアプリケーション統合の両方に対応できると考えられます。
トラフィックデータは参考情報としてご利用ください。
| 3月 | 468217 |
|---|---|
| 4月 | 399827 |
| 5月 | 398723 |
aimlapi.com
AIMLAPI provides one API and billing key for accessing a catalog of AI models for chat, reasoning, image, video, audio, voice, search, embeddings, code, and related tasks. It is intended for developers and teams that want to compare and use models from multiple providers through a common platform.

zenmux.ai
複数モデル対応の統合APIと自動ルーティングを備えた企業向けLLMプラットフォーム

www.newapi.ai
New API is an open-source, self-hosted AI gateway for developers and teams. It provides a unified OpenAI-compatible endpoint for connecting multiple AI providers, selecting models, configuring channels, and monitoring usage on their own infrastructure.

router.com
Router by Ramp is an LLM gateway that gives applications one API endpoint for accessing models from multiple providers. It routes eligible requests based on cost, quality, and availability while providing usage and spend visibility.

cometapi.com
CometAPI is a unified, OpenAI-compatible API layer for accessing more than 500 text, image, video, and audio models through one key. It helps developers and teams compare models, centralize billing, and switch providers without maintaining separate vendor integrations.

vercel.com
Vercel AI Gateway gives developers one API surface for hundreds of text, image, video, and audio models across multiple providers. It centralizes model access, routing, fallback, billing, and observability while supporting AI SDK, OpenAI, and Anthropic workflows.