

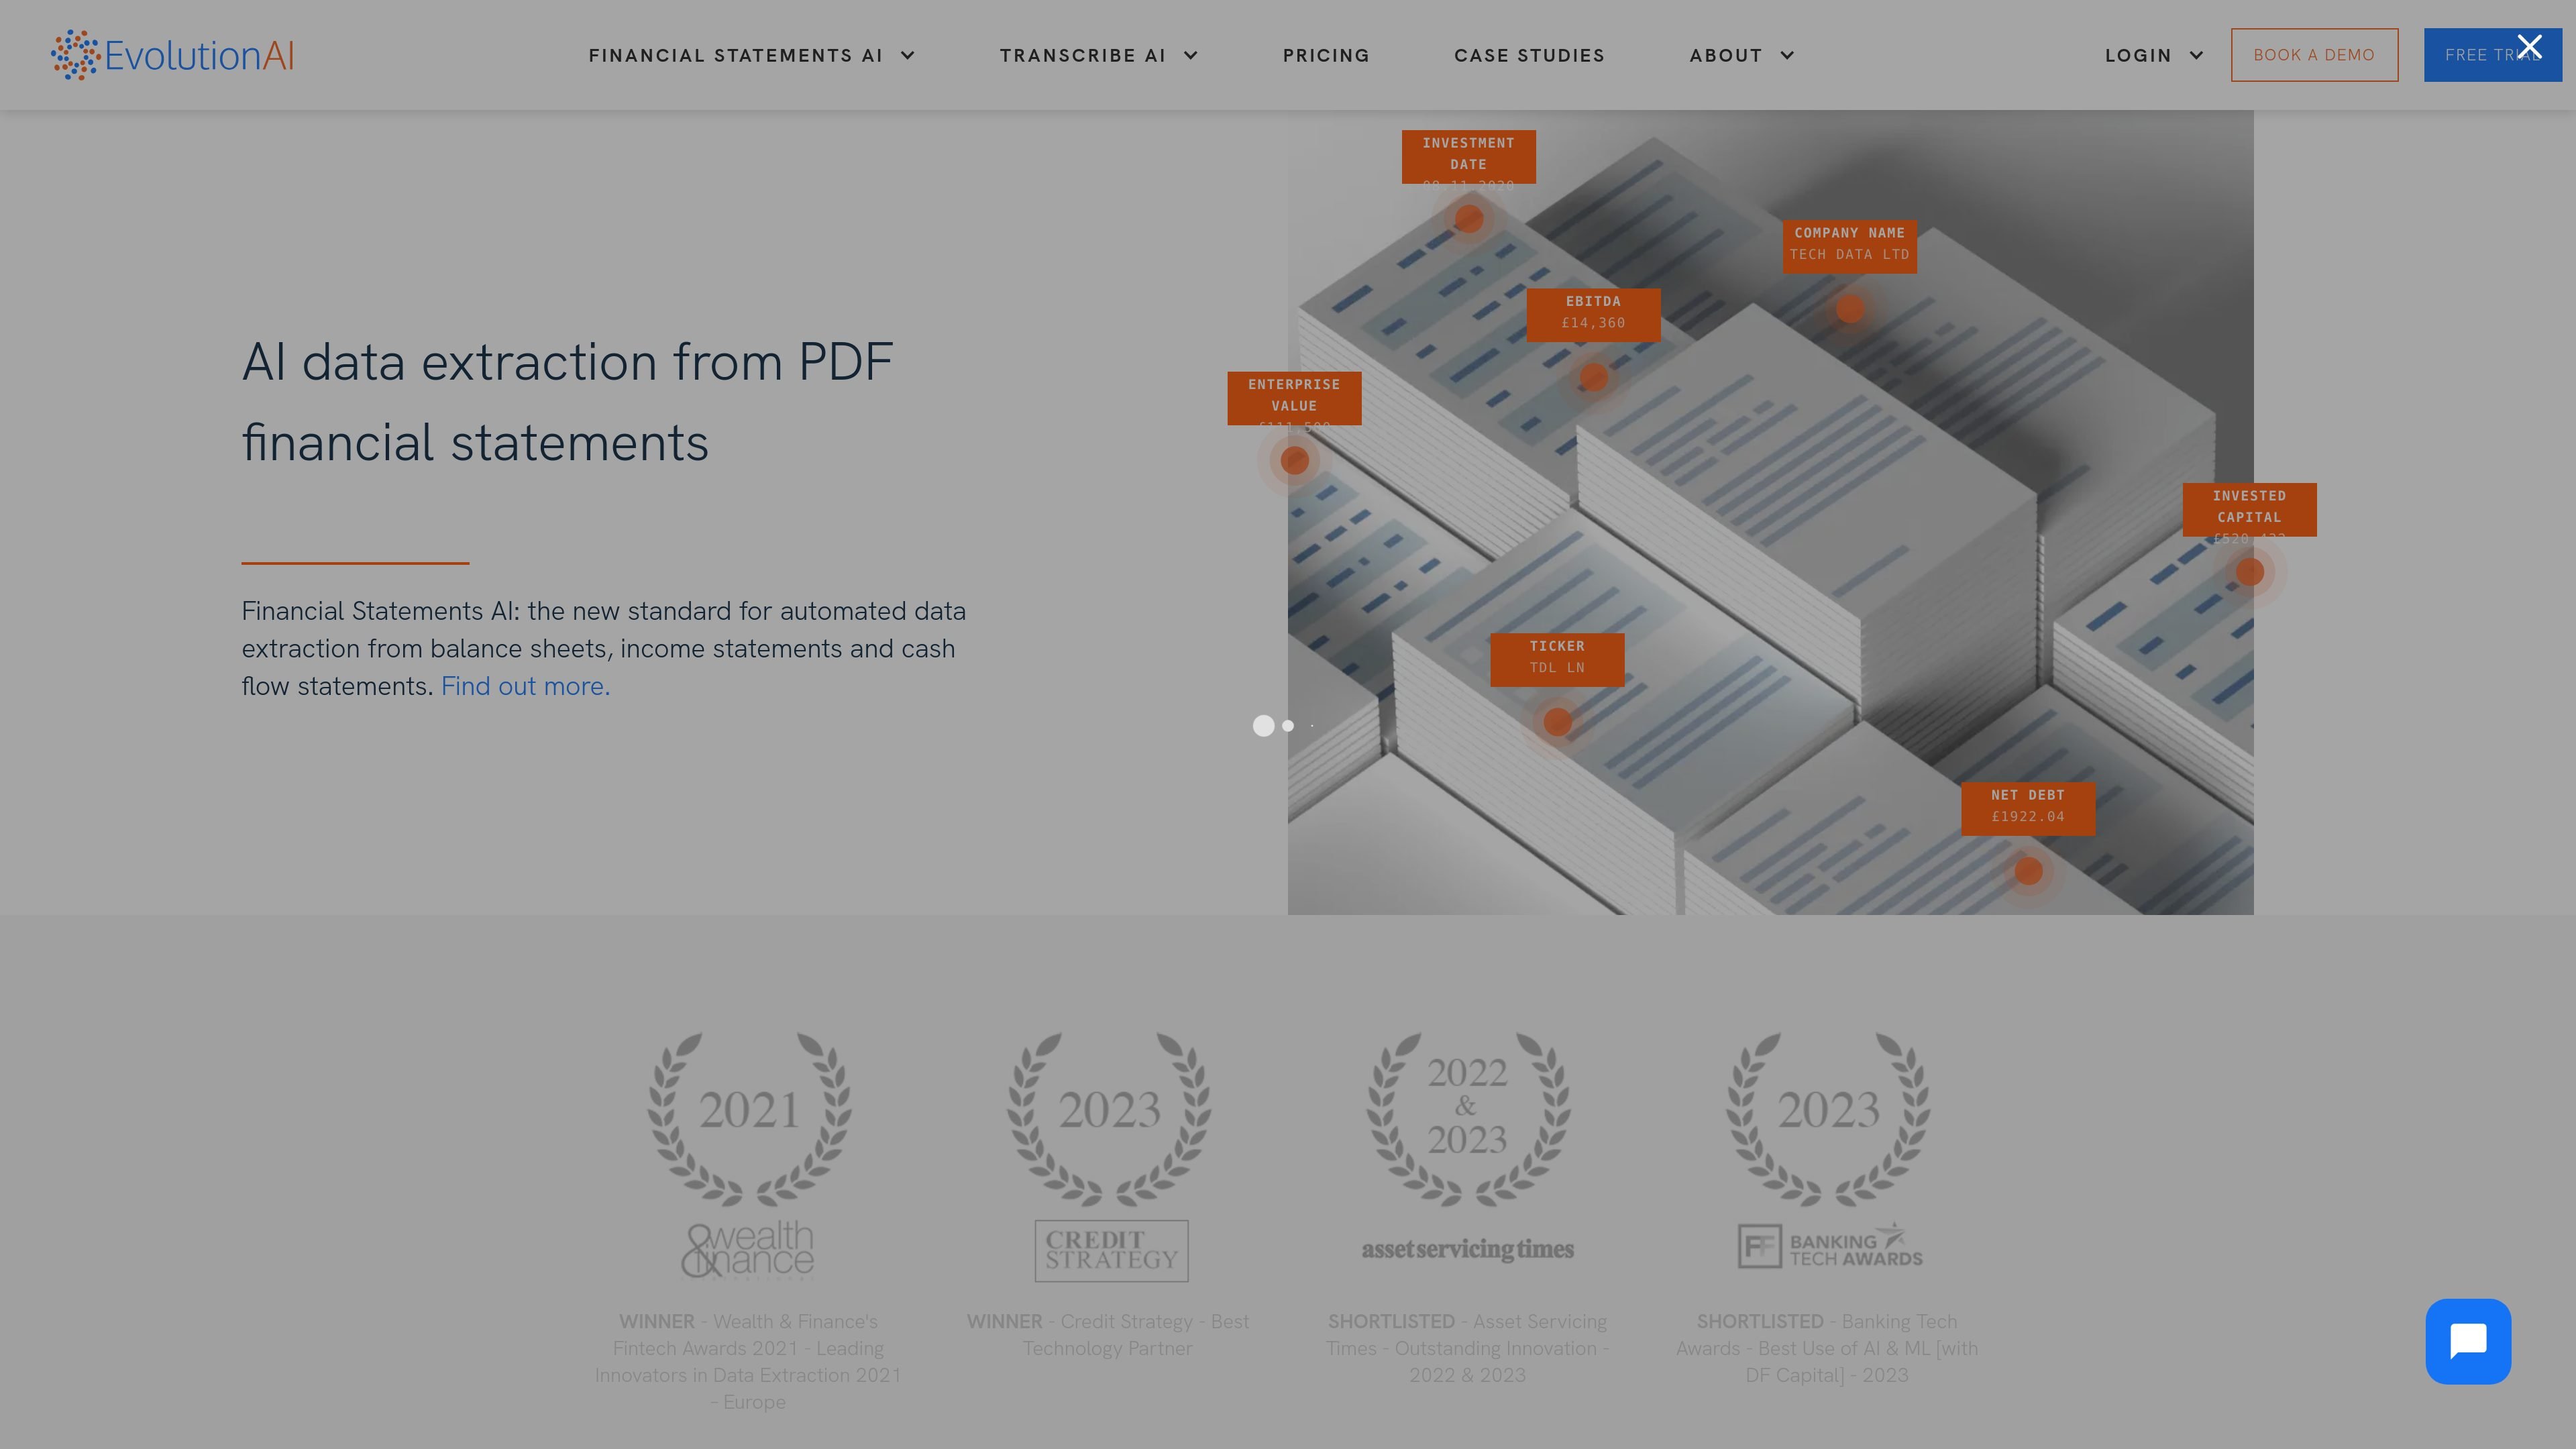
金融フォーマット全体にわたる文書抽出
文書読取に最適化されたAIモデルを使用して、請求書、銀行取引明細書、財務諸表、PDF、スキャン、その他の金融文書からデータを抽出します。
Evolution AIは、金融および文書量の多いワークフローに焦点を当てたAIデータ抽出プラットフォームです。サイトでは主に2つの製品パスが紹介されており、財務諸表向けの Financial Statements AI と、請求書や銀行取引明細書を含むその他のPDFやスキャン向けの Transcribe AI があります。
このプラットフォームは、複雑な文書から構造化データを取得し、日付や金額などの項目を標準化し、必要に応じて人によるレビューを支援するよう設計されています。価格ページではセルフサービスとエンドツーエンドのサービスオプションの両方が示されており、チームは自分たちでプラットフォームを運用するか、Evolution AI にセットアップとQAを任せるかを選択できます。
文書読取に最適化されたAIモデルを使用して、請求書、銀行取引明細書、財務諸表、PDF、スキャン、その他の金融文書からデータを抽出します。
明細行、合計、VATまたは税金、請求書メタデータ、販売者情報、報告期間、通貨、倍率、文書内で利用可能な複雑な複数ページ表をサポートします。
信頼度しきい値、人手を介したレビュー、承認ステップ、抽出値の出所を追跡できる監査ログを備えた、構成可能なQAワークフローを提供します。
標準化された日付形式や推定フィールド計算などの後処理ルールを適用し、抽出データを納品前に正規化します。
REST API と SFTP の連携経路を提供し、請求書ページでは ERP/会計システムや UiPath、Automation Anywhere、Blue Prism などのRPAプラットフォームへの対応が記載されています。
セルフラーニングとゼロショットのアプローチを使用するため、チームは事前学習済みモデルから開始し、出力を修正して、別個の長い学習工程なしに再学習できます。
PDFやスキャンから合計、税金、明細行、支払期日、取引先情報を取得する必要がある買掛金チーム向けに、請求書の取り込みを自動化します。
報告期間、通貨、複数ページの表構造を保持しながら、貸借対照表、キャッシュフロー計算書、損益計算書から値を抽出します。
下流の処理やレビューに向けて、銀行取引明細書やその他の金融文書のデータを正規化します。
データが会計システムやERPシステムに送られる前に、検証、監査可能性、人による承認が必要な文書ワークフローを実行します。
RESTベースのシステム、SFTP転送、RPA主導のプロセスを含む既存の自動化スタックに抽出処理を統合します。
Evolution AIは、セルフサービスとエンドツーエンドの両方のオプションを提供しています。価格ページによると、セルフサービス利用者はサポートとトレーニング付きのクラウドベースプラットフォームを利用し、エンドツーエンドサービスでは Evolution AI の専門アノテーターのチームがセットアップとQAを担当します。
この製品は、請求書、銀行取引明細書、財務諸表、その他の文書タイプなどの金融文書向けに提供されています。how-it-worksページでは、Financial Statements AI は財務諸表に、Transcribe AI はそれ以外のPDFやスキャン文書に対応すると説明されています。
請求書については、サイト上で請求書PDFやスキャンから、明細行や請求書番号、日付、合計額、販売者情報などの文書詳細を含むデータを抽出できると説明されています。財務諸表については、報告期間、通貨、倍率、複雑な表などの財務概念への対応が記載されています。
how-it-worksページによると、このプラットフォームは構成可能なQAワークフロー、信頼度の低い項目に対する人手レビュー、後処理ルール、REST APIやSFTPなどの複数の連携経路をサポートしています。請求書ページでは、ERP/会計システムとの連携や、UiPath、Automation Anywhere、Blue Prism などのRPAツールにも言及しています。
サイトでは Evolution AI を、特に請求書処理、財務諸表抽出、Transcribe AI によるより広範な文書処理に向けた、金融サービスおよび文書処理が多いチーム向けの製品として位置付けています。
トラフィックデータは参考情報としてご利用ください。

www.browseract.com
BrowserAct is a no-code AI web scraping and browser automation platform that builds reusable Bots from plain-language data requests. It helps teams collect structured, refreshed web data in the cloud or give local AI agents a browser layer for web tasks.
starterbuild.com
Page to Markdown is a free Chrome extension that converts webpages or selected content into clean, usable Markdown. It is designed for notes, documentation, research, AI tools, and coding workflows.
microsoft.github.io
GraphRAG is a research project and data pipeline for extracting structured information from unstructured text with language models, then using graph-based context to support question answering over private data.

www.llamaindex.ai
LlamaParse is an AI document parsing platform that converts complex PDFs, office files, spreadsheets, images, and other documents into structured, AI-ready data. It is designed for developers and enterprise teams building retrieval, extraction, and document automation workflows.

python.useinstructor.com
Instructor is a developer library for extracting structured, validated data from large language models. It uses Pydantic schemas, automatic retries, streaming, and a consistent interface across cloud, local, and routed LLM providers.

imagetotext.info
画像やPDFを編集可能なテキストに変換する無料Web OCR