
Webhook 和端点测试
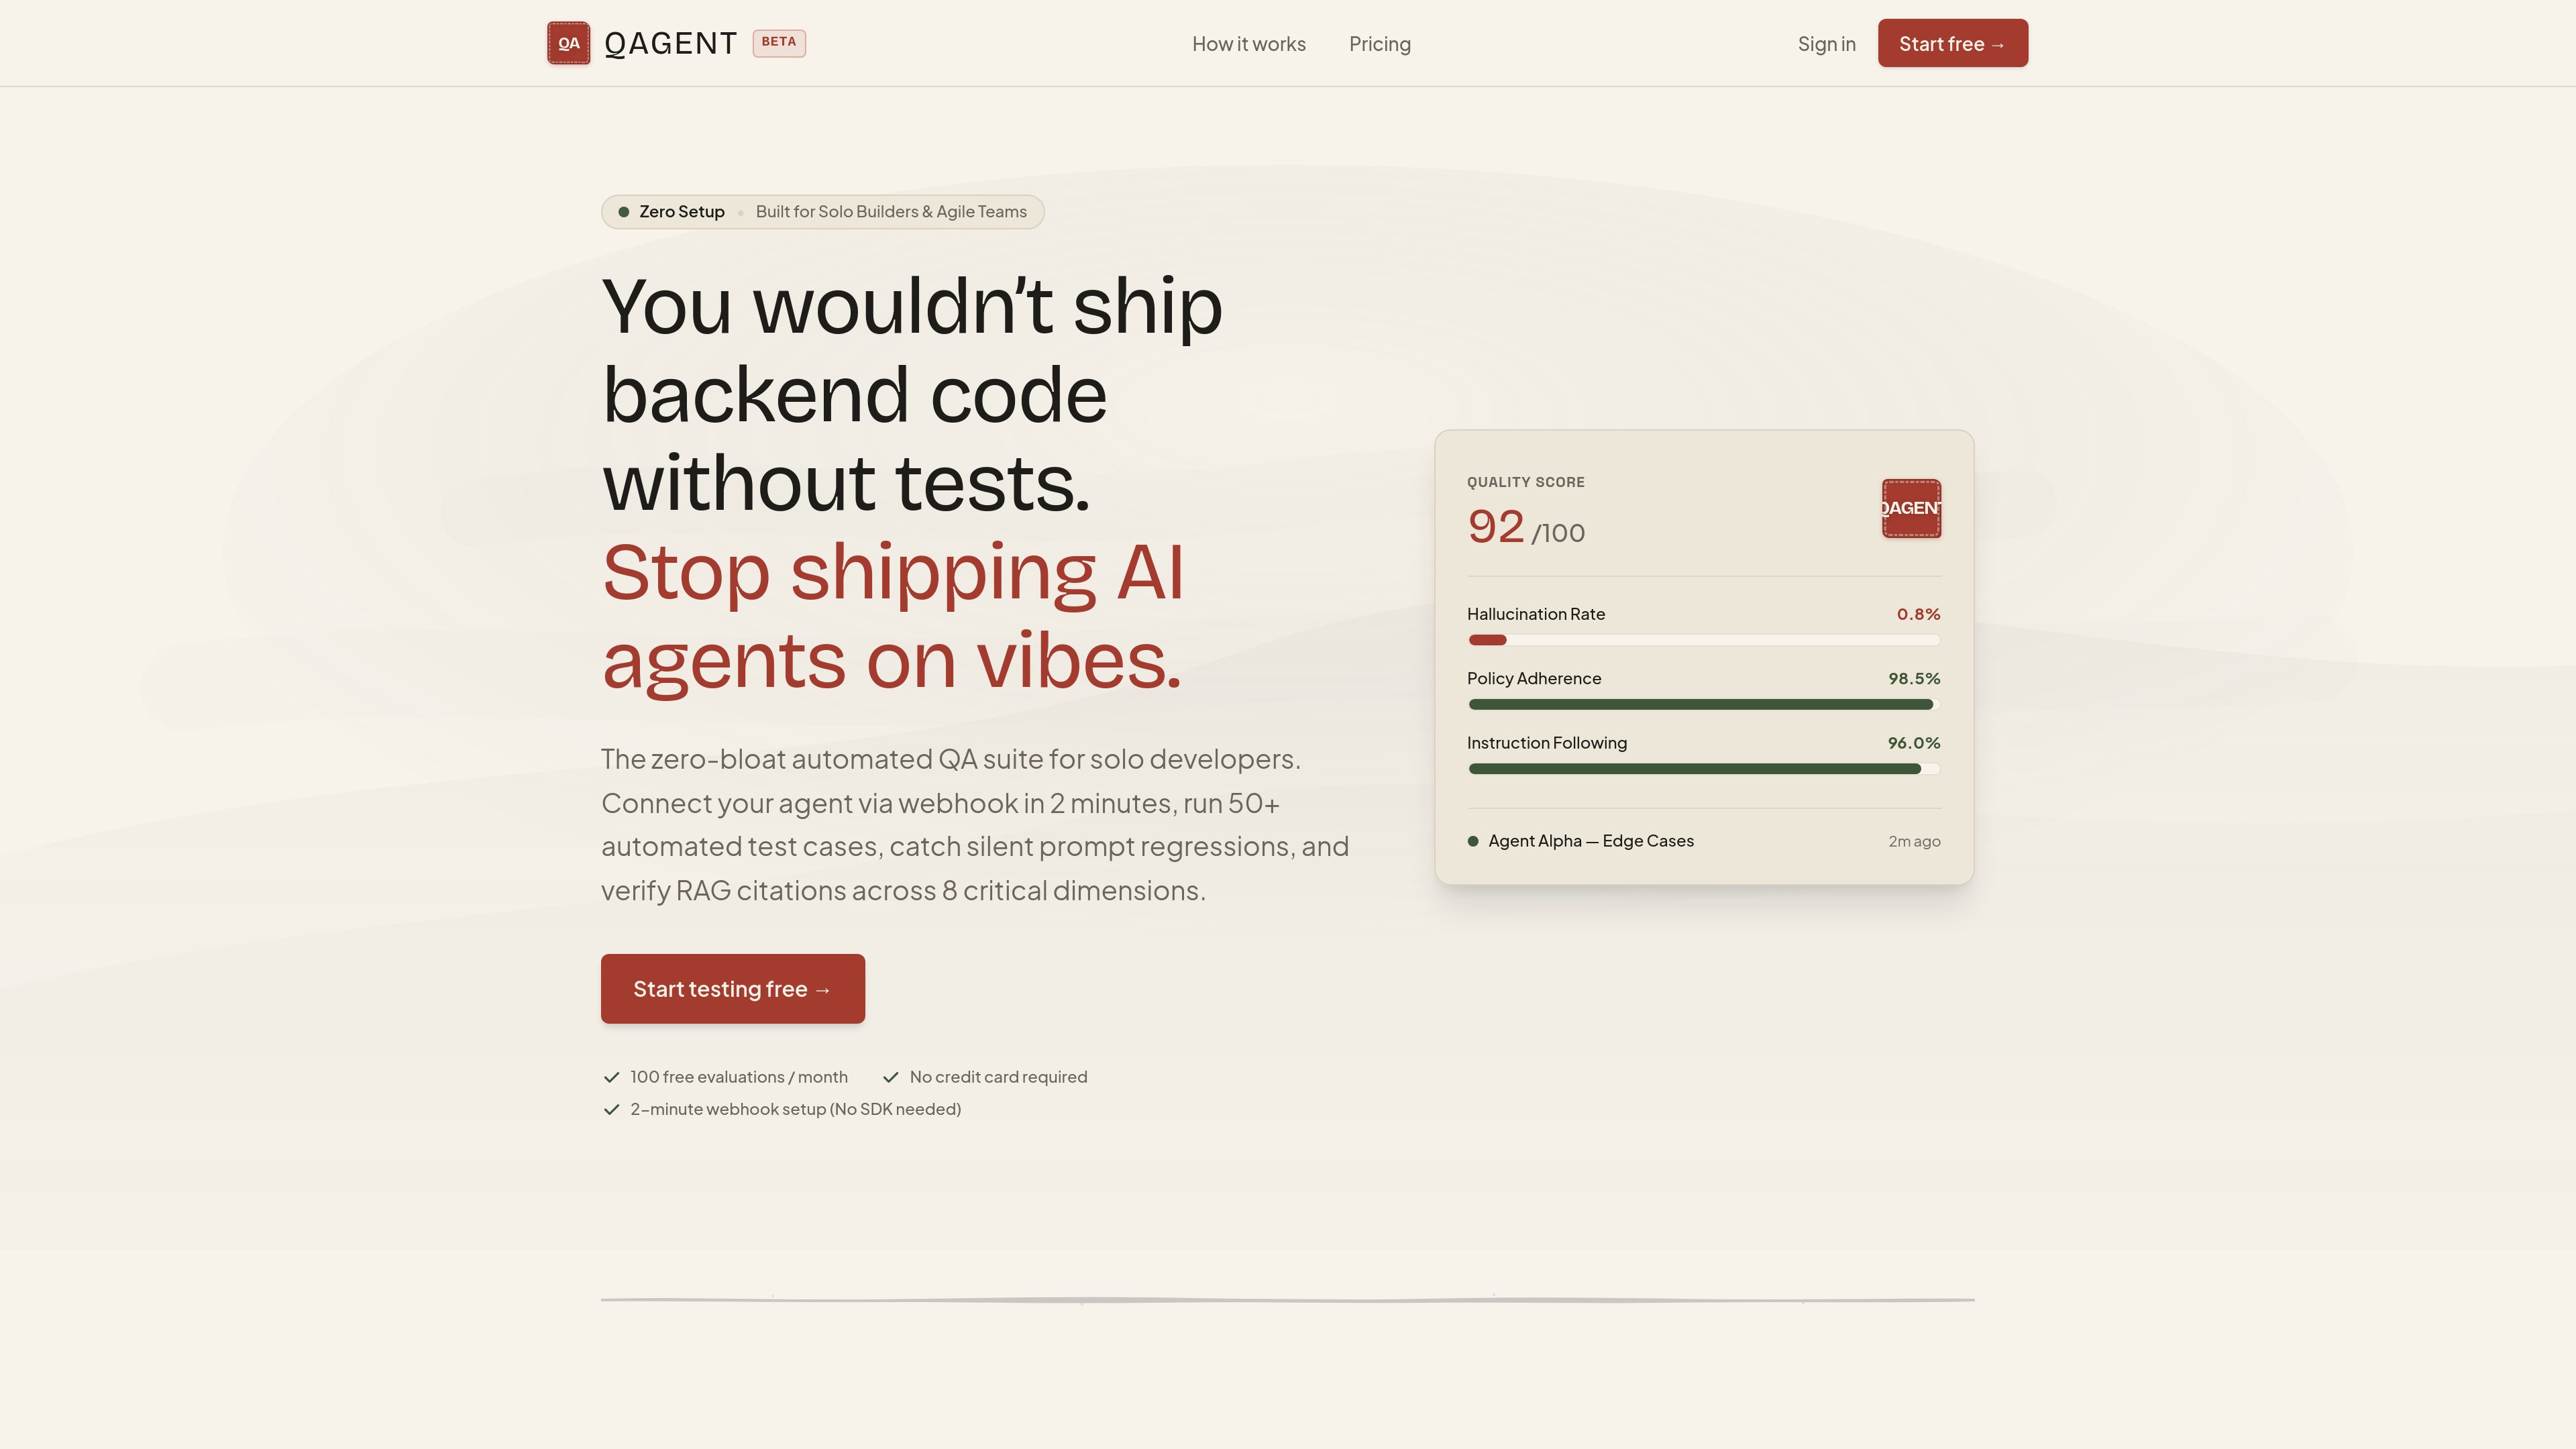
通过端点、Webhook 或 LangChain 工作流连接智能体。主页称设置约需两分钟,且无需 SDK。

面向开发者和敏捷团队的 AI 智能体测试与质量保障平台,可通过 Webhook 或端点连接智能体,运行自动化测试用例,并评估响应的事实依据、政策遵循、提示词合规性及相关质量维度。
QAgent 是面向生产环境 AI 智能体的自动化测试与质量保障平台。它可连接智能体端点、Webhook 或 LangChain 工作流,然后将实时响应与用户定义的事实依据和预期行为评估标准进行比较。
该平台旨在以可重复的评估取代临时的人工检查,覆盖正确性、幻觉风险、提示词遵循、政策约束、检索增强生成行为、升级决策以及多轮上下文等方面。QAgent 面向独立开发者和交付 AI 智能体的敏捷团队。
通过端点、Webhook 或 LangChain 工作流连接智能体。主页称设置约需两分钟,且无需 SDK。
使用明确的“必须”或“不得”要求定义正式规则、文档和预期行为,然后将这些要求与智能体的实际响应进行比较。
文档列出的评估领域包括回答质量、反幻觉与事实依据、政策遵循、升级正确性、RAG 忠实度、上下文相关性、上下文召回率以及多轮上下文记忆。
并行运行边界情况、对抗性攻击和多轮对话,以检查超出简单单轮问答的行为。
获得确定性的通过/失败评级、质量分数、评估器发现、示例报告中的置信度指标以及分步骤的失败根因。
跟踪不同提示词迭代版本之间的分数变化,帮助团队识别某项更改何时改善了一种行为却在其他方面造成回归。
独立开发者可以在更改系统提示词后运行已保存的测试套件,并在部署更新后的智能体前检查回归问题。
团队可以针对实时智能体响应测试退款期限、折扣限制、禁止讨论的主题或其他正式边界等要求。
使用检索增强生成的团队可以将响应与事实依据文档进行比较,并检查检索到的知识是否得到忠实使用。
可以使用对抗性请求和边界情况测试支持或服务智能体,以验证拒答行为,并确定智能体是否会将困难案例交给人工处理,而不是作出缺乏依据的承诺。
向客户交付 AI 智能体的构建者可以生成质量审计报告和评分卡,记录事实依据、RAG 忠实度和政策遵循等检查结果。
主页称用户可以提供智能体端点 URL、Webhook 或 LangChain 工作流。页面描述设置约需两分钟,并称无需 SDK。
测试可以包含用户查询、事实依据信息和预期行为评估标准。评估标准可以使用“必须”或“不得”等措辞指定要求,QAgent 会将其与实时响应进行比较。
文档所述工作流会提供质量分数、确定性的通过/失败评级、评估器发现和失败根因。网站还展示了审计风格的报告,其中包含测试查询、预期评估标准、智能体响应和评估器结论。
主页称用户每月可获得 100 次免费评估,且无需信用卡。现有定价页面显示为未找到页面,因此无法确认付费方案价格、计费条款和取消详情。
流量数据仅供参考。