
结构化概率输出
Fez 针对定义好的决策返回概率,而不是生成文本回答。这支持需要选择、分数或置信度分布的下游逻辑。
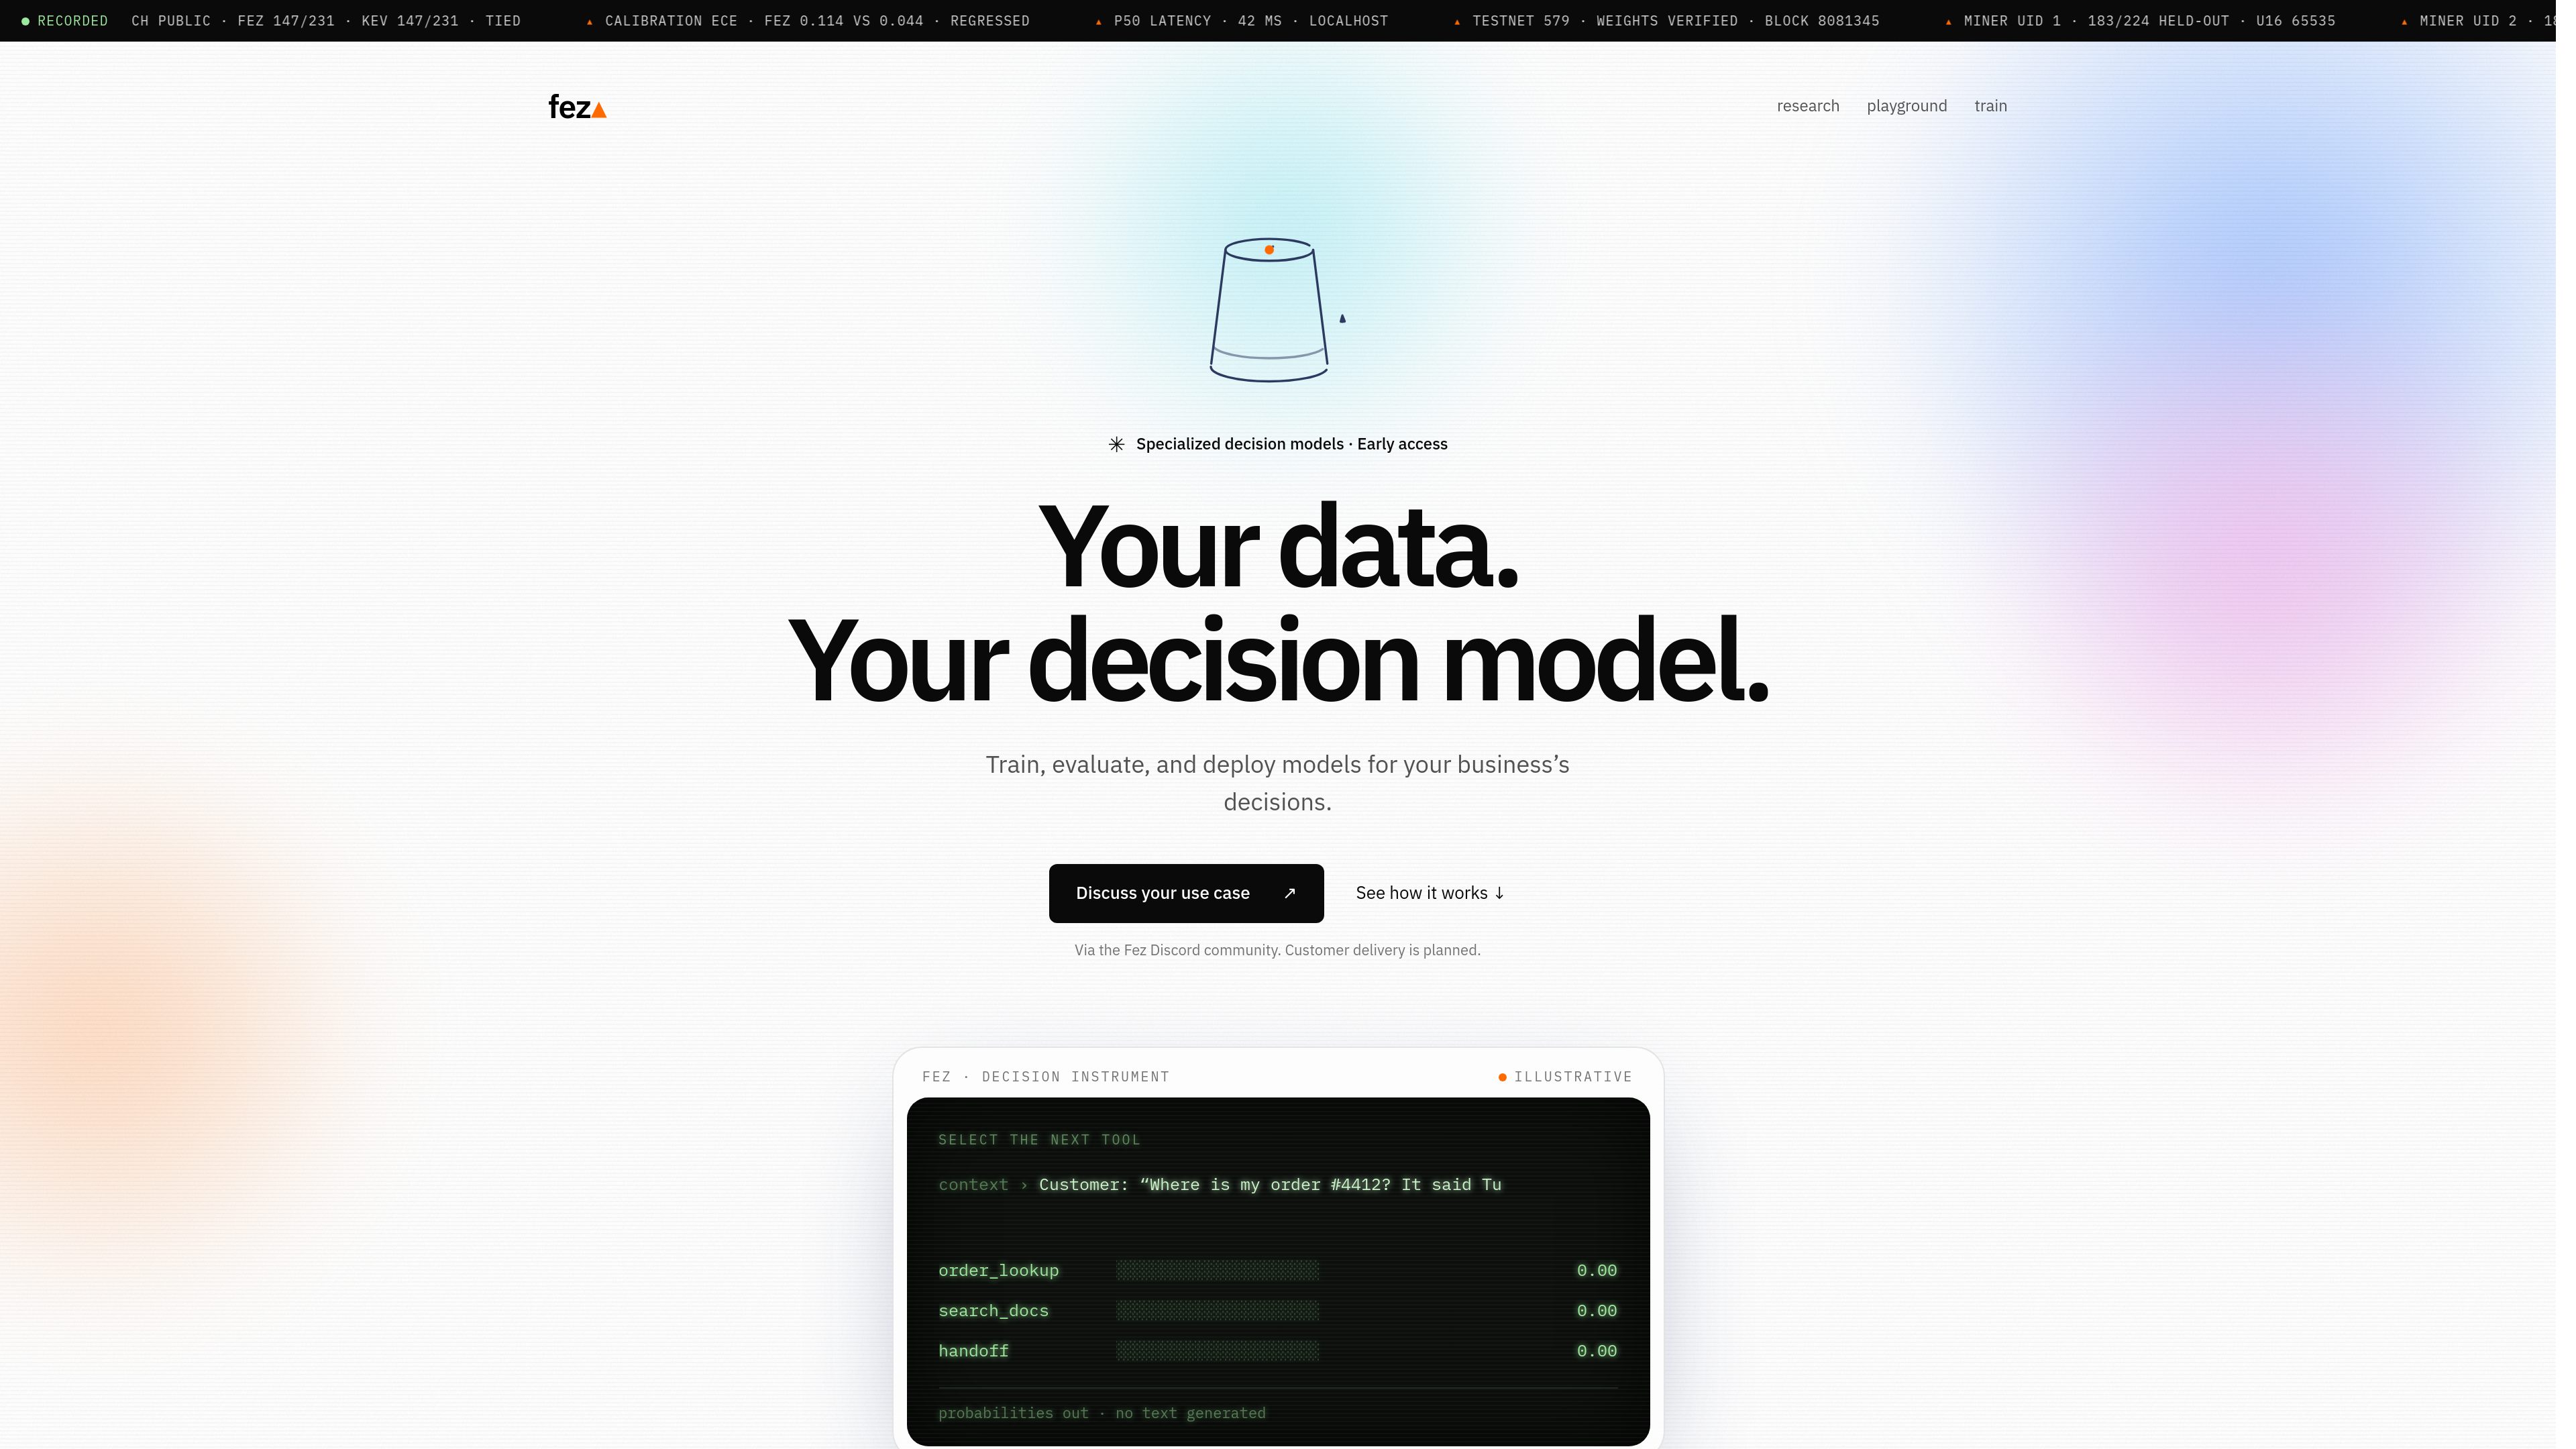
Fez 是一个用于训练和评估业务工作流专用决策模型的实验性平台。其核心接口是输入上下文,输出概率:模型不生成完整回答,而是估计可用的操作或结果。这适用于模型路由、工具选择、升级处理和支持分流等重复性决策。
文档所述工作流使用经授权的标注示例、验收标准、训练任务和评估结果。Fez 还提供一个操场,用户可以输入文本或 JSON 上下文,定义选择题、是/否或评分类决策,并查看分配给每个选项的概率。
Fez 0.8B 被描述为实验性模型。已发布的研究包含基准测试和从训练到测试网的证据,但网站说明这些测量结果仅用于诊断,尚未测量托管成本,且检查点比较并不能确立生产环境 SLA。客户交付已列入计划;训练仪表板目前为开发预览版。
Fez 针对定义好的决策返回概率,而不是生成文本回答。这支持需要选择、分数或置信度分布的下游逻辑。
该产品可以评估请求是否应继续由较小模型处理,或发送给较大模型,从而仅在需要时调用较大模型。
在给定智能体上下文的情况下,Fez 可以为候选工具或下一步操作评分,无需每次选择都生成完整的语言模型回答。
开发预览版面向标注数据集、验收标准、训练任务,以及对已评估模型产物的检查。
用户可以测试文本或 JSON 上下文,并将决策定义为选项、是/否问题或分数。操场会显示每个选项的概率,并将请求发送到已连接的 Fez 检查点。
研究部分记录了包括准确率、布里尔损失、校准相关测量、置信度错误和本地主机延迟在内的基准指标,同时说明了方法限制。
AI 应用可以判断请求是否足够简短且定义明确,适合交给较小模型处理,或是否因存在歧义、上下文较长或需要多步推理而需要较大模型。
智能体可以利用决策输出在可用工具中进行选择,例如查询订单、搜索文档或转交案件,而无需在选择步骤生成文字。
团队可以标注结果,以评估智能体在执行下一步操作前是否应继续、重试、停止或请求人工审核。
操场记录了面向支持场景的决策,包括路由客户请求、检查紧急程度和评估语气。这些示例可以表示为结构化选项或分数。
Fez 旨在针对定义好的决策返回结构化概率。它不会为每个决策生成文本回答,操场可以显示每个可用选项的概率。
文档所述工作流从经授权的标注示例和验收标准开始,随后进行训练和评估。训练仪表板是一个开发预览版,用于提交数据集、跟踪任务和检查已评估产物。
网站将客户交付描述为已列入计划,并标注训练界面尚未作为正式训练服务推出。现有材料未说明面向公众提供的托管服务或部署接口。
操场将已连接模型标识为实验性的 Fez 0.8B。页面说明回答来自已连接的 Fez 检查点,且没有备用模型。
不能。网站说明其基准测量结果仅用于诊断,该比较不能确立生产环境 SLA,尚未测量托管成本,也尚未测量客户成本节省。