
受支持模型目录
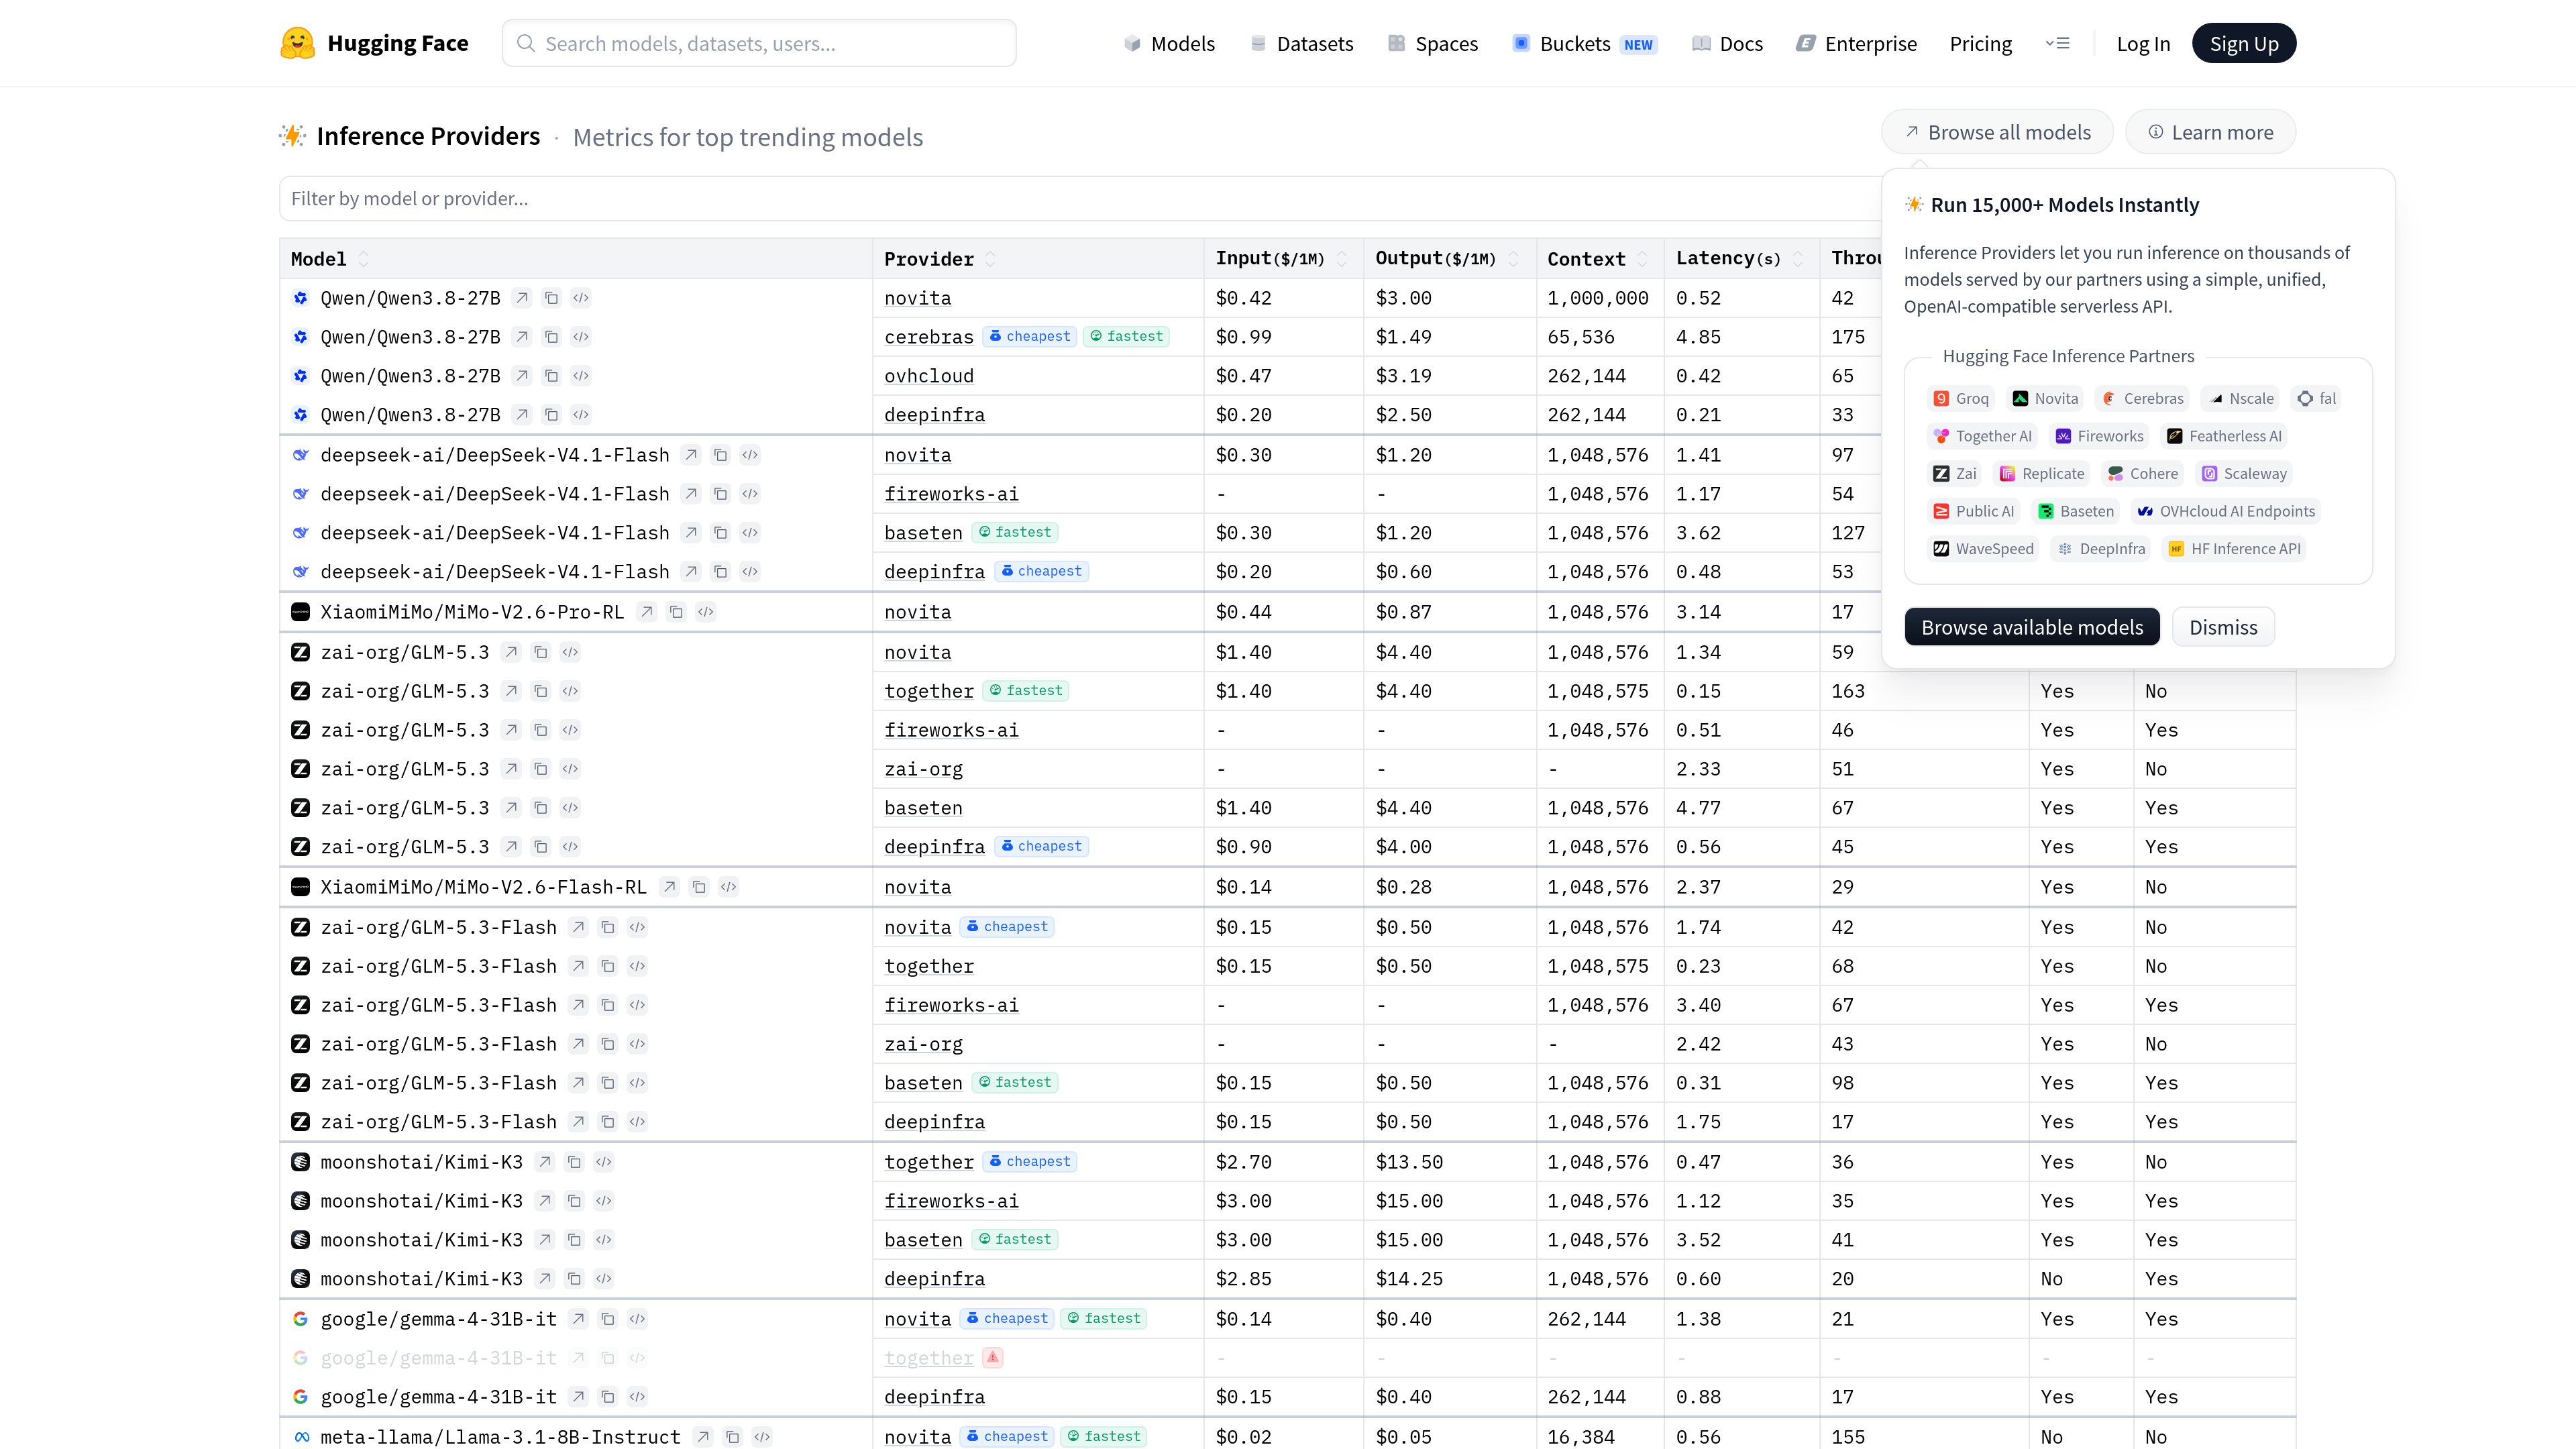
浏览与列出支持该模型的基础设施提供商配对的模型条目,包括 Qwen3.8-27B、DeepSeek-V4.1-Flash、GLM-5.3 和 gpt-oss-120b 等模型。

Hugging Face Inference Providers 帮助开发者根据模型可用性、价格、上下文限制、延迟、吞吐量和能力指标,比较不同基础设施提供商支持的模型。
Hugging Face Inference Providers 是与 Hugging Face Hub 关联的模型服务和提供商比较层。其支持的模型目录会显示哪些基础设施提供商提供所选模型,并呈现用于比较这些选项的运营数据。该目录主要面向评估基于 Hugging Face 模型构建的应用所需托管推理的开发者和团队。
该目录的主要用途是比较同一模型对应的提供商特定选项。在定价信息可用时,目录会列出输入和输出价格、上下文限制、延迟、吞吐量、工具支持以及结构化输出支持。由于这些数值可能因提供商而异,评估时相关的单位是模型与提供商的组合,而不仅仅是模型名称。
Hugging Face Inference Providers 应与 Hugging Face Inference Endpoints 区分开来。Inference Endpoints 产品被定位为一种从 Hugging Face Hub 部署任意 AI 模型的方式,而 Hugging Face Inference Providers 则展示受支持的托管提供商选项及其比较指标。
浏览与列出支持该模型的基础设施提供商配对的模型条目,包括 Qwen3.8-27B、DeepSeek-V4.1-Flash、GLM-5.3 和 gpt-oss-120b 等模型。
在定价信息可用时,比较每 100 万个 token 的显示输入和输出价格。部分行显示短横线而非价格,因此不同提供商的价格可用性并不统一。
查看单个模型与提供商组合所列的秒级延迟和每秒 token 吞吐量,而不仅仅依赖模型级规格。
查看每一行报告的上下文值。目录包含不同模型和提供商之间差异明显的限制,且部分条目不显示上下文值。
表格会标记提供商条目是否支持工具和结构化输出,帮助用户根据应用需求筛选选项。
更广泛的 Hugging Face Tasks 目录按文本、视觉、音频、视频、多模态、表格和强化学习任务整理模型;提供商目录则聚焦于受支持的托管推理条目。
开发者可以查看同一模型的多个提供商行,并在选择推理路径前权衡所列的成本、延迟、吞吐量、上下文和能力标记。
如果应用需要工具使用或结构化输出,团队可以利用相应的表格指标,缩小可用的提供商与模型组合范围。
工程团队可以比较输入/输出 token 价格与延迟和吞吐量,例如在成本较低的提供商与所列速度更快的选项之间进行选择时。
用户可以先通过更广泛的 Hugging Face Tasks 目录,了解语言、计算机视觉、音频、视频、多模态、表格和强化学习任务中的模型,再查看托管选项。
团队可以使用提供商目录比较所列的托管选项;如果需求是从 Hugging Face Hub 部署模型,则可单独考虑 Inference Endpoints。
该目录使用可用的显示输入和输出价格、上下文限制、延迟、吞吐量、工具支持以及结构化输出支持,比较受支持的模型与提供商组合。
不相同。部分行不显示价格、上下文值或性能值,同一模型在不同提供商处的能力指标也可能不同。
页面将延迟和吞吐量作为其所列条目的比较指标。这些数据应被视为这些条目的目录数值,而不是普遍适用的性能保证。
Hugging Face Inference Providers 展示受支持的托管提供商选项及比较数据。Inference Endpoints 则作为一款可从 Hugging Face Hub 部署任意 AI 模型的产品单独呈现。
Tasks 目录列出语言、计算机视觉、音频、视频、多模态、表格和强化学习任务领域。提供商目录本身是受支持模型与提供商的比较界面,因此应针对具体模型检查任务支持情况。