

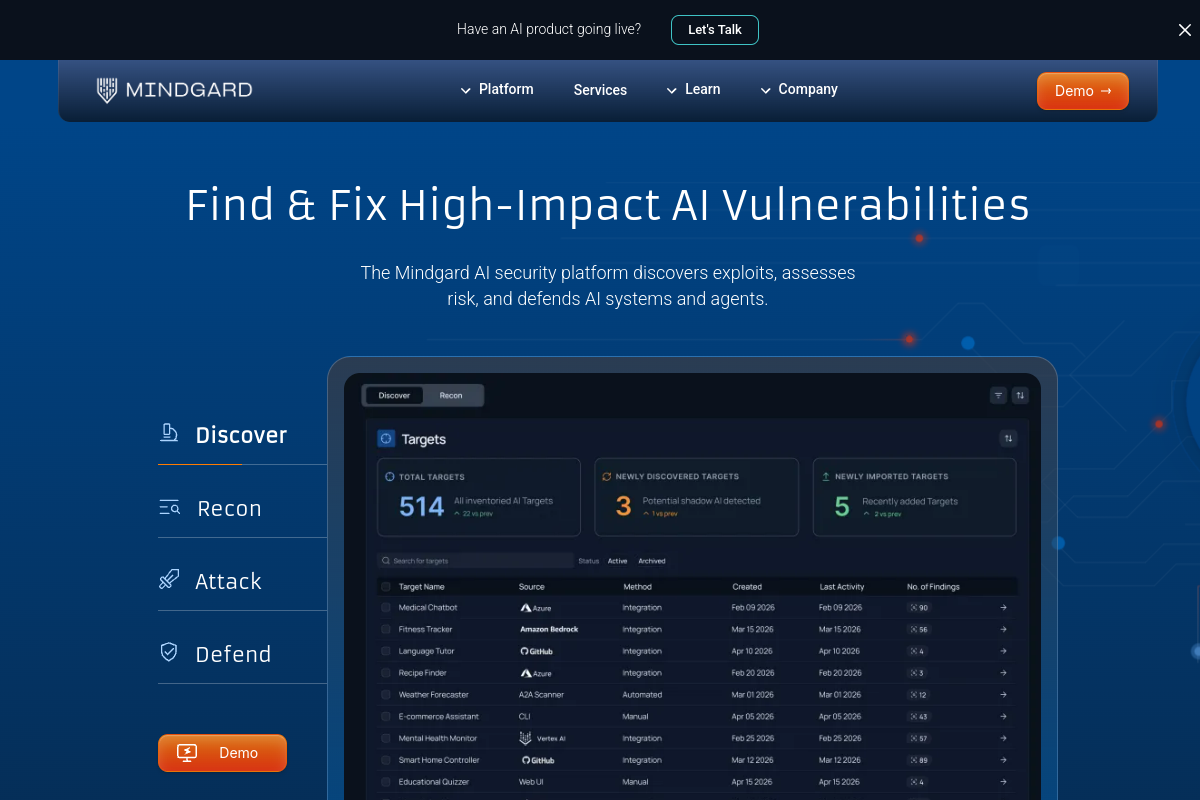
AI 发现与资产清单
发现智能体和影子 AI,爬取 AI 基础设施,并生成 AI 物料清单,以识别需要进行安全评估的系统。
Mindgard 是面向部署模型、智能体和 AI 应用的组织提供的 AI 安全平台。它可梳理 AI 攻击面,执行对抗性评估,并帮助团队处理连接的工具、API、数据和基础设施中的可利用安全弱点。
其工作流程涵盖发现、侦察、攻击测试和防御。该平台采用攻击者式调查和漏洞情报,定位安全漏洞,提供其影响的证据,并支持在 AI 系统发生变化时持续验证。
发现智能体和影子 AI,爬取 AI 基础设施,并生成 AI 物料清单,以识别需要进行安全评估的系统。
在测试前梳理模型、工具、指令和行为。智能体画像有助于识别攻击路径以及防护机制中的弱点。
规划并执行智能体攻击工作流和自适应攻击链,测试 AI 系统、智能体和基础设施中可被利用的漏洞。
解释漏洞影响,并提供支持性证据和修复指导。团队可以重新测试修复措施,验证防御是否仍然有效。
提供运行时 AI 防护与响应、自动化智能体加固和防御审计,帮助缓解已识别的风险。
生成 AI 风险合规报告、管理层报告,以及用于治理、风险和合规流程的证据。
开发和安全团队可以在部署前评估即将发布的聊天机器人或 AI 应用,并利用发现结果在发布过程中解决弱点。
评估 AI 系统对数据、工具和 API 的访问如何为攻击者提取信息创造路径。
评估智能体在使用工具或凭借受委派权限执行操作的工作流中的可靠性、安全性和安全防护弱点。
随着模型、指令和连接系统的发展重复执行评估,检查此前有效的控制措施能否继续经受对抗性测试。
Mindgard 支持 API、CI/CD 流水线、Burp Suite 以及一键式评估工作流。团队可以将测试纳入开发流程,并在生产环境中持续开展评估。
该平台涵盖 AI 聊天机器人、应用、智能体、基础设施和智能体工作流。其明确覆盖范围包括开源模型和托管式 AI 平台。
Mindgard 的设计目标是在无需内部配备 AI 安全专业知识的情况下提供可执行的安全发现结果。它将自动化评估与风险优先级排序及修复指导相结合。
Mindgard 通过自适应攻击测试防护机制,识别控制措施有效或失效的环节。评估还会检查工具、权限、API、数据和基础设施,而不仅限于提示和响应。
流量数据仅供参考。

www.giskard.ai
Giskard is an AI security and evaluation platform for testing conversational LLM agents before and after deployment. It combines automated red teaming, quality evaluation, runtime guardrails, and remediation workflows for teams responsible for reliable AI systems.

www.promptfoo.dev
Promptfoo 是一个用于评估大语言模型应用、智能体、模型及工作流的 AI 安全与测试平台,帮助开发者和安全团队发现漏洞、验证防护措施并跟踪修复。

www.replay.io
Replay QA 是一个代理式 Web 应用测试平台,提供自动化安全扫描,用于渗透测试、验证身份验证流程、捕获运行时证据,并生成帮助团队修复安全及其他软件缺陷的报告。
contextqa.com
面向企业应用和 AI 智能体的 AI 测试自动化,支持生成测试、自愈选择器及跨平台验证。