AI 测试助手可帮助开发者生成测试用例、检查覆盖率、发现漏洞,并简化各种代码库的自动化测试流程。
目录更新于 2026年11月19日
AI 测试助手
Katalon 为软件 QA 团队提供统一的测试自动化与管理工作流,覆盖 Web、移动端、API 和 Windows 桌面应用,支持测试创建、执行、报告及生产环境覆盖分析。
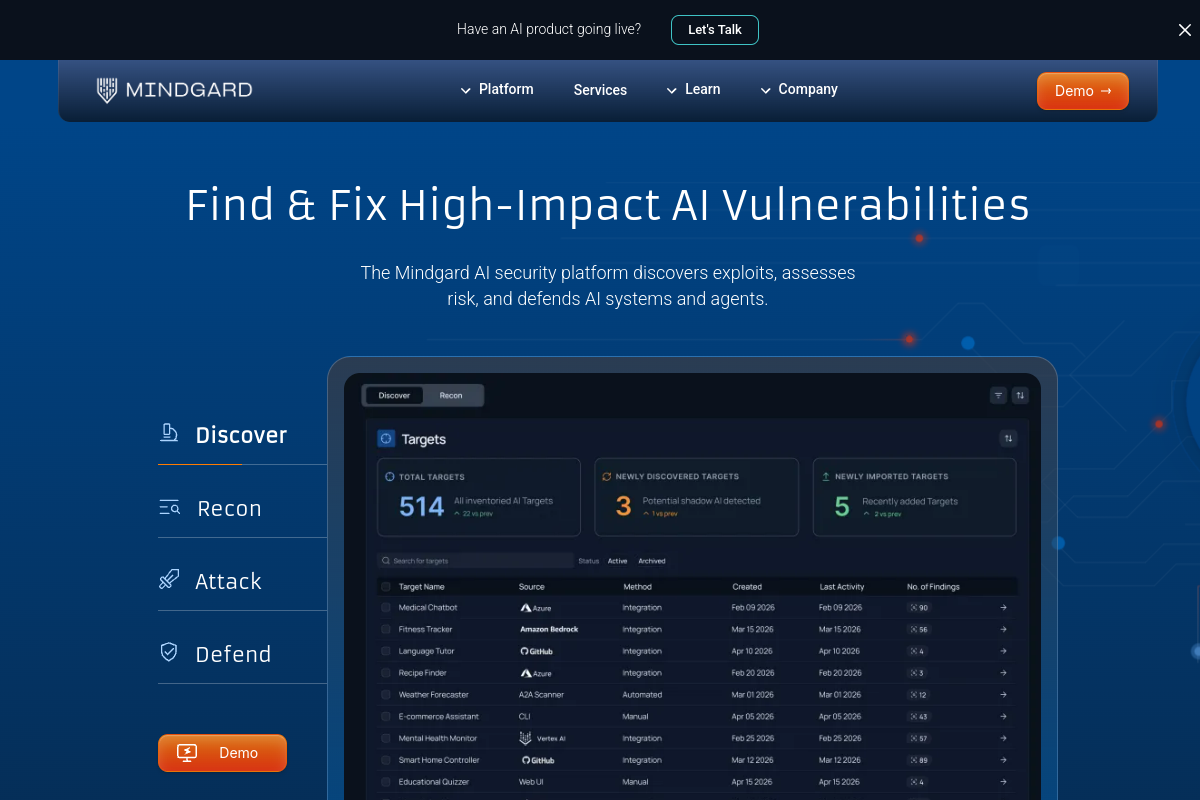
Mindgard 面向部署模型、智能体和 AI 应用的企业团队,帮助发现 AI 攻击面、执行对抗性安全测试,并定位可利用的安全弱点。
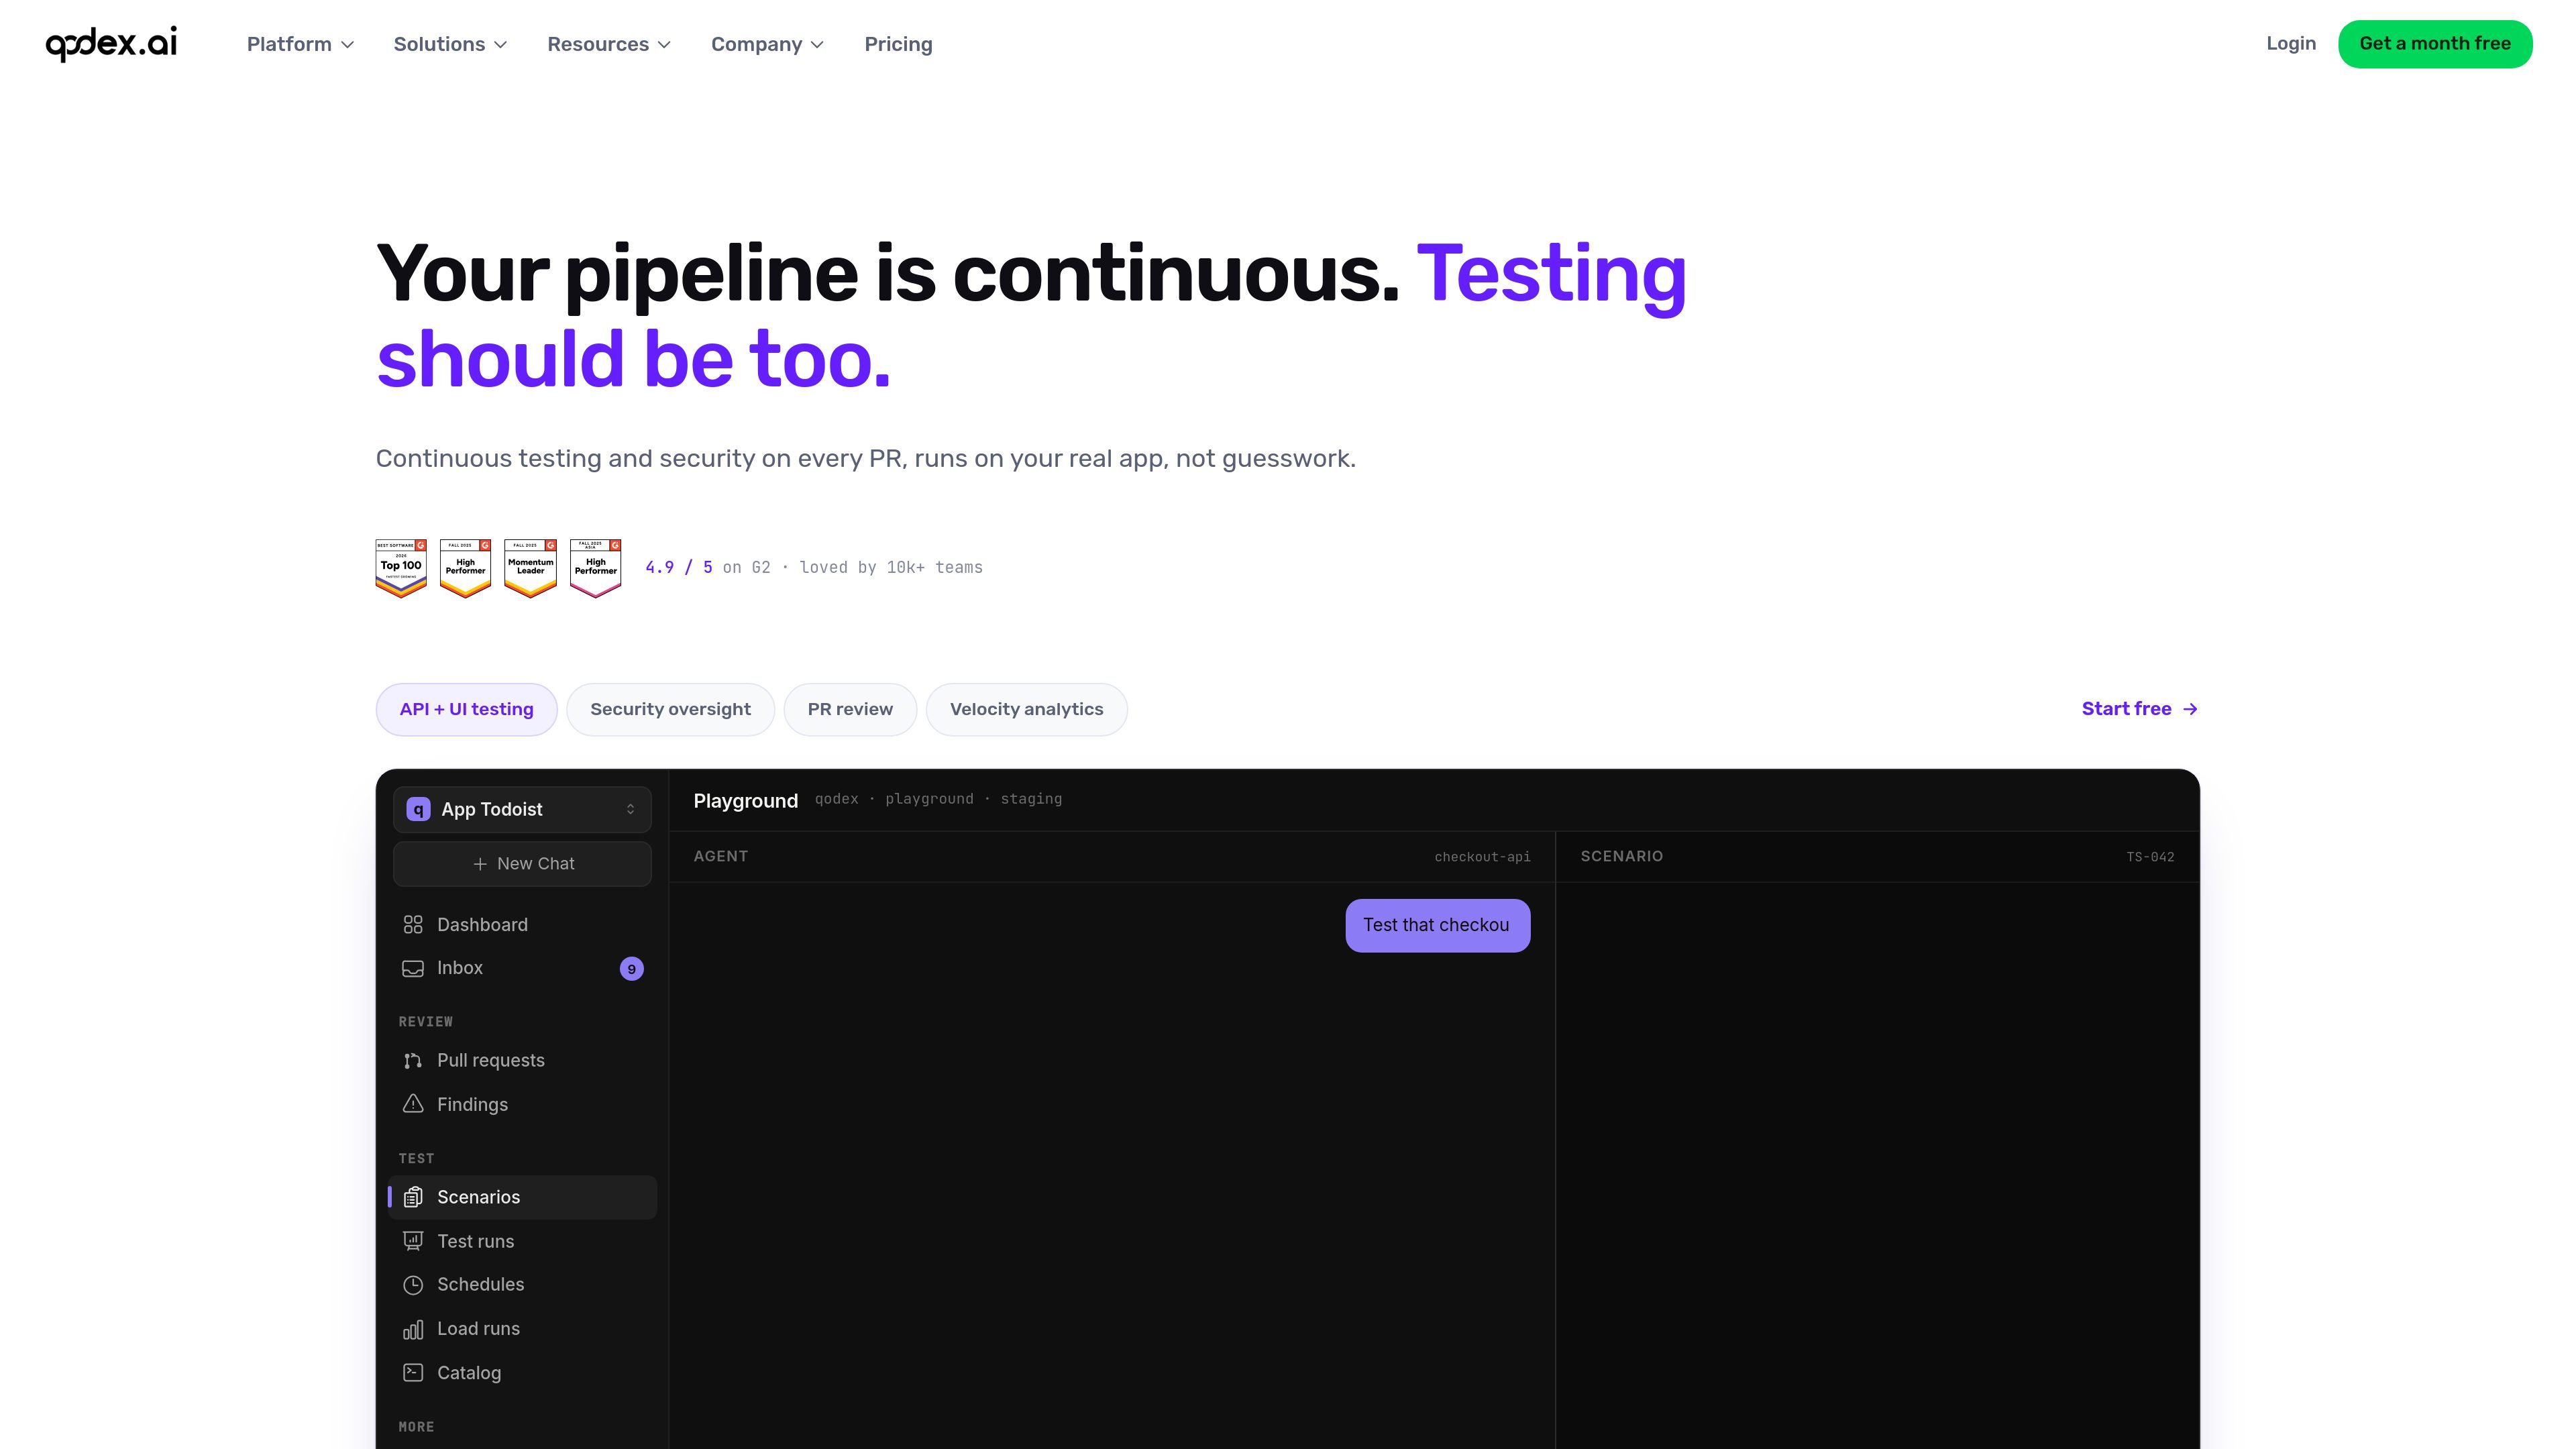
持续测试平台,让工程、QA 和安全团队在 PR 与部署中运行真实场景
AI开发者工具
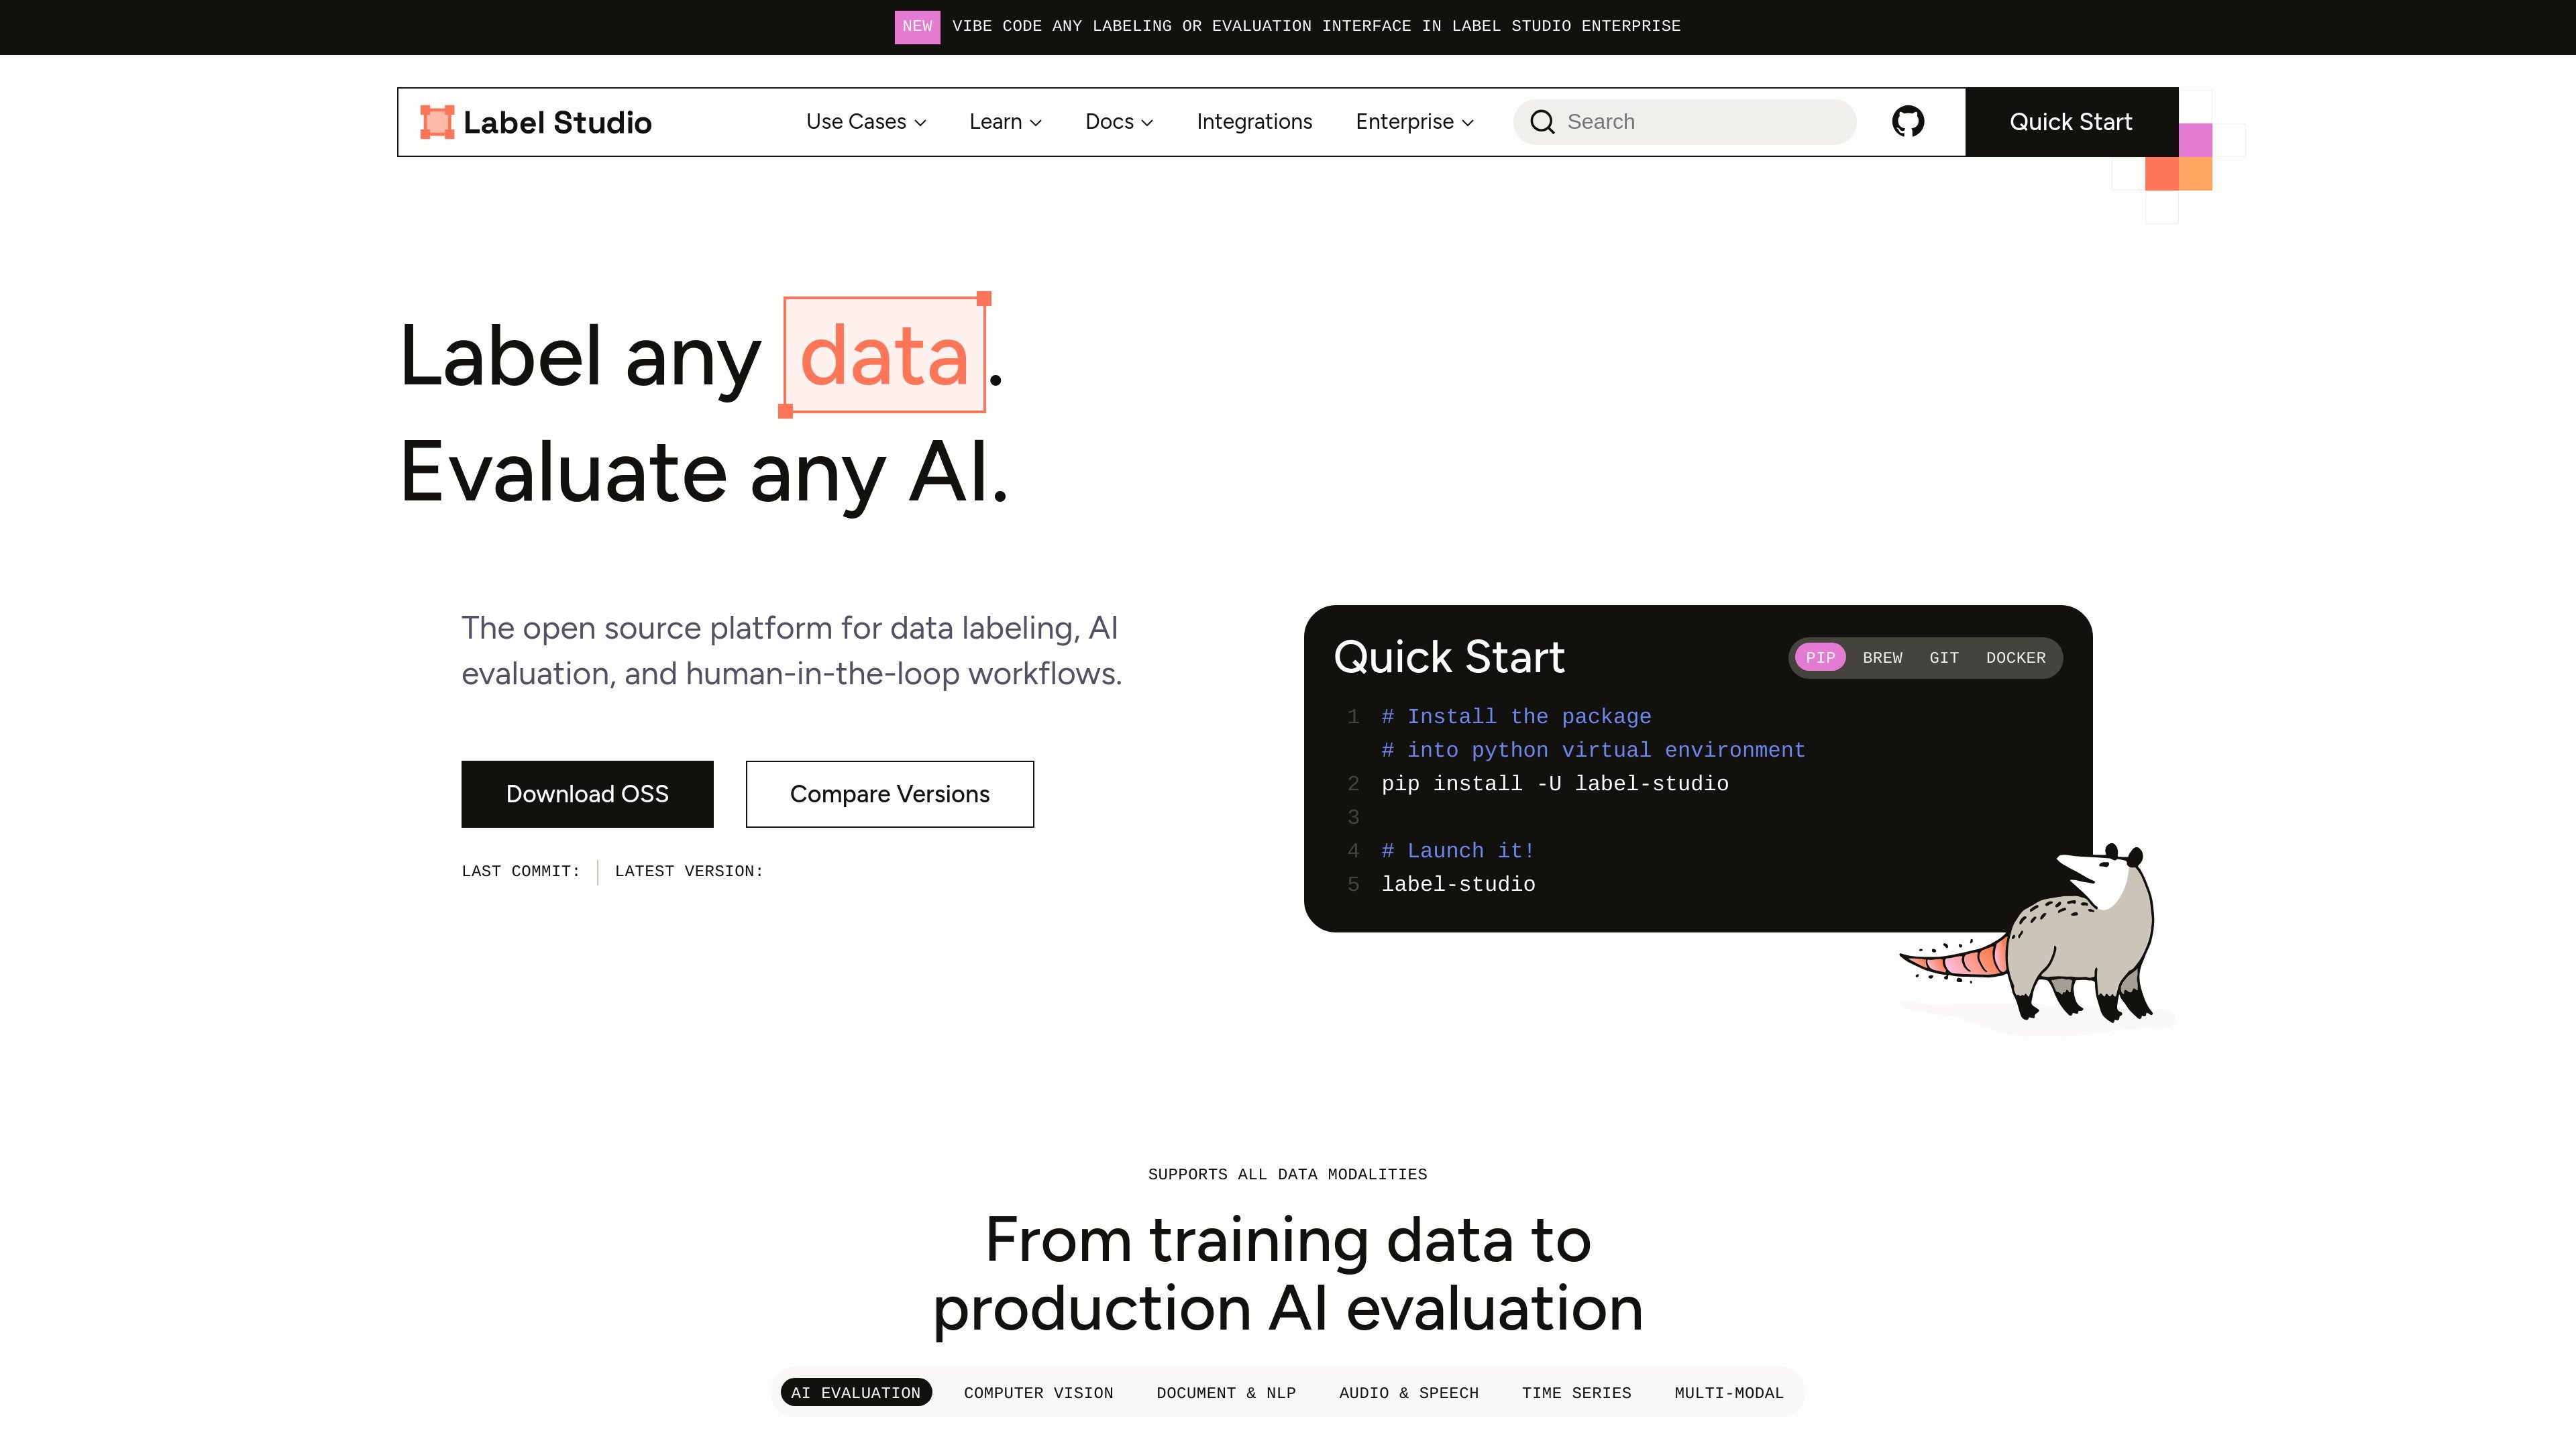
开源数据标注与 AI 评估平台
AI编程助手
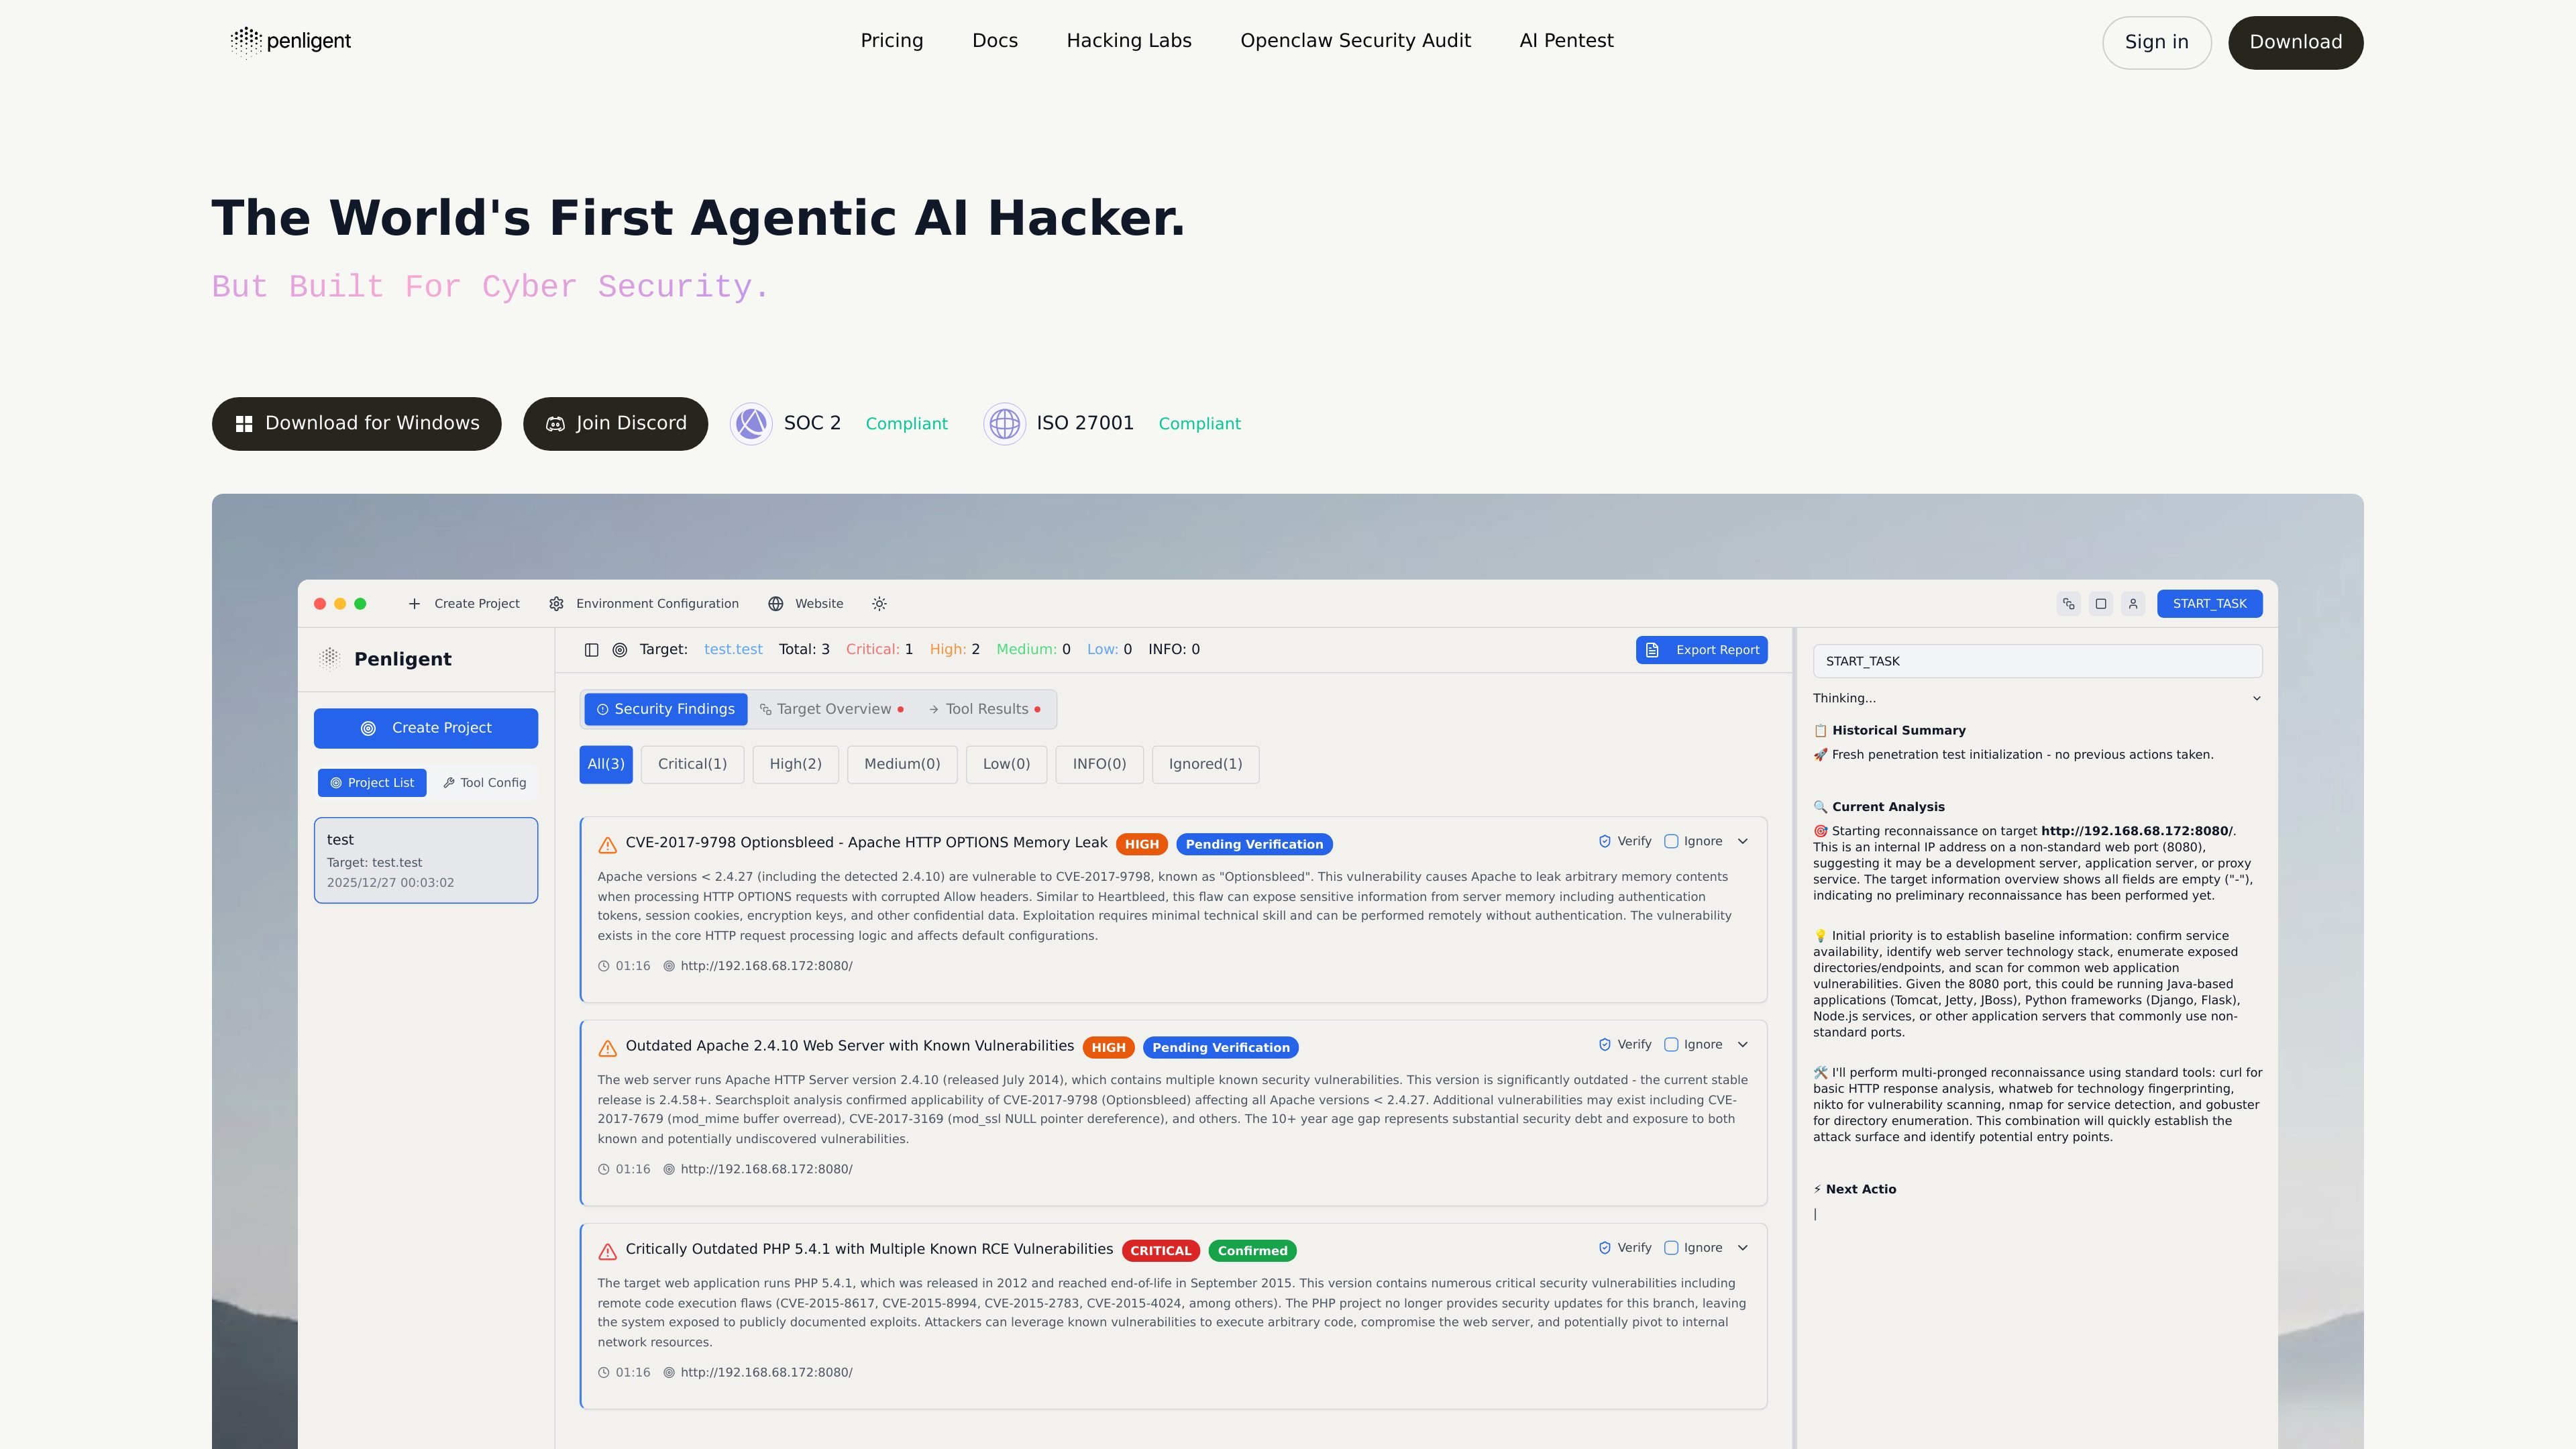
Penligent 是面向安全团队、渗透测试人员和红队的 AI 辅助渗透测试平台,可自动完成 Web 应用、API、业务逻辑及 AI 代理的发现、验证、漏洞利用复现和基于证据的报告生成。
用于代码审查和应用安全的 AI 工具,可发现拉取请求中的可利用漏洞
面向 AI 智能体团队的 GenAI 评测与可观测性平台
基于云的 AI 端到端测试平台,用自然语言在真实浏览器中创建并运行测试
AI 可观测性
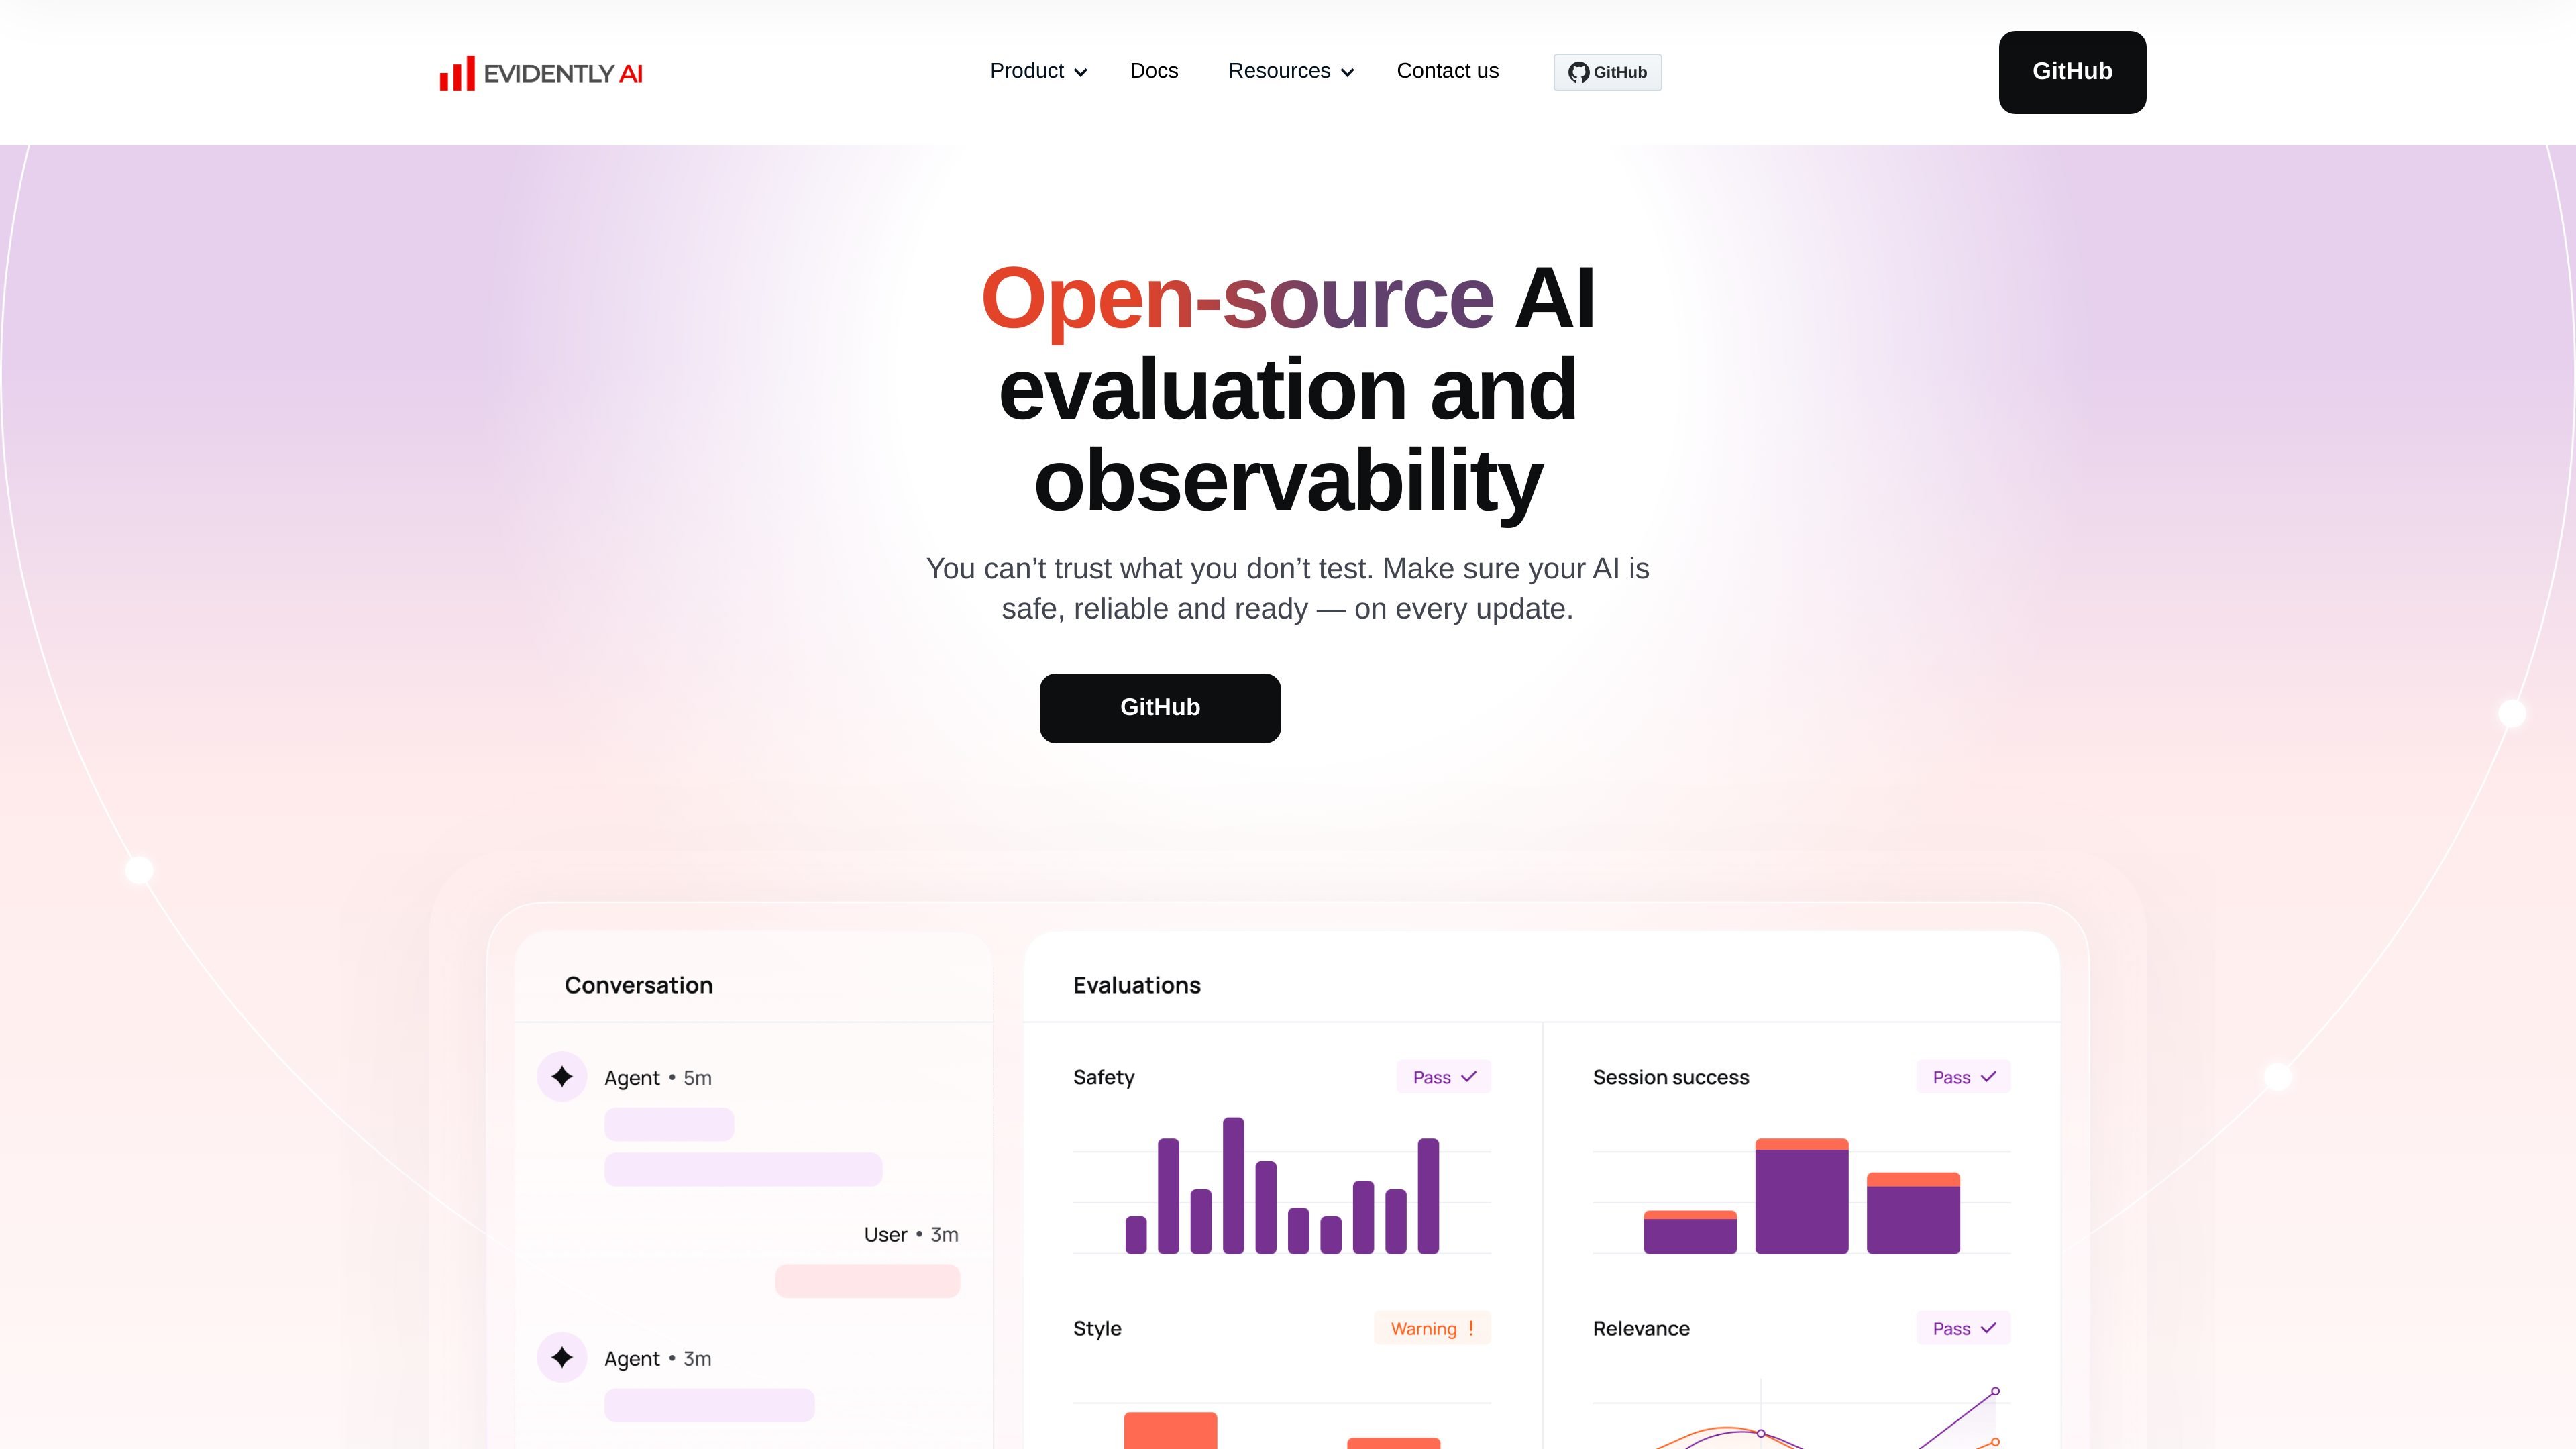
Evidently AI 是一个开源框架,用于评估、测试和监控大语言模型应用、RAG 系统、AI 智能体及预测型机器学习模型。团队可结合内置指标与自定义规则检查输出质量、安全性和可靠性,并通过报告与监控视图跟踪部署后的变化。
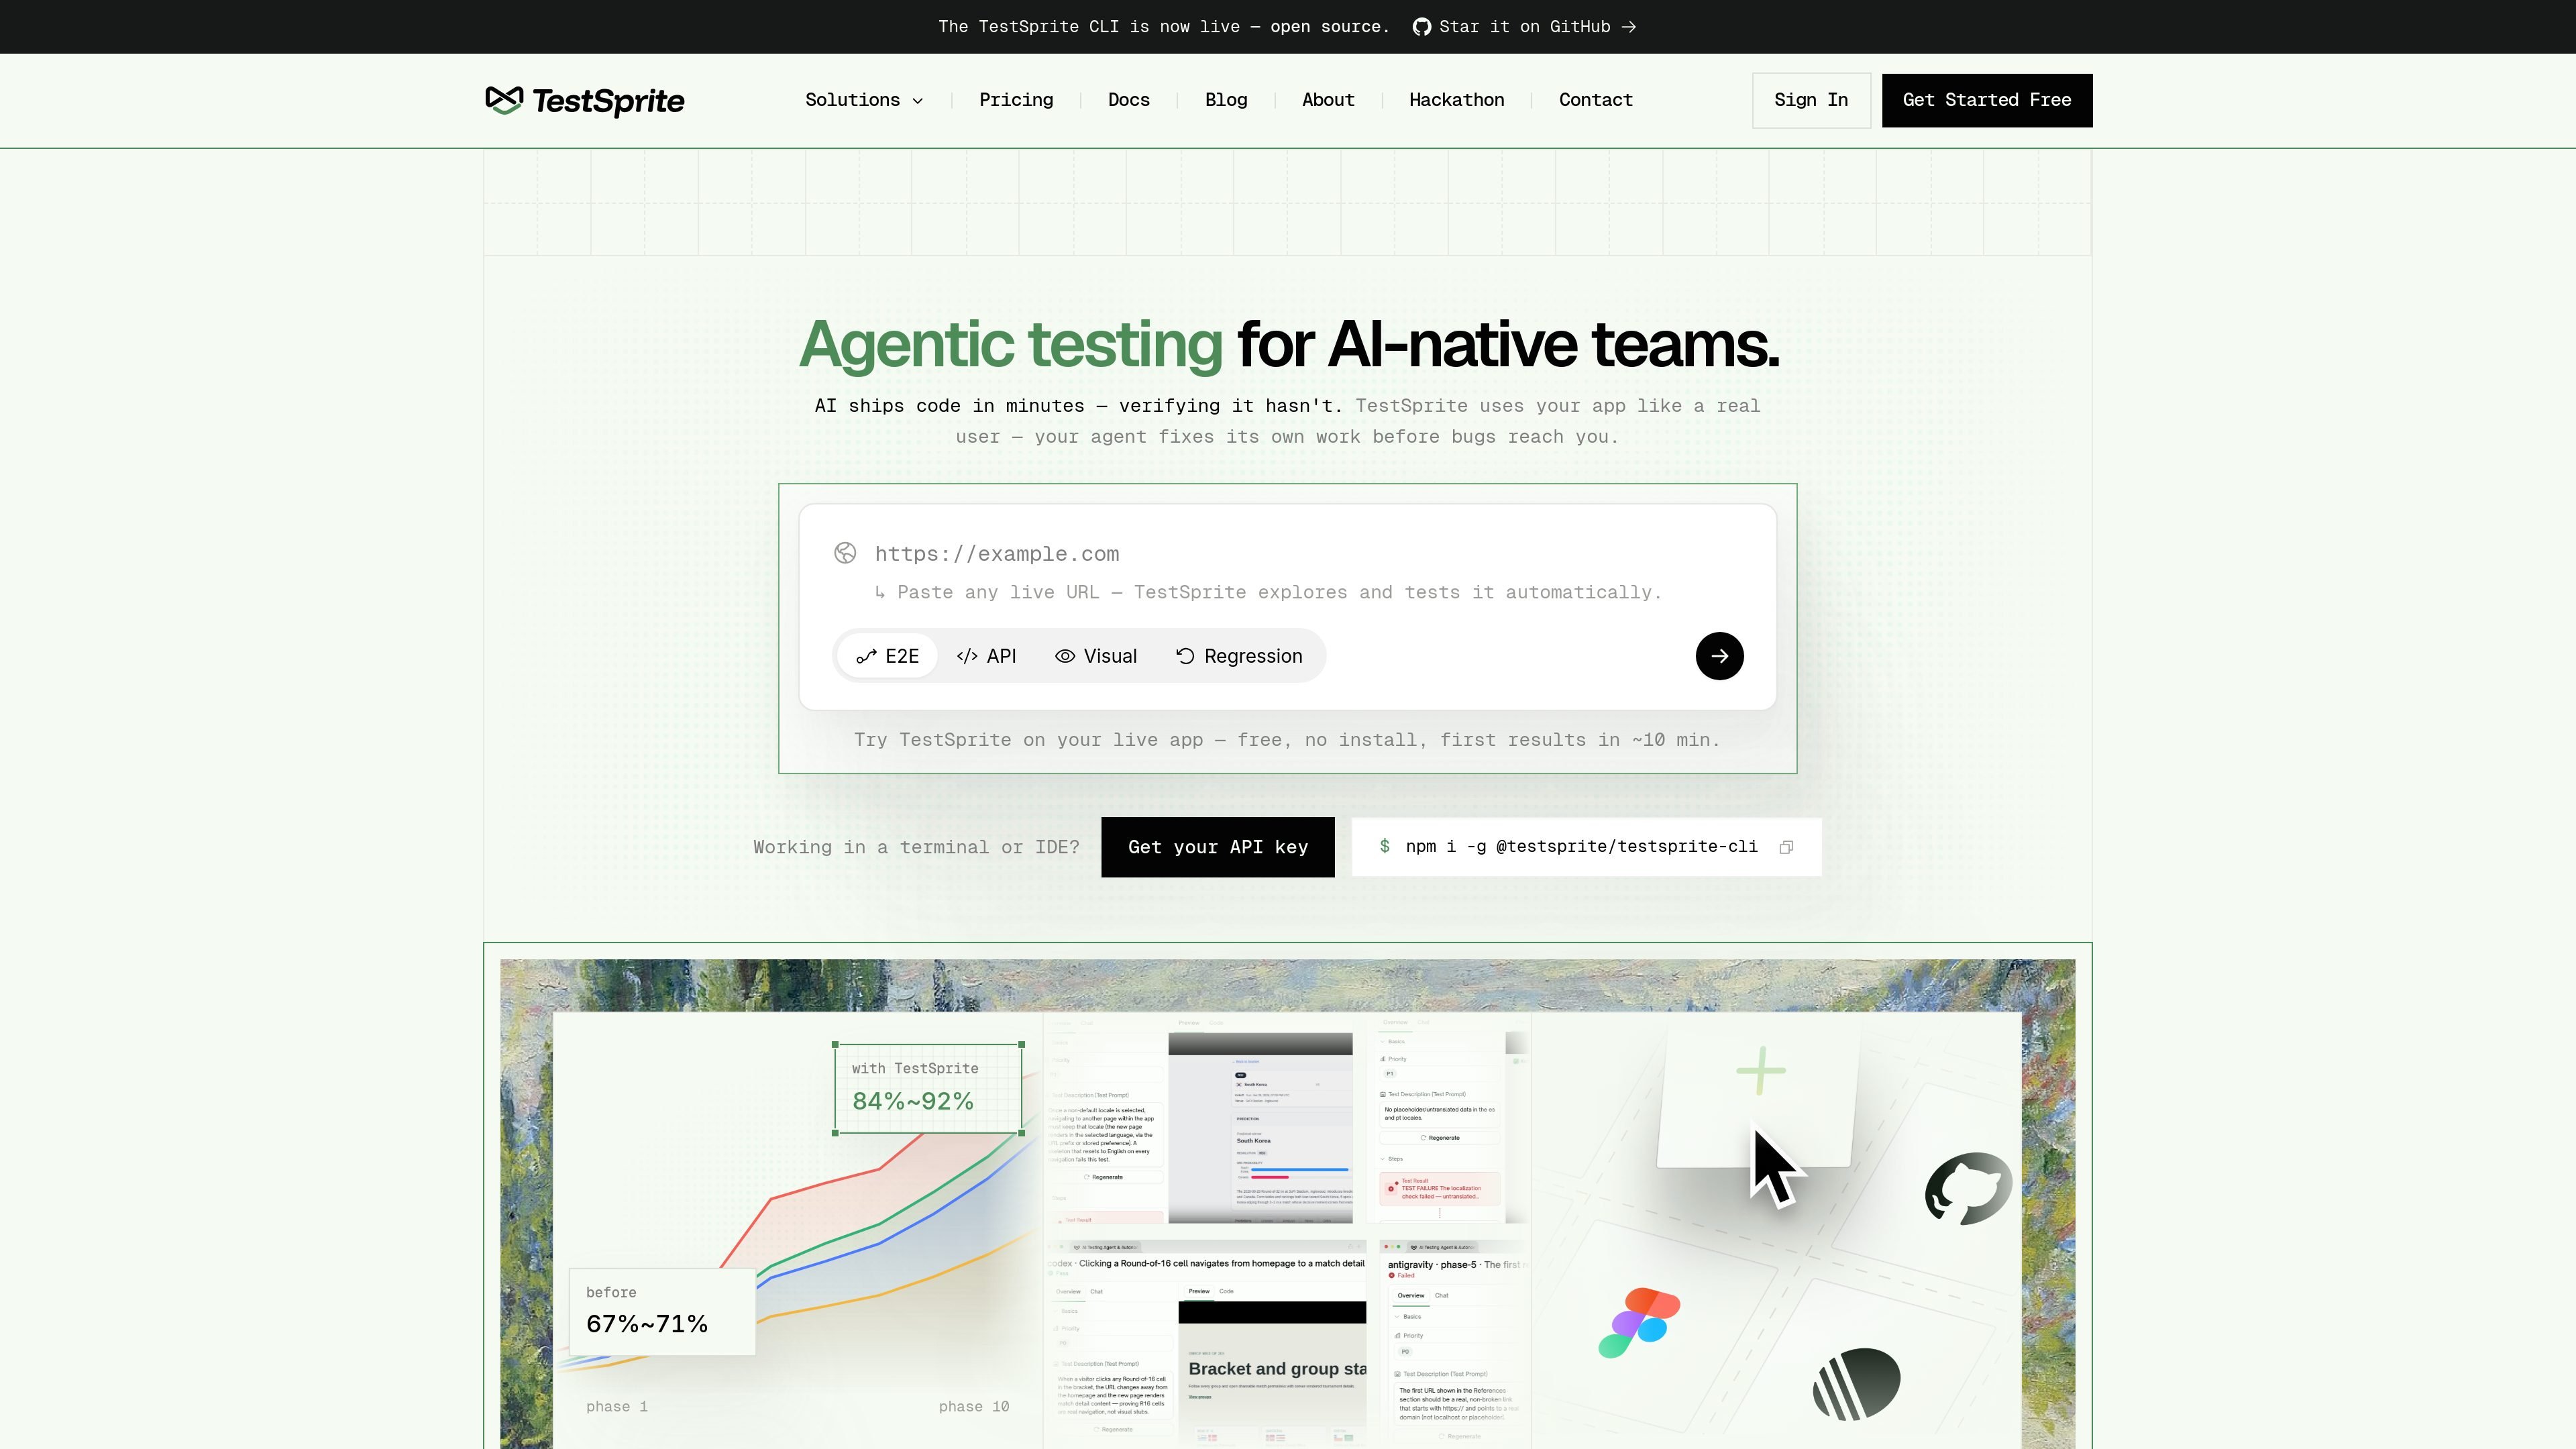
TestSprite 面向开发者和软件团队,利用 AI 探索运行中的应用,生成并执行前端与后端端到端测试,并提供故障证据。可通过 CLI、IDE、CI 或浏览器控制台验证代码变更,并保留通过的测试以积累回归覆盖。
Promptfoo 是一个用于评估大语言模型应用、智能体、模型及工作流的 AI 安全与测试平台,帮助开发者和安全团队发现漏洞、验证防护措施并跟踪修复。
Galileo 是一个用于测试、调试和治理大语言模型及智能体系统的 AI 可观测性与评估平台,覆盖开发和生产环境,帮助团队将评估结果转化为生产防护措施,并规模化监控 AI 行为。
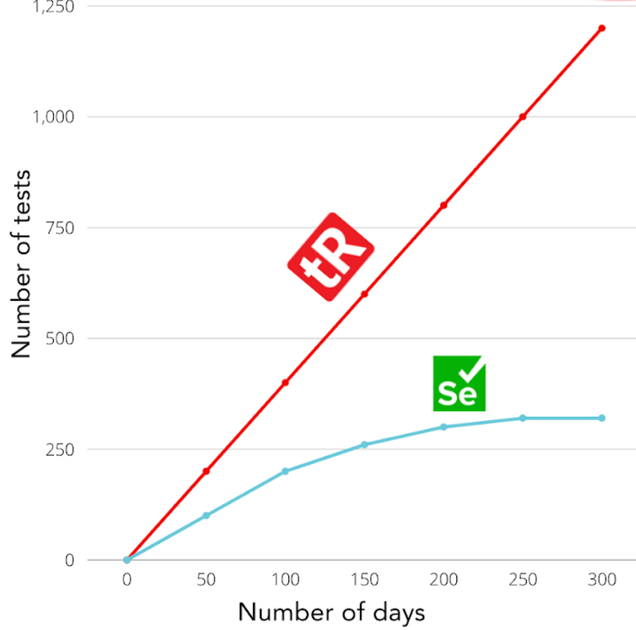
testRigor 面向软件和 QA 团队,将日常英语说明或现有手工用例转换为可编辑、可执行的端到端测试,覆盖网页、移动应用、API、邮件和消息流程。
面向 Web、移动端、AI 应用和 API 的智能测试自动化平台
DeepEval 是一个开源的大语言模型评测框架,用于测试和基准评估 AI 应用,支持基于 pytest 的评测、输出与智能体轨迹评分,以及文本、图像、音频和语音工作流迭代。
Testim 面向 Web、移动端和 Salesforce 应用,支持录制操作流程、编辑测试步骤、添加结果验证并运行端到端测试。
Hoplite 是一个编码代理平台,可在隔离的开发环境中运行任务,并在任务完成后创建 pull request。它面向希望将代码仓库工作委派给代理,并通过实时反馈和审批进行协作的团队。
Coarena 是一个计算机使用竞技场,可发布真实浏览器任务,实时观看两款前沿 AI 智能体完成任务,并以盲评方式判定胜者。同时提供用于计算机使用评测的基准指标、偏好标签和数据集访问权限。
用于提示词和智能体工作流版本管理、测试与监控的平台
Confident AI 是面向工程师、QA 团队和产品负责人的 AI 质量平台,可测试、监控并改进 AI 系统。