AI推論プラットフォームを比較し、機械学習モデルのデプロイや本番運用に役立つAPI、GPU、監視、性能最適化の製品を探せます。
カタログ更新日:2026/11/19
AIゲートウェイとルーティング
AIMLAPIは、複数プロバイダーのチャット、画像、音声、動画、検索、コードなどのモデルを、1つのAPIと請求キーで利用できるプラットフォームです。開発者やチームがモデルを比較し、アプリケーションに組み込むために利用できます。
AI推論プラットフォーム
Clouderaは、パブリッククラウド、データセンター、エッジにまたがる企業向けのデータ・AIプラットフォームです。データパイプライン、分析、ストリーミング、プライベートAIを、共通のセキュリティとガバナンスで支援します。
Chutesは、オープンソースAIモデルを実行する分散型サーバーレス推論基盤です。API経由でホスト済みモデルを利用できるほか、機密性を備えたGPU環境に独自の処理を非公開でデプロイできます。
SGLangは、大規模言語モデルやマルチモーダルモデル向けのオープンソース推論・サービングフレームワークです。開発者はモデルサーバーを構築し、OpenAI互換エンドポイント経由でアプリケーションから利用できます。
開発者向けの統合APIで、複数プロバイダーの生成AIやOCR・音声・翻訳などのモデルを比較・選択し、アプリケーションの要件に応じて柔軟に切り替え・ルーティングできます。
SambaNovaは、大規模なオープンソースモデルやエージェント型ワークロードを提供・運用するためのAI推論プラットフォームです。開発者や企業、インフラ運用者は、クラウドサービスまたは導入可能なハードウェアとソフトウェアを使い、クラウド、オンプレミス、ハイブリッド、エアギャップ環境で利用できます。
Rekaは動画・画像・音声・テキストに対応するマルチモーダルAIプラットフォームで、ビジュアル検索、推論、学習データ生成を支援します。
PiAPIは、動画・画像・音声・3Dアセット・LLMモデルを共通インターフェースで利用できる生成AIプラットフォームです。開発者やAIエージェント、業務自動化のワークフローに対応します。
Bentoは、AI・機械学習モデルを本番環境でパッケージ化、デプロイ、最適化、運用するための推論プラットフォームです。自社クラウド、オンプレミスのKubernetes、Bento Cloudでオープンソースモデルやカスタムモデルを提供できます。
each::labsは、動画・画像・音声・テキスト向けの600以上のAIモデルを単一APIで利用できるオーケストレーション基盤です。ルーティング、フォールバック、可観測性を備え、本番AIアプリケーションの構築・運用を支援します。
Rayは、Pythonアプリケーションを分散実行・拡張するオープンソースのフレームワークです。データ処理、モデルの学習・推論・提供、強化学習などの計算負荷の高い処理を、手元の環境から大規模なGPUクラスターまで実行できます。
Hyperstackは、AI・機械学習のトレーニングや推論、データ分析、モデル開発に使えるクラウドGPU基盤です。GPU仮想マシンやAI Studio、マネージドKubernetesで、計算負荷の高いワークロードを運用できます。
FriendliAIは、オープンウェイトモデルやカスタムAIモデルを本番環境で提供するための推論クラウドです。サーバーレスAPI、専用GPUエンドポイント、BYOGに対応し、エージェントやマルチモーダルの推論に利用できます。
Inference.netは、本番環境でAIモデルを運用するチーム向けの基盤です。モデルのデプロイ、LLMの可観測性、トレース、継続的な評価、ファインチューニングを一つのワークフローで行えます。
Cerebriumは、リアルタイムAIワークロードをデプロイ・実行するためのサーバーレスCPU・GPU基盤です。AIアプリを運用するチームは、固定容量やKubernetesを管理せずに、需要に応じて計算資源を拡張できます。
AI動画生成
Prodiaは、動画生成に特化したマルチシリコン推論プラットフォームです。複数のハードウェア環境向けにAIモデルを実装し、コスト、出力品質、性能のバランスを目指します。
AIエージェント基盤
機密データを管理下に置いたまま、組織がモデルやエージェントを活用できる主権型AI基盤とツール。規制産業やデータに配慮が必要な企業向けです。
エンタープライズ推論向けAIアクセラレーターとサーバー
SambaNova Cloudは、オープンソースの言語・ビジョンモデルにAPIでアクセスできる推論プラットフォームです。開発者は、OpenAI互換APIやブラウザのプレイグラウンドでAIアプリケーションを構築・検証できます。
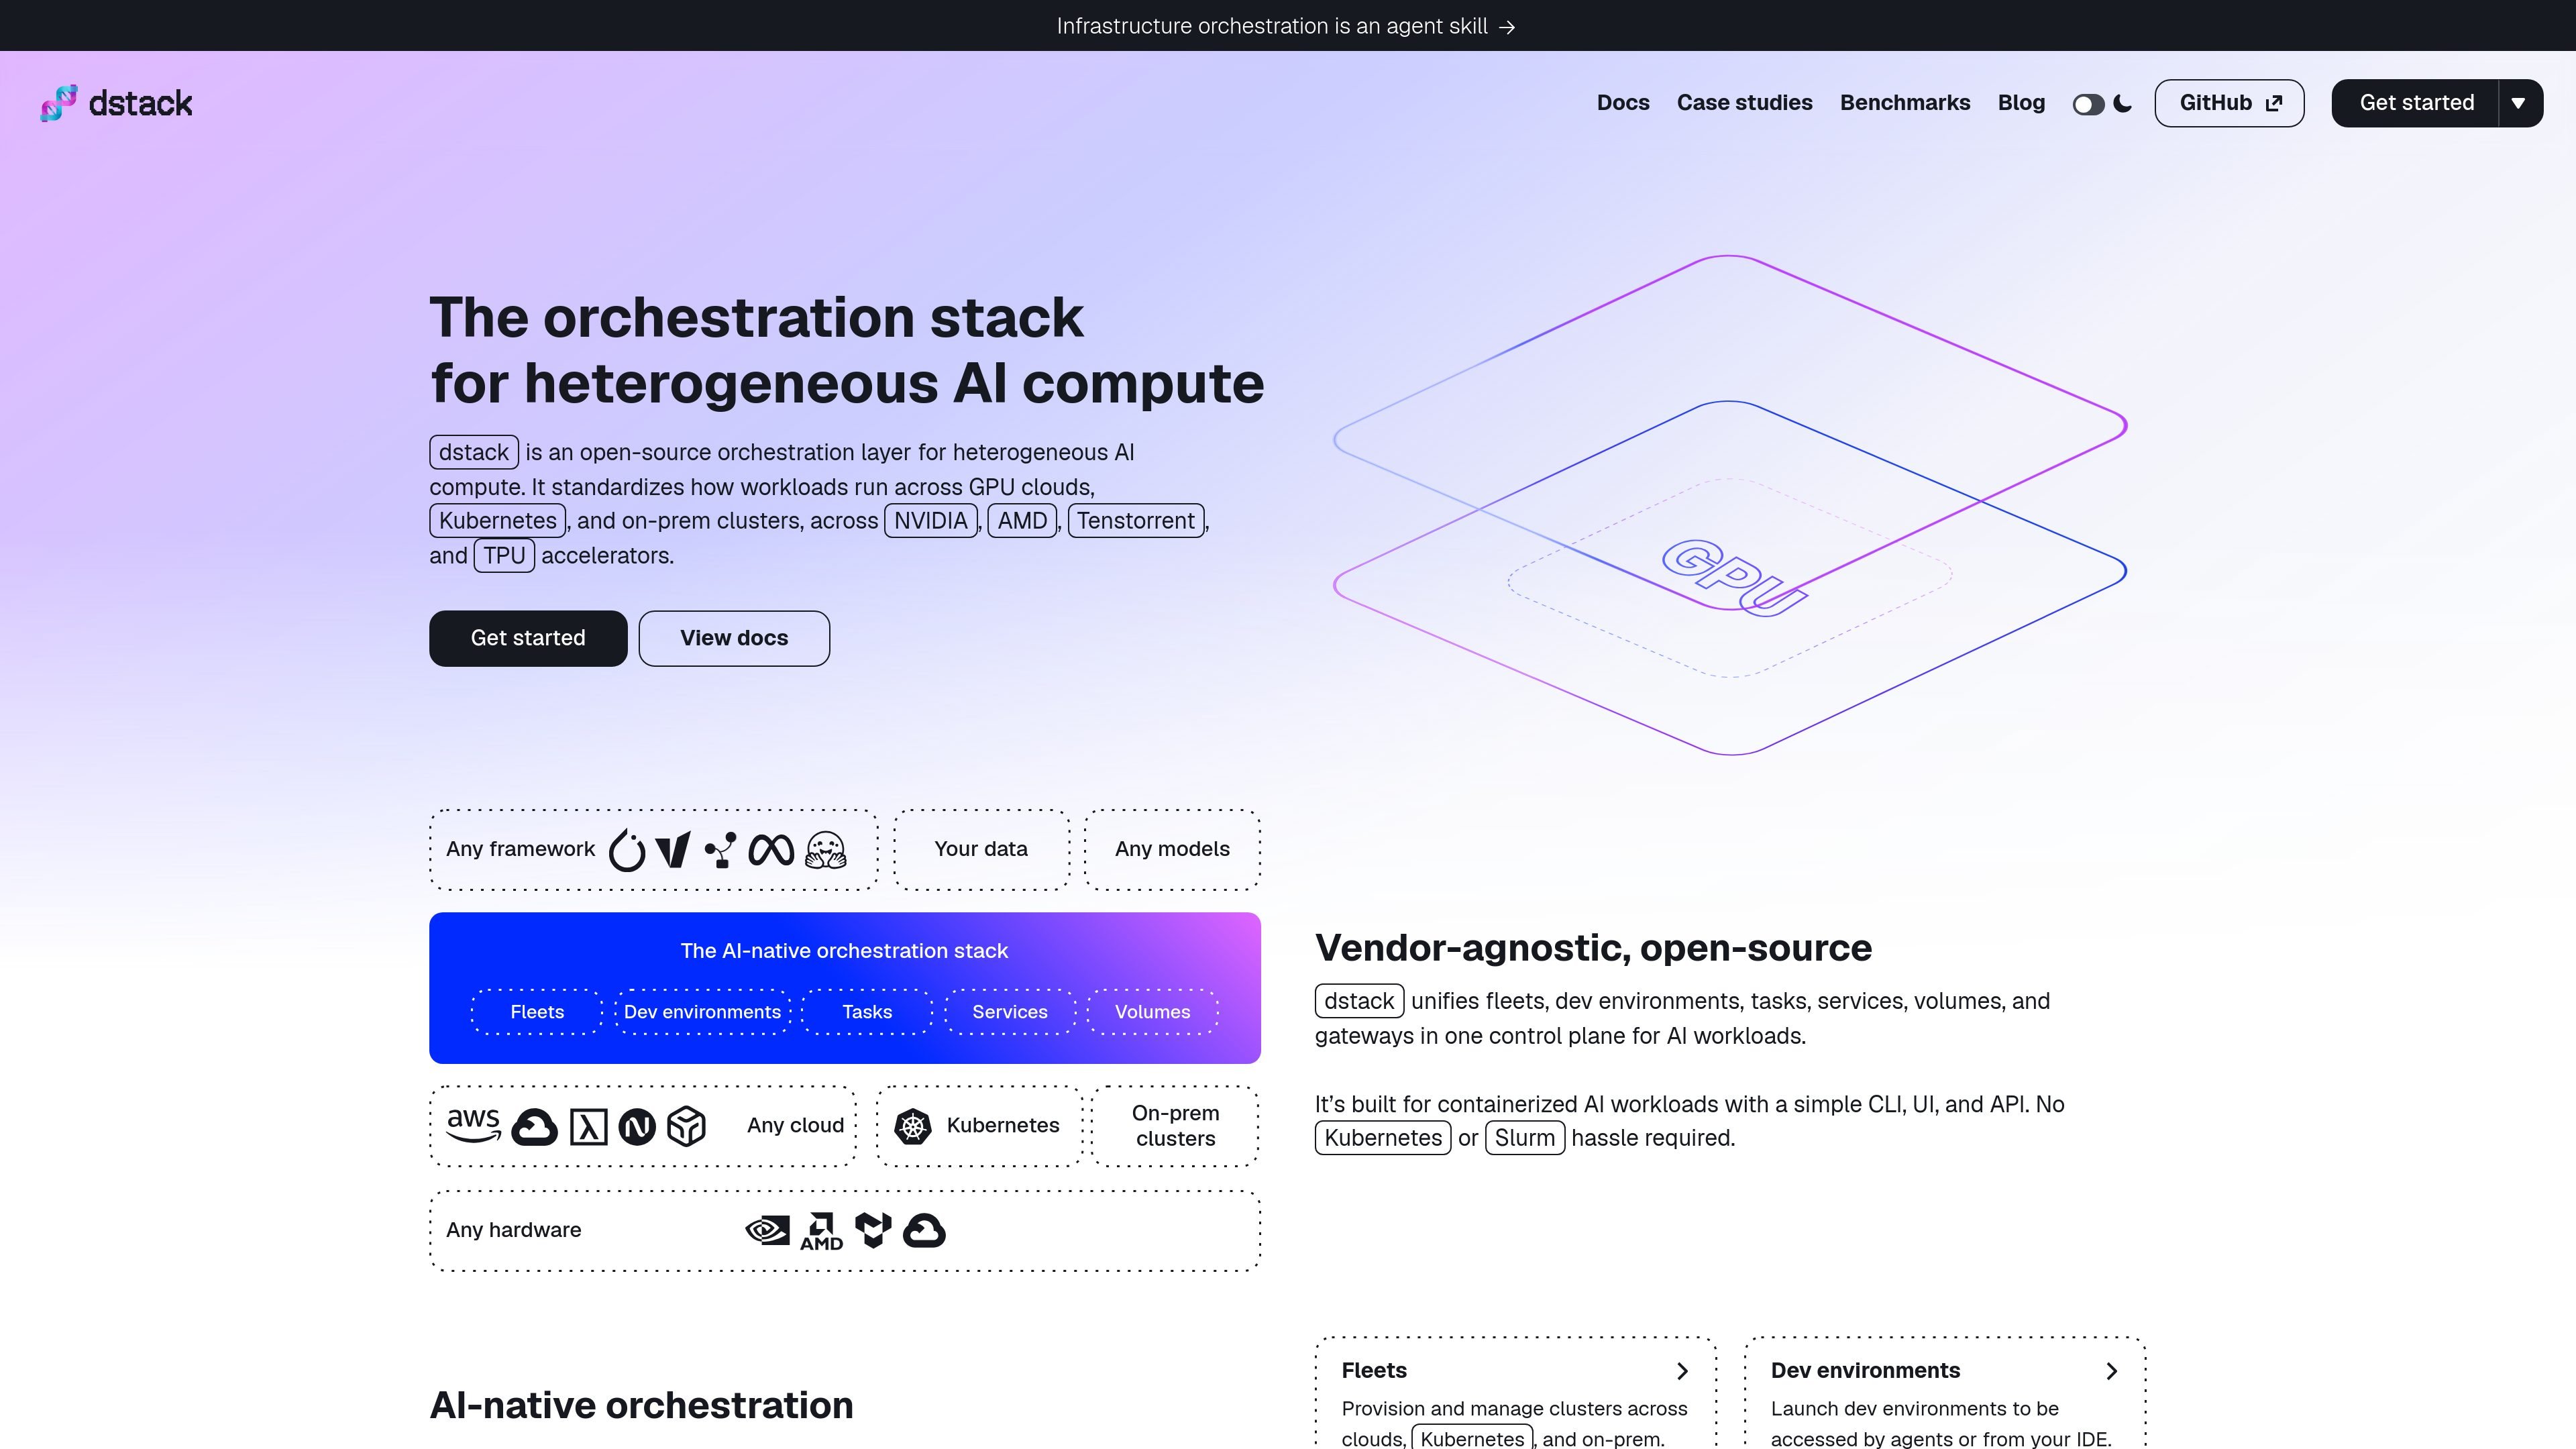
GPUクラウド、Kubernetes、オンプレミス環境を統合し、GPUワークロードのプロビジョニングと実行を調整するコントロールプレーンです。YAML設定をCLIまたはAPIから適用できます。