
向量与混合搜索
执行近似最近邻向量搜索,文档化召回率超过 90%;还可将稠密或稀疏向量搜索与全文搜索策略结合使用。

turbopuffer 是一款原生支持对象存储的搜索引擎,支持向量、全文、混合及正则表达式搜索,帮助 AI、搜索和数据团队通过过滤、排序及可扩展的命名空间存储,从大型文档集合中检索内容。
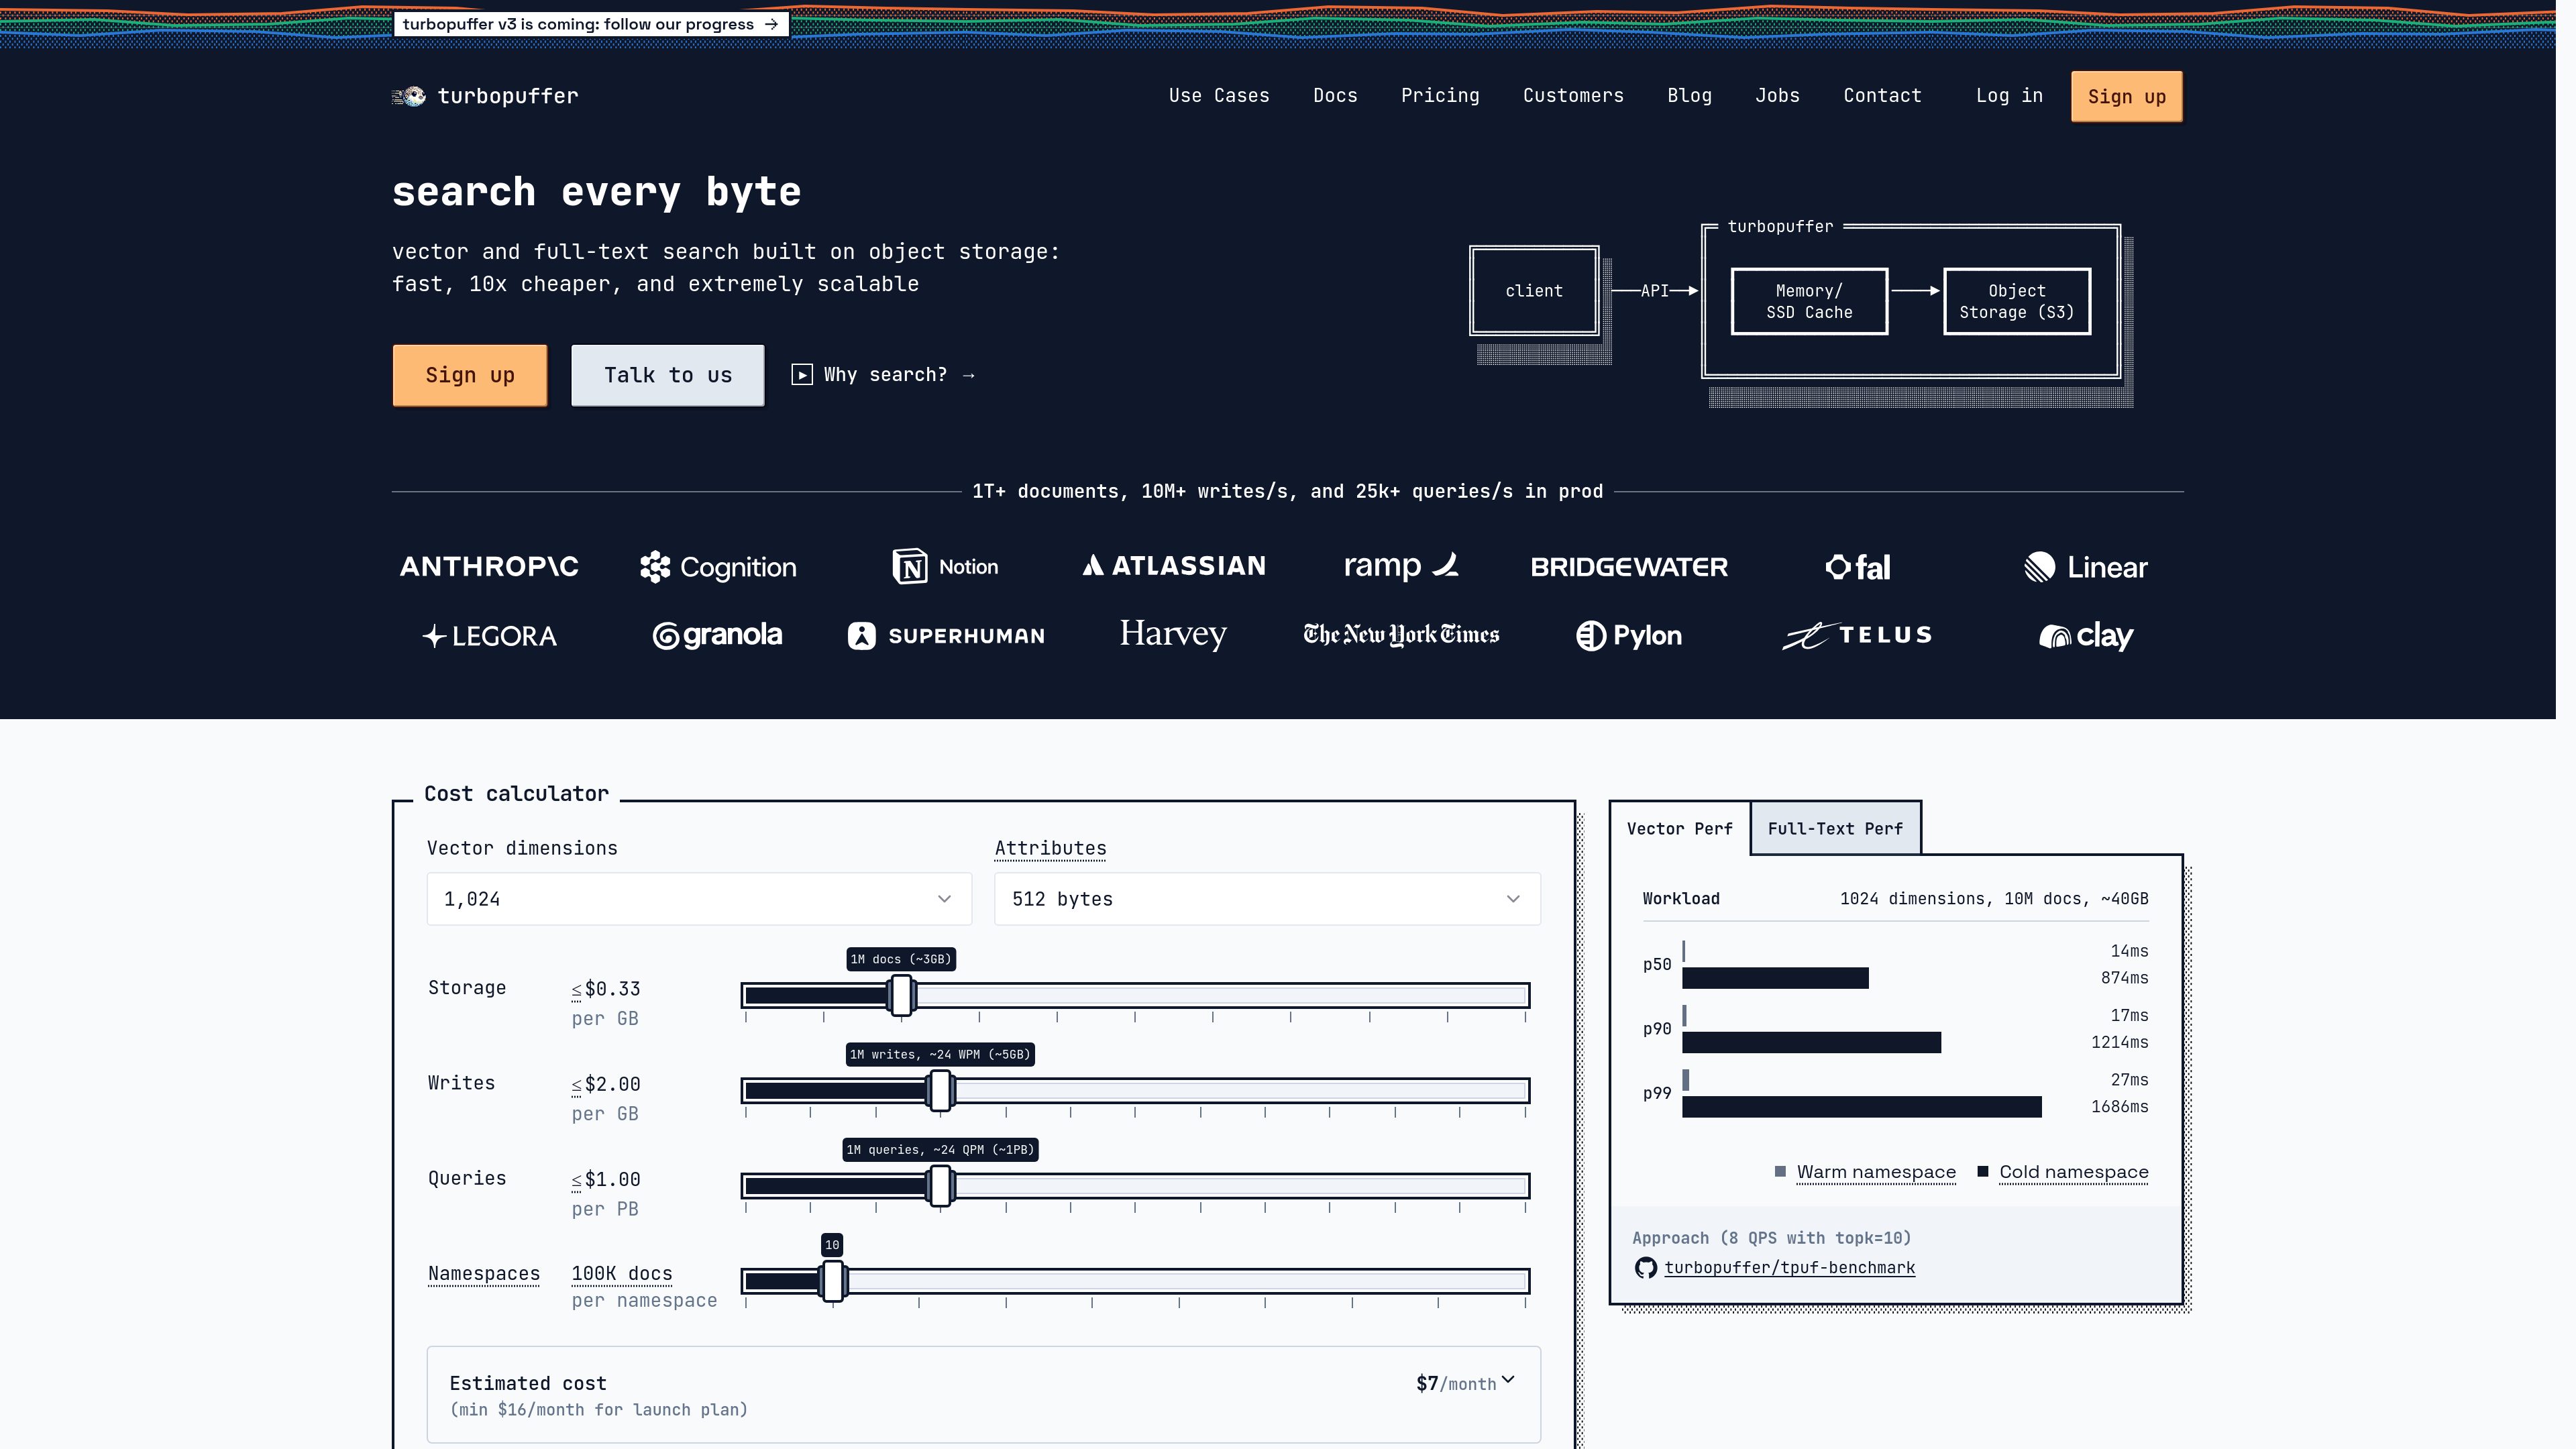
turbopuffer 是一款托管式、原生支持对象存储的搜索引擎,支持向量、全文、混合及正则表达式搜索。它将对象存储作为持久化状态的可靠来源,并使用内存和 NVMe SSD 缓存执行查询,因此应用无需将整个索引保留在内存中,也能搜索大型集合。
该服务支持元数据过滤、排序、加权、文档查找及基于命名空间的组织方式。它适用于搜索文本、图像、视频、网页、智能体记忆及其他已建立索引的数据。文档化 API 包含创建、更新和删除文档的操作,以及支持过滤器和排序的查询。
其架构面向大规模工作负载设计:该网站称,生产系统可处理超过 1 万亿份文档、每秒 1,000 万次写入和每秒 25,000 次查询。文档中列出的权衡包括:直接写入对象存储会带来更高的写入延迟;对于未缓存或未固定的数据,偶发查询的速度会更慢。
执行近似最近邻向量搜索,文档化召回率超过 90%;还可将稠密或稀疏向量搜索与全文搜索策略结合使用。
使用倒排索引、BM25 排序和加权搜索文本。快速三元组正则表达式索引支持基于模式的检索,并可与关键词和语义搜索结合使用。
查询文档时应用元数据过滤器,然后使用排序和加权控制匹配结果的排列顺序。
使用对象存储保存持久化状态,并使用内存或 NVMe SSD 缓存执行计算。该架构旨在支持超大型文档集合和高吞吐工作负载的扩展。
使用命名空间组织数据,实现多租户或面向特定应用的隔离。写时复制分支可在恒定时间内创建命名空间克隆,同时使后续读写彼此独立。
定价层级显示,各方案均支持多租户部署;Enterprise 提供单租户和 BYOC 选项。更高层级可用的控制项包括 SSO、审计日志、私有网络和按命名空间配置的 CMEK。
为智能体提供语义搜索和全文搜索工具,使其能在任务执行期间检索相关文档、网页内容、记忆、推理记录、工具调用或评估数据。
为大型文档和多媒体文件集合建立索引并进行过滤,帮助应用为用户定位少量相关记录、文件或媒体资源。
构建由新闻、论文或更广泛网页内容索引支持的搜索工具,使智能体和应用能够从持续维护的语料库中检索内容。
使用语义相似度搜索,将文章、产品或其他内容与用户点赞或互动过的项目进行匹配。
整理大规模数据集,供模型预训练或后训练,并通过强化学习工作流进行搜索。
根据文档,该产品支持向量搜索、BM25 全文搜索、结合向量与全文搜索策略的混合搜索、元数据过滤,以及使用三元组索引的正则表达式搜索。
对象存储是持久化状态的可靠来源,内存和 NVMe SSD 缓存则为查询提供计算能力。缓存数据可实现较低延迟;未缓存或未固定的命名空间可能产生较慢的冷查询。
直接写入对象存储会增加写入延迟;文档给出的 512 KB upsert p90 延迟为 248 毫秒。未缓存或未固定的数据也可能出现偶发的冷查询延迟;在一个包含 100 万份文档的示例中,文档化的 p90 延迟为 1,214 毫秒。
应用可以将数据分隔到不同命名空间中。列出的方案默认支持多租户部署,而 Enterprise 还提供单租户和 BYOC 部署选项。写时复制分支可以创建相互独立的命名空间副本。
定价页面列出了 Launch、Scale 和 Enterprise 方案。Launch 起步价为每月 16 美元,Scale 起步价为每月 256 美元,Enterprise 起步价为每月 4,096 美元。Enterprise 还提供单租户、BYOC、私有网络和服务级别承诺等部署与支持选项。