
分页 SSD KV 缓存
以 safetensors 格式存储 KV 缓存块,将高频访问的缓存块保留在 RAM 中,并根据 LRU 策略将较少访问的缓存块移至 SSD。缓存的前缀可以在不同请求之间以及服务器重启后恢复。
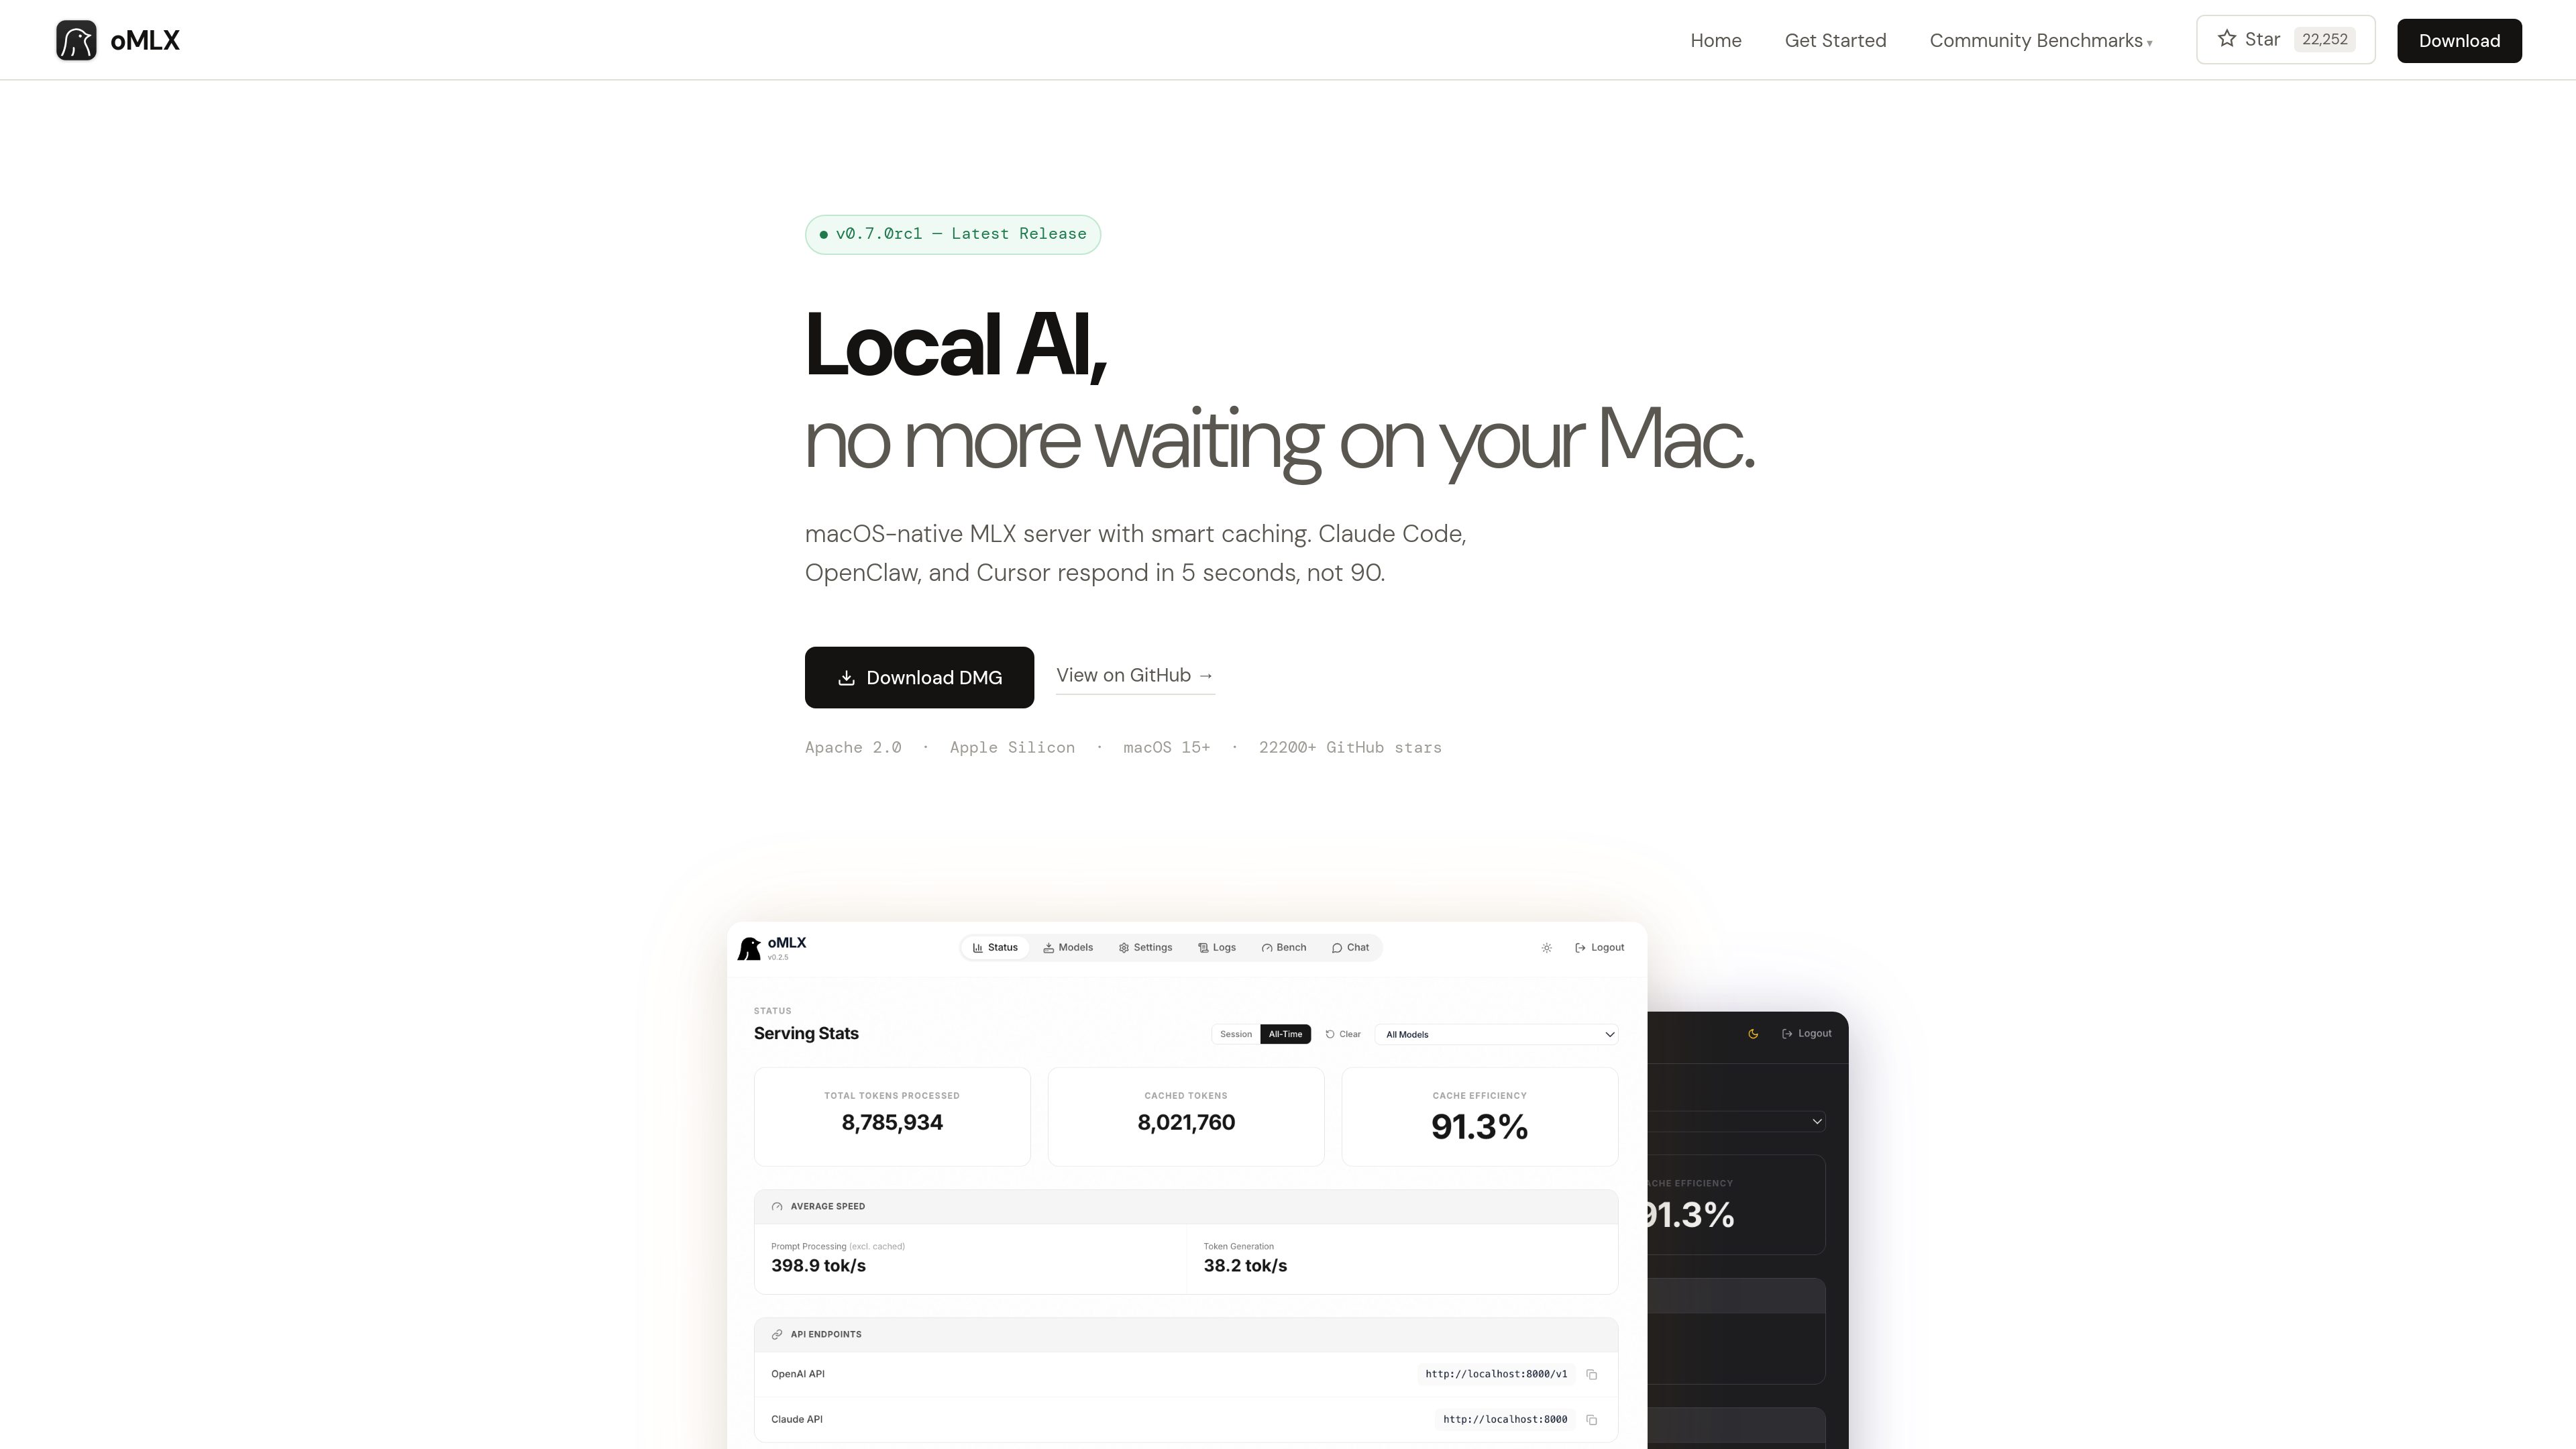
oMLX 是一款基于 MLX 构建的原生 macOS 推理服务器,用于在 Apple Silicon 上本地运行 MLX 格式的 AI 模型。它提供用于管理模型、与模型聊天以及监控服务器指标的控制面板,同时支持 LLM、视觉语言、嵌入和重排序模型。
该产品尤其适用于编码代理会话,因为这类会话中的对话上下文会反复变化。其分页 SSD KV 缓存可以在请求之间以及服务器重启后保留缓存块,从而减少对之前已处理前缀的重复计算。
以 safetensors 格式存储 KV 缓存块,将高频访问的缓存块保留在 RAM 中,并根据 LRU 策略将较少访问的缓存块移至 SSD。缓存的前缀可以在不同请求之间以及服务器重启后恢复。
使用 mlx-lm 的 BatchGenerator 处理并发请求,而不是严格地一次处理一个请求。该网站在其公布的基准测试中报告称,在八路并发下,生成速度最高提升 4.14 倍。
可同时加载 LLM、视觉语言、嵌入和重排序模型,并在内存不足时使用 LRU 驱逐机制。用户可以通过管理控制面板浏览和下载模型。
提供 `/v1/chat/completions` 和 `/v1/messages` 端点,供兼容客户端使用,包括 Claude Code、OpenClaw、Cursor 以及其他兼容 OpenAI 的应用。
原生菜单栏应用可以启动、停止和监控服务器。其 Web 控制面板包含模型管理、聊天和实时指标功能;该应用经过签名和公证,并支持应用内自动更新。
支持 JSON、Qwen、Gemma、GLM 和 MiniMax 工具调用格式,还支持 MCP 工具集成,以及按模型配置对过大的工具结果进行裁剪。
在编码会话中,当代理反复访问或更改上下文时,将 oMLX 用作 Claude Code、OpenClaw 或 Cursor 的本地后端。
当多个本地客户端或工作流需要同时进行模型生成时,通过连续批处理服务多个请求。
通过控制面板管理和测试来自 Hugging Face 的 MLX 格式模型,包括语言、视觉语言、嵌入和重排序模型。
将模型连接到使用工具调用或 MCP 的应用,并支持多种特定于模型的工具格式以及可选的工具结果裁剪。
oMLX 需要搭载 Apple Silicon(M1 及更新型号)的 Mac,并运行 macOS 15 或更高版本。该网站列出的最低内存为 16GB,并建议使用 64GB 或更高内存,以便更舒适地运行较大的模型。
可以。它提供兼容 OpenAI 的 `/v1/chat/completions` 端点和兼容 Anthropic 的 `/v1/messages` 端点。其控制面板可以为支持的工具生成配置命令。
不一定。oMLX 可以读取标准 Hugging Face 缓存、LM Studio 文件夹和自定义目录。控制面板还提供 Hugging Face 下载器,用于下载新模型。
该网站称,oMLX 支持来自 Hugging Face 的 MLX 格式模型,包括 Qwen、LLaMA、Mistral、Gemma、DeepSeek、MiniMax 和 GLM。它支持视觉语言模型,且对推理模型的处理包括自动支持 `<think>` 标签。
用户可以下载 macOS DMG,或从源代码安装。从源代码安装需要 Python 3.10 或更高版本以及 Apple Silicon;文档中的服务器示例会连接到 localhost:8000 上的兼容客户端。
流量数据仅供参考。