
多种 NVIDIA GPU 系列
HyperAI 提供 A100、L4、RTX 6000 Pro 和 H200 GPU 配置,团队可根据训练、推理或更大上下文窗口的需求选择合适硬件。
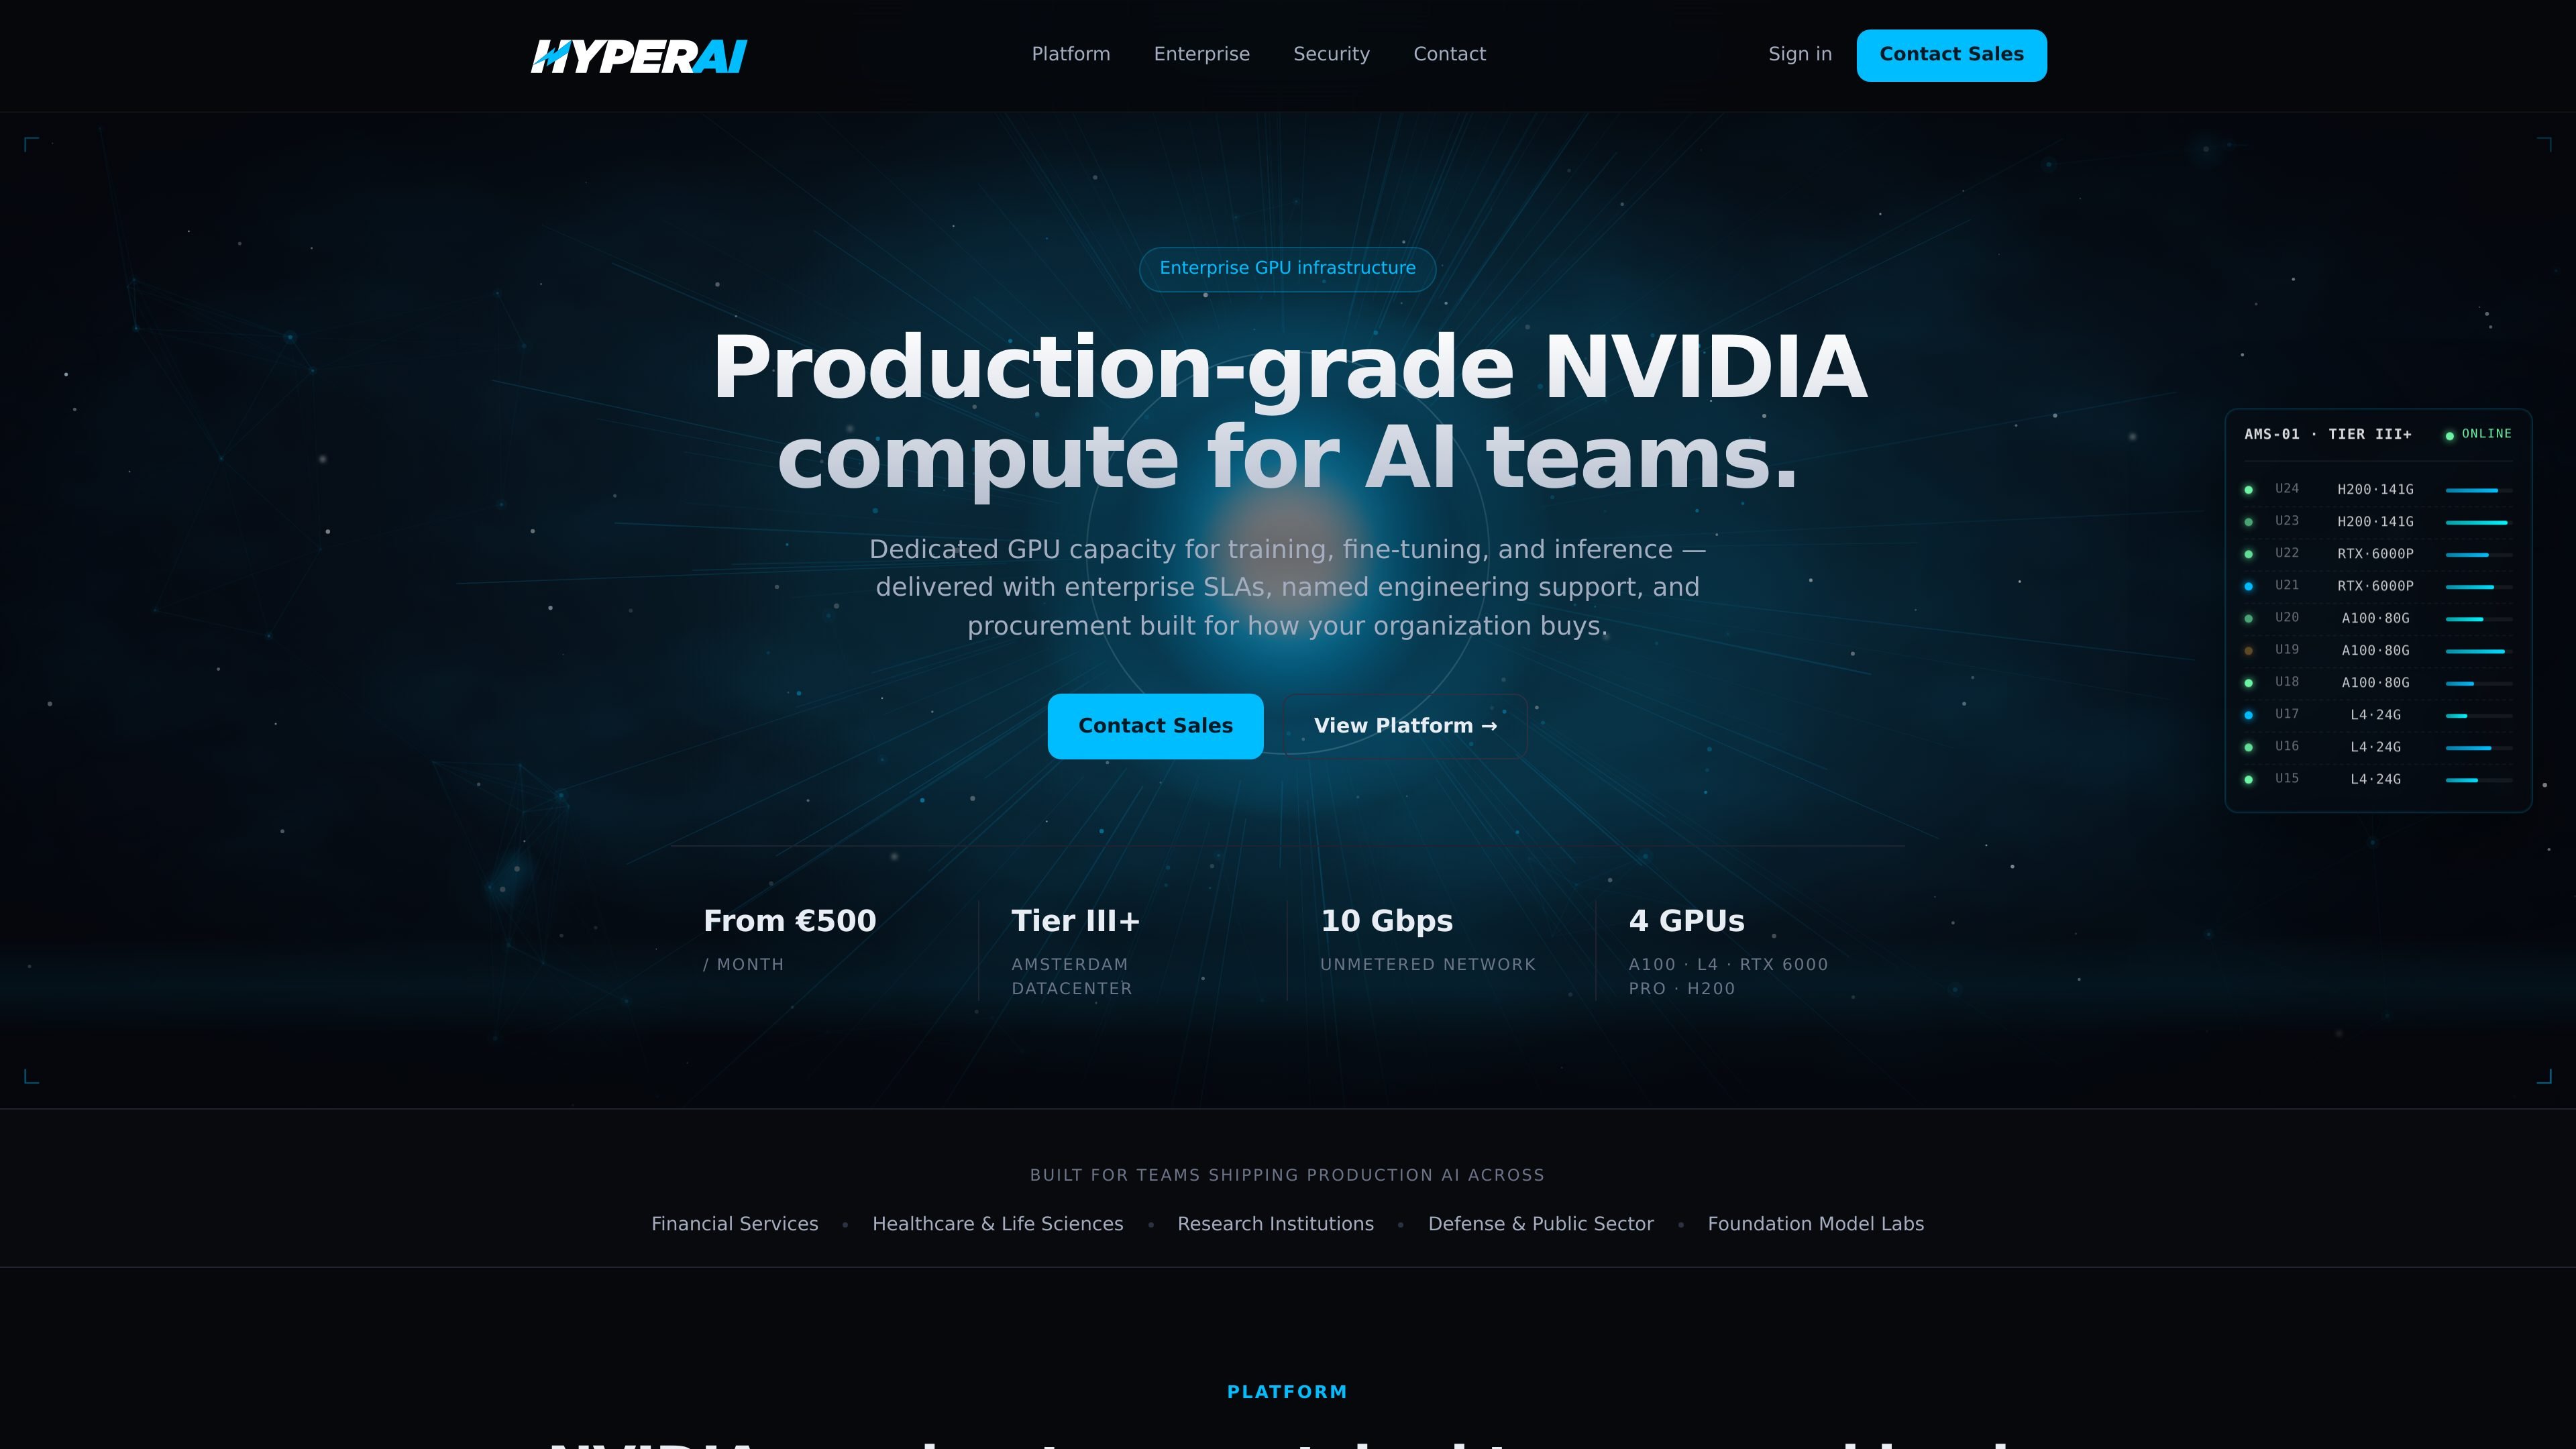
HyperAI 是一项企业级 GPU 基础设施服务,面向需要专用 NVIDIA 计算资源而非共享云实例的 AI 团队。网站将其定位为用于训练、微调和推理的生产级基础设施,硬件选项涵盖 A100、L4、RTX 6000 Pro 和 H200。
其公开页面强调适合采购流程的部署选项:单租户节点或隔离集群、带 SLA 保障的正常运行时间、专属工程支持以及预留容量合同。每个层级都包含托管基础设施基线,部署在阿姆斯特丹 Tier III+ 数据中心,提供 10 Gbps 网络和本地 NVMe 存储。
HyperAI 提供 A100、L4、RTX 6000 Pro 和 H200 GPU 配置,团队可根据训练、推理或更大上下文窗口的需求选择合适硬件。
首页将单租户节点和隔离集群作为卖点,面向需要专用计算资源、而不与其他客户共享节点的环境。
每个部署都包含 Tier III+ 阿姆斯特丹数据中心、10 Gbps vPort 以及按公平使用条款提供的不计量流量,为服务提供固定的基础设施配置。
配置将 GPU 与 AMD EPYC 处理器、NVMe 存储以及明确的 RAM 和 vCPU 层级组合,便于按工作负载需求进行部署规模调整。
网站说明可通过年度和多年期合同获得预留容量,包含保证分配,并可按需提供固定价格。
HyperAI 包含专属技术支持,提供专属技术客户经理和 24/7 值守工程师,而不是通用工单队列。
使用 A100 和 H200 配置处理内存需求高的训练、微调以及需要 NVLink 或 HBM 容量的前沿 LLM 工作。
在能效和合适的 GPU 容量更重要时,使用 L4 运行聊天机器人、嵌入和视频流水线等生产推理工作负载。
在需要 Blackwell 级 GPU 且拥有 96 GB 内存时,使用 RTX 6000 Pro 进行大上下文推理或密集型单节点训练。
将专用租户和隔离集群模式用于希望获得预留 GPU 容量、按需固定价格以及适合采购流程合同的组织。
为需要托管部署且具有清晰运营责任分工的团队,使用阿姆斯特丹基础设施和专属支持模式。
HyperAI 是一项面向 AI 工作负载的托管企业级 GPU 基础设施服务。首页将其定位为用于 NVIDIA GPU 上的训练、微调和推理,工作负载覆盖 A100、L4、RTX 6000 Pro 和 H200 配置。
该网站展示了专用的单租户节点和隔离集群,但未说明自助配置步骤。公开页面呈现的是以销售为主导的采购流程,提供平台和规格表链接,而不是文档化的上手向导。
HyperAI 列出了基础设施配置,例如位于阿姆斯特丹的 Tier III+ 数据中心、10 Gbps 不计量网络、NVMe 存储,以及与每个 GPU 匹配的 AMD EPYC CPU。公开页面未描述具体的软件集成或编排工具。
首页说明每次部署都包含专属工程支持,包括专属技术客户经理和 24/7 值守工程师。页面还提到带有 SLA 保障的正常运行时间,承诺 99.9% 可用性,并提供服务信用。
公开网站未显示已验证的定价页面。首页列出了每种 GPU 配置的月度起始价格,并注明可按需提供年度和多年期折扣,且不含增值税。
流量数据仅供参考。
