
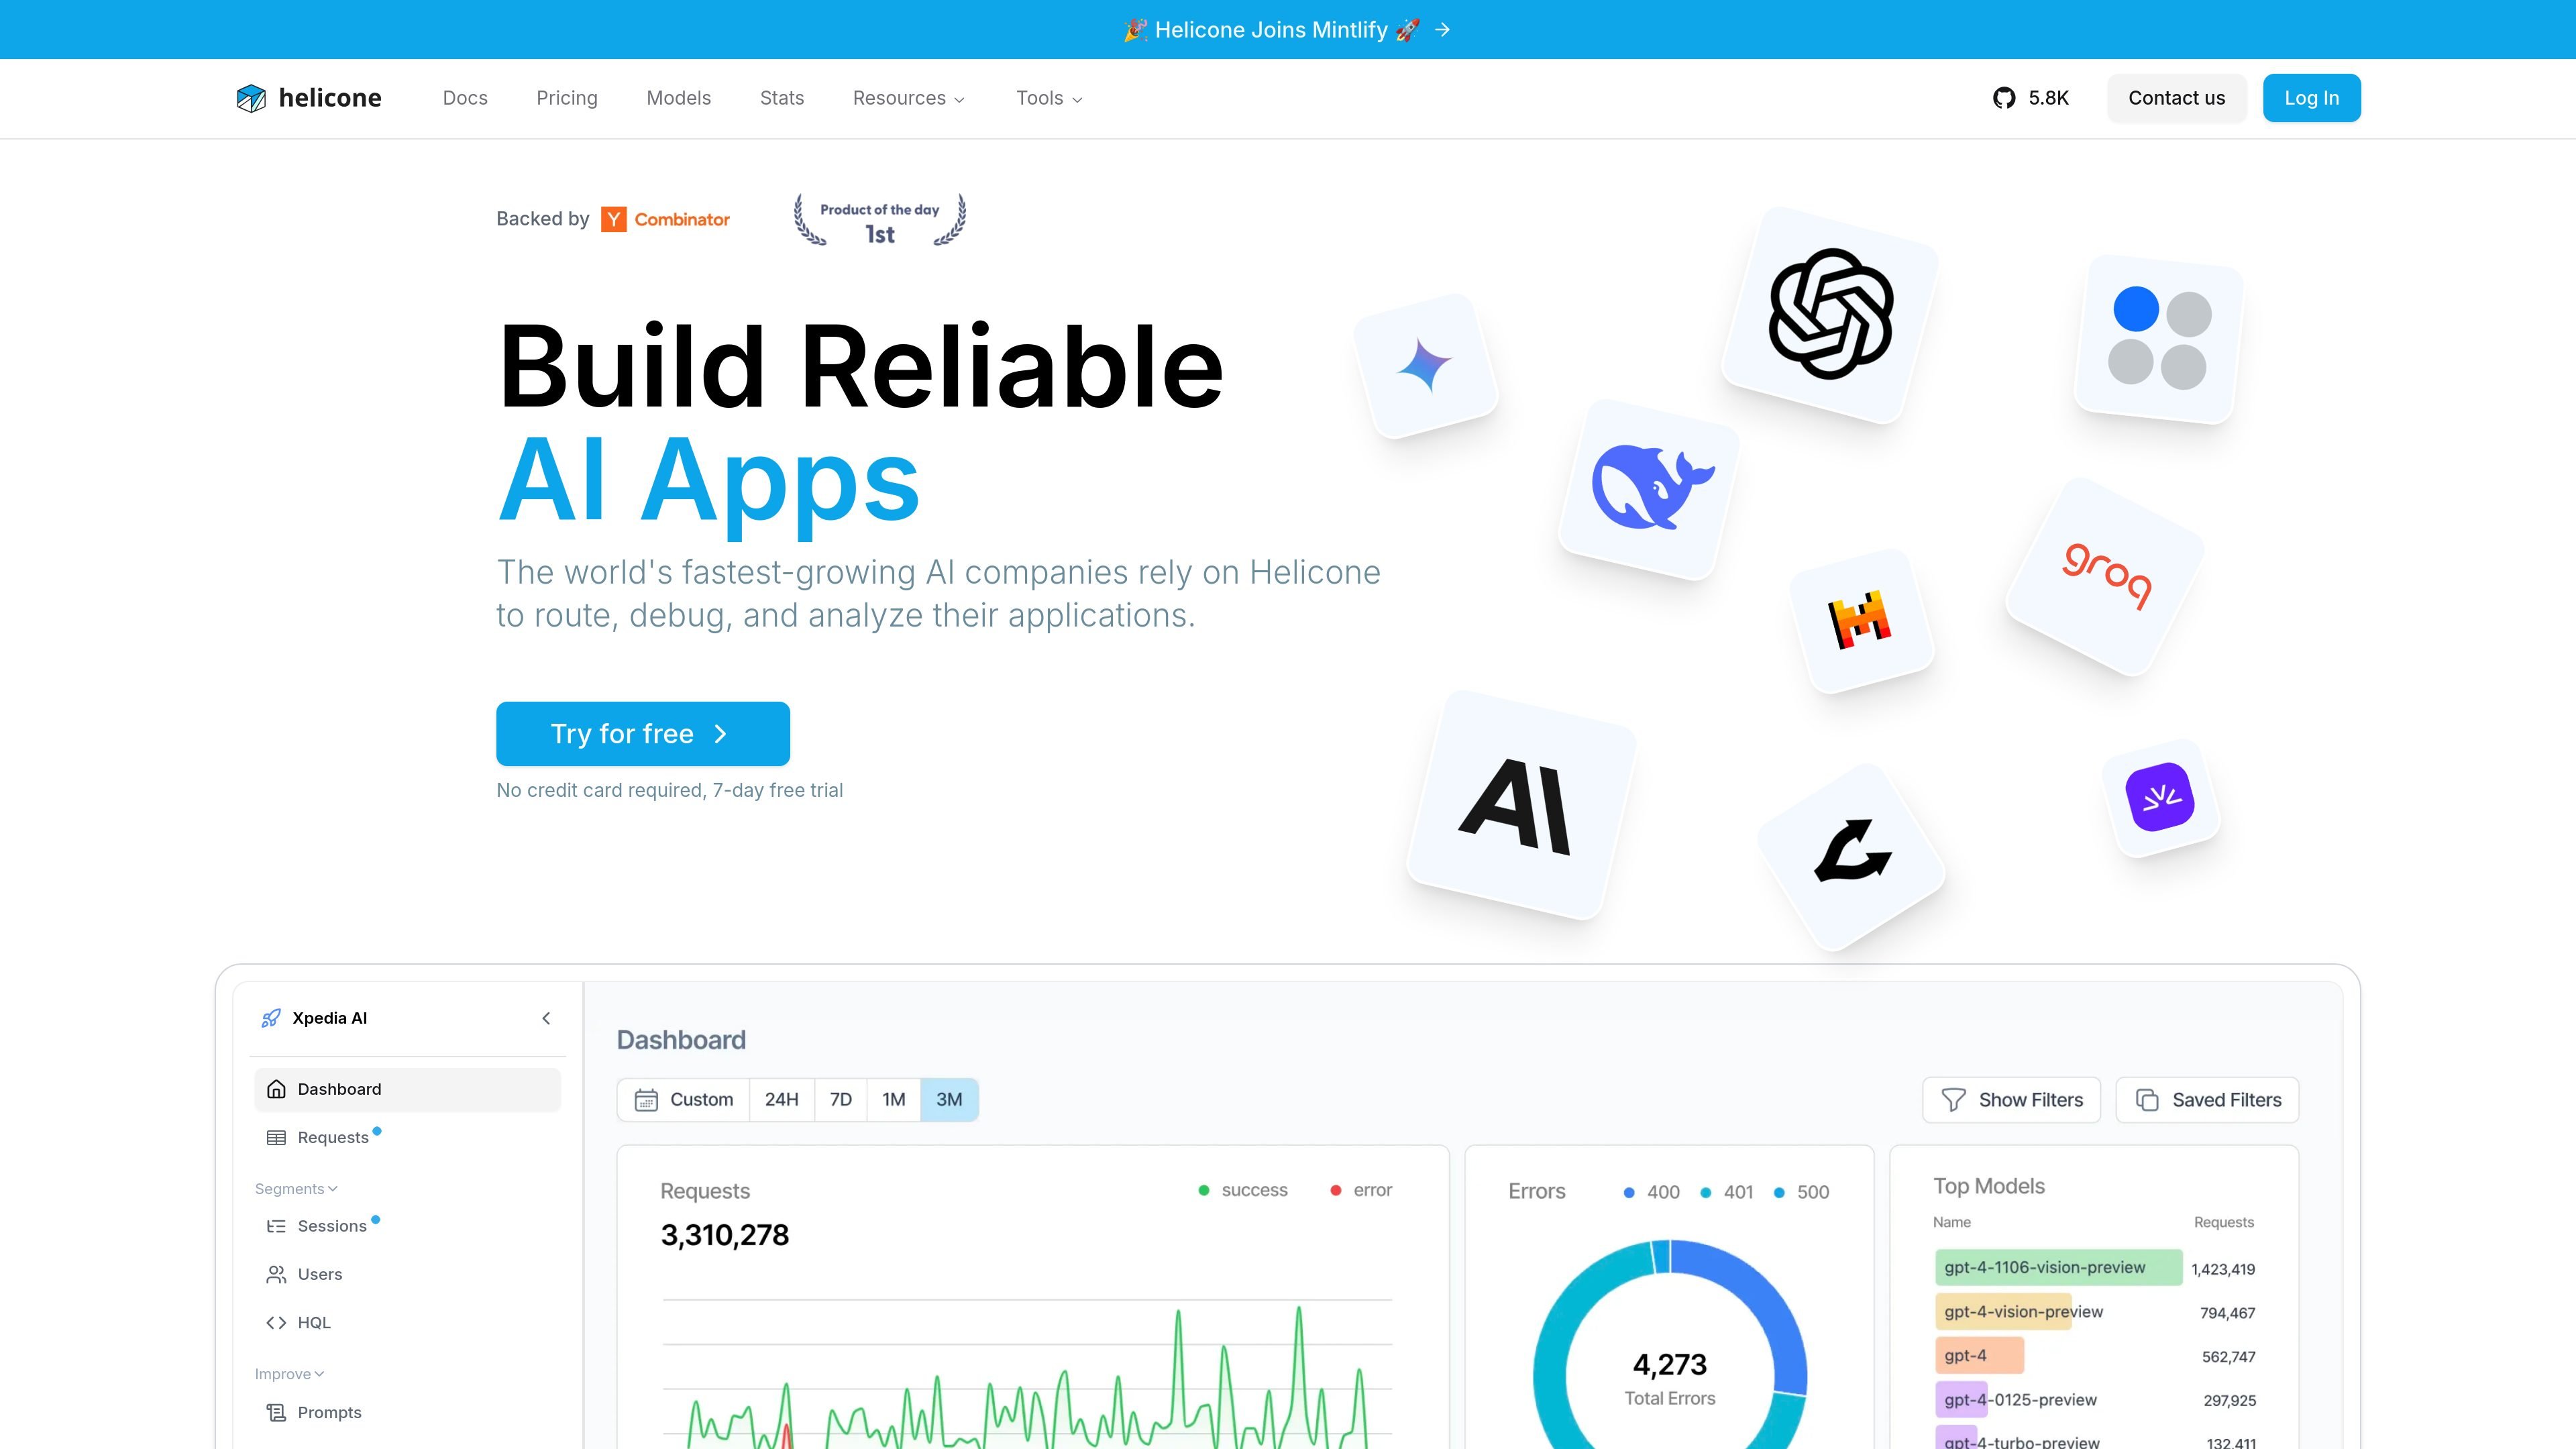
用量、成本与延迟监控
跟踪模型用量、支出和响应延迟,以识别成本高昂的工作负载和性能瓶颈。

Helicone 是面向 AI 应用开发者的开源网关与大语言模型可观测性平台,可路由模型请求,并帮助团队分析用量、延迟、成本及应用行为。支持云端服务和自托管部署。
Helicone 是面向使用大语言模型的应用的开源 AI 网关与可观测性平台。它帮助开发者路由模型请求、调查应用行为,并了解多个 AI 模型的用量、延迟和成本。
团队可以将 Helicone 集成到现有 AI 工作流中,包括将其用作模型请求的代理。其监控、请求控制和测试工具可支持持续分析与优化。Helicone 提供云端服务,并支持自托管部署。
在 2026 年 3 月 3 日的收购公告中,Helicone 表示,其服务在可预见的未来将继续以维护模式运行,并持续提供安全更新、新模型以及错误和性能修复。规划长期依赖时,请考虑其维护状态。
跟踪模型用量、支出和响应延迟,以识别成本高昂的工作负载和性能瓶颈。
通过支持缓存、速率限制和自动回退的网关路由模型请求。模型切换功能可支持更改应用所使用的模型。
为请求附加自定义属性,以便更详细地分析应用活动。会话和用户分析也提供了其他检查用量的方式。
Pro 包含 Helicone Query Language (HQL)、警报和报告,可用于调查已记录的活动并监控持续运行情况。
使用 playground 测试提示词、会话和跟踪记录,并借助提示词、评分和数据集检查模型行为。
不同套餐的数据保留期限各异:Hobby 为七天,Enterprise 为无限期。价格对比还列出了 API 访问和数据导出。
当应用运行变慢时,开发者可以结合已记录的请求和会话活动检查延迟,以定位需要关注的工作负载。
使用自定义属性区分工作负载并检查其模型用量和成本,帮助团队确定优化工作的重点。
使用网关缓存处理重复请求,并在应用的请求处理工作流中配置速率限制和自动回退。
需要掌控基础设施的团队可以了解自托管方案。Enterprise 套餐包含本地部署、SAML SSO 和定制 MSA。
Hobby 每月包含 10,000 次请求、1 GB 存储空间、一个席位和一个组织。其列明的数据保留期限为七天。这是可观测性额度;通过网关进行模型推理需要使用额度,应单独纳入预算。
Pro 每月 79 美元,Team 每月 799 美元,两者均另收基于用量的费用。两者都提供七天免费试用。Enterprise 套餐价格可向销售团队咨询。
Helicone 支持集成到现有 AI 工作流中,包括用于 AI 模型请求的网关代理。其文档提供快速入门指南、网关集成说明、自定义属性指南和身份验证详情。
Pro 包含不限数量的席位和一个组织。Team 增加五个组织和专属 Slack 频道。Enterprise 包含不限数量的组织、SAML SSO、本地部署和定制 MSA。
流量数据仅供参考。
www.tensorzero.com
开源 LLMOps 平台,用于构建和运营生产级大语言模型应用,涵盖网关、可观测性、评估、优化与实验;现已停止维护。

www.newapi.ai
New API 是面向开发者和团队的开源、自托管 AI 网关,提供统一的 OpenAI 兼容端点,用于连接多个 AI 提供商、选择模型、配置渠道并监控用量。
apisix.apache.org
Apache APISIX is an open-source API gateway and AI gateway for routing, securing, observing, and governing API, microservice, and LLM traffic. It helps teams manage dynamic gateway policies through a plugin-based architecture built on NGINX and etcd.

aihubmix.com
AIHubMix 为开发者提供统一的 API 网关和模型目录,可通过兼容 OpenAI 的接口及其他协议接入多家提供商的模型,并管理 API 密钥权限与使用限制。

pydantic.dev
用于构建类型安全应用、观测 AI 系统、评估输出和路由模型访问的 AI 工程技术栈

portkey.ai
面向生成式 AI 团队的生产级 AI 平台,提供统一网关、可观测性、防护机制和提示词管理。