

多源内容摄取
摄取文件、文本、URL、信息源和已连接账户中的内容,包括 PDF、音频、视频、网页、Slack 消息、电子邮件和知识库来源。
Graphlit 是面向 AI 智能体和应用的上下文层,帮助它们处理组织知识,而不是孤立的聊天记忆。它通过单一 API 集成内容摄取、提取、搜索、对话和知识图谱工作流。
该产品旨在将文件、网页、消息、存储系统和业务工具中的内容引入可搜索的上下文层。产品页面强调实时或持续同步、来源溯源和有依据的回答,让智能体能够使用有来源支持的信息,而不是静态提示或临时拼接的代码。
摄取文件、文本、URL、信息源和已连接账户中的内容,包括 PDF、音频、视频、网页、Slack 消息、电子邮件和知识库来源。
支持准备、提取和丰富工作流,并内置转录、OCR、嵌入和补全功能。
提供语义搜索、关键词搜索和混合搜索,并支持带来源引用的有依据对话,适用于检索增强场景。
提取实体、可观测对象、关系和时间状态,以构建组织知识图谱,而不只是简单的文档索引。
可连接 Slack、GitHub、Jira、Notion、Google Drive、S3、Gmail、Dropbox 等工具,产品信息中还提到持续同步。
提供 SDK 和 MCP 服务器,支持 TypeScript、Python 和 .NET 等开发者工作流;在更高等级的套餐中,还可通过 Claude、Cursor 和 ChatGPT 等工具访问。
构建能够依据公司知识回答问题的助手,并提供来源引用、多轮记忆,以及对文档、消息和已连接应用的检索。
同步并搜索 Slack、GitHub、Jira、Notion 和电子邮件等工具中的运营内容,让团队无需手动 ETL 即可查找上下文。
从内容中提取人员、公司、关系、事件和归属信息,以支持图谱查询和理解关系的应用。
通过摄取、转录、OCR 和丰富处理管道处理 PDF、网页、音频、视频和办公文件,为后续 AI 使用提供支持。
通过 MCP 和 SDK 将外部数据源连接到 AI 智能体,使应用能够从熟悉的开发者工具中检索上下文并触发操作。
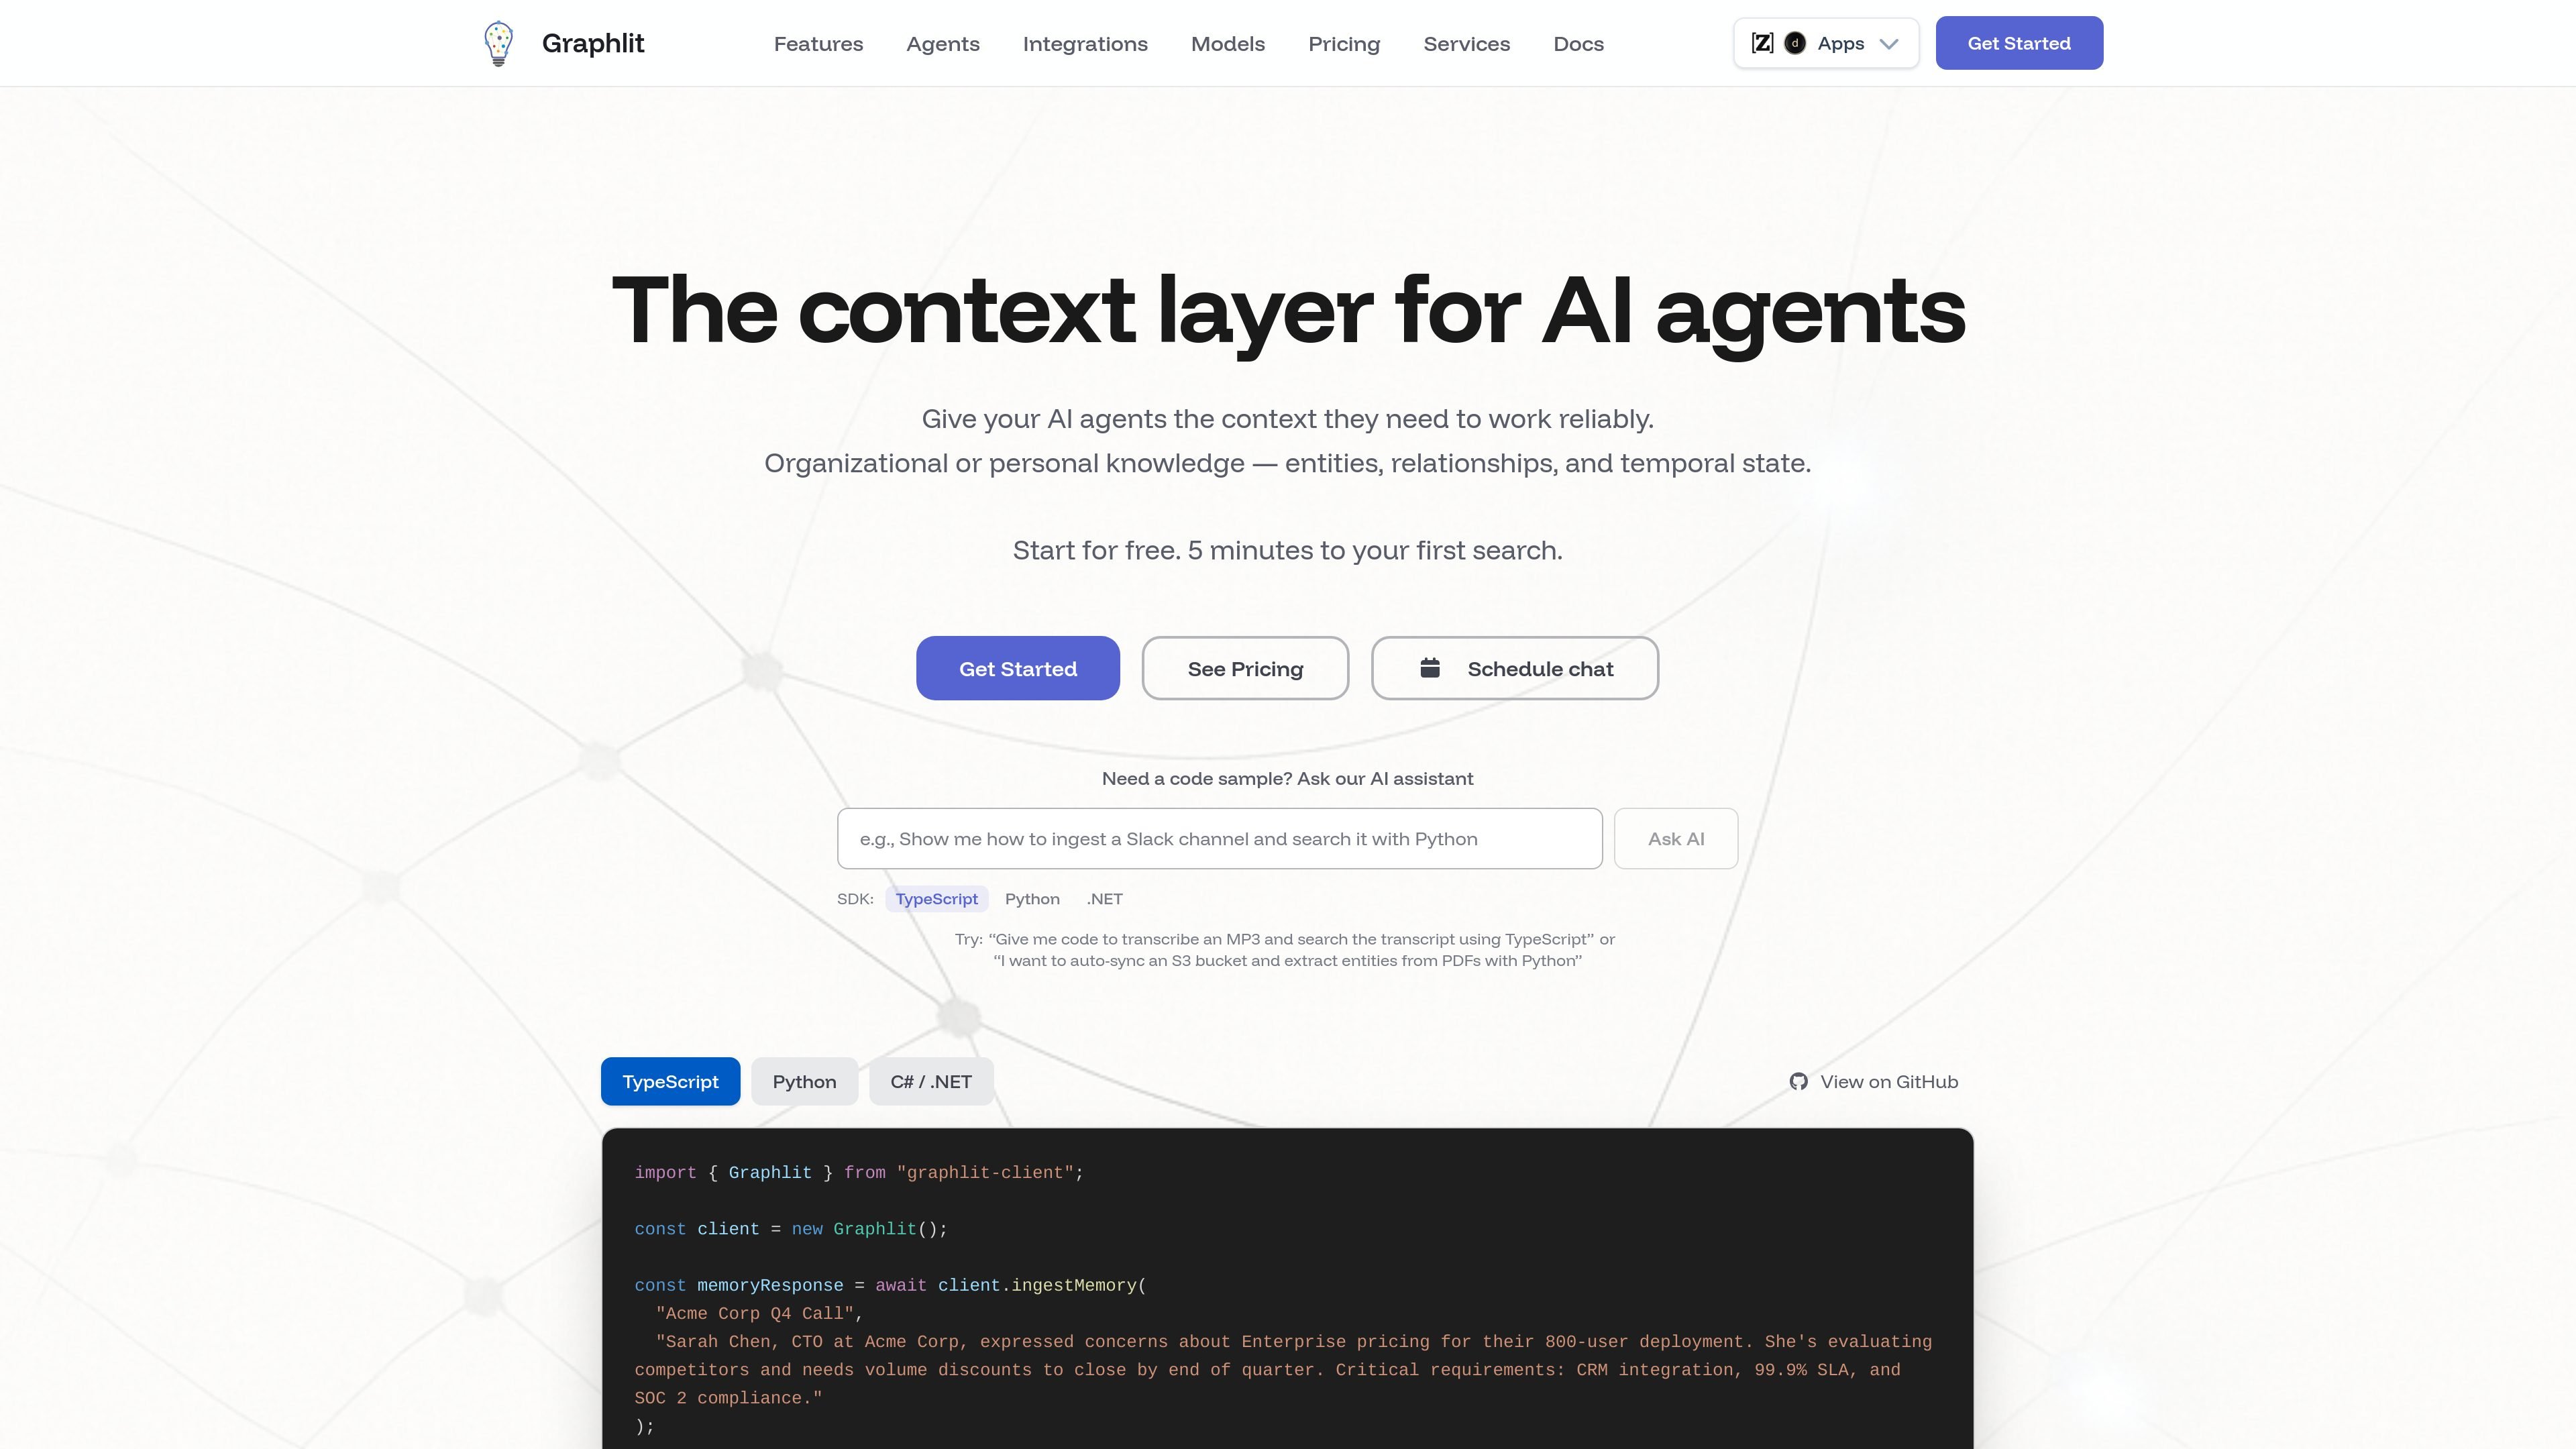
Graphlit 可用于摄取内容、提取结构,并将其变为可搜索的信息,为需要有依据上下文的 AI 应用提供支持。产品页面将其定位为面向 AI 智能体的上下文层,并支持搜索、RAG、对话和知识图谱。
定价页面显示,Graphlit 提供用量有限的 Free 层级,以及 Hobby、Starter 和 Growth 付费套餐,还提供面向更大规模集成和智能体工作的 Custom 选项。页面还表示可以通过免费项目开始使用,且免费层级无需信用卡。
支持。产品页面提到 TypeScript、Python 和 .NET SDK,主页还展示了 TypeScript 示例代码。
Graphlit 的集成页面介绍了跨已连接工具的摄取、准备和交付。页面重点展示了 Slack、GitHub、Jira、Notion、Gmail、Google Drive、S3、Dropbox 及类似系统等来源。
定价页面表示,Graphlit 在统一的平台价格中包含内容摄取与提取、搜索与 RAG、知识图谱以及智能体上下文。页面还特别提到引用、可配置工作流和内容信息源。
流量数据仅供参考。

airweave.ai
Airweave 是面向 AI 代理和 RAG 系统的开源上下文检索层,可连接应用与数据库、实时同步数据,并通过统一搜索实现有依据的检索。

unabyss.com
Unabyss 连接电子邮件、文档、日历和代码仓库,将信息整理为结构化上下文,供支持的 MCP 客户端检索、综合并保存可复用的长期记忆。
memmy.bot
Memmy 是一款本地优先的 AI 智能体和记忆层,适合使用多种 AI 工具的人。它会将经授权的上下文保存在设备上,并能在桌面应用、CLI 工作流和外部智能体之间传递相关记忆。

pieces.app
An on-device work memory layer that helps individuals and teams recover context across their tools.
www.getnoan.com
NOAN 是面向企业的事实层与 API,让网站、应用和 AI 智能体使用同一套经过验证的公司信息。它将已批准、带版本的业务事实组织到可通过 REST 和 MCP 访问的互联工作区中。
skynetlab-cortex.com
Cortex 是面向 AI 助手和智能体的语义记忆基础设施,帮助团队跨对话和模型变更共享上下文、决策、来源与矛盾信息。