

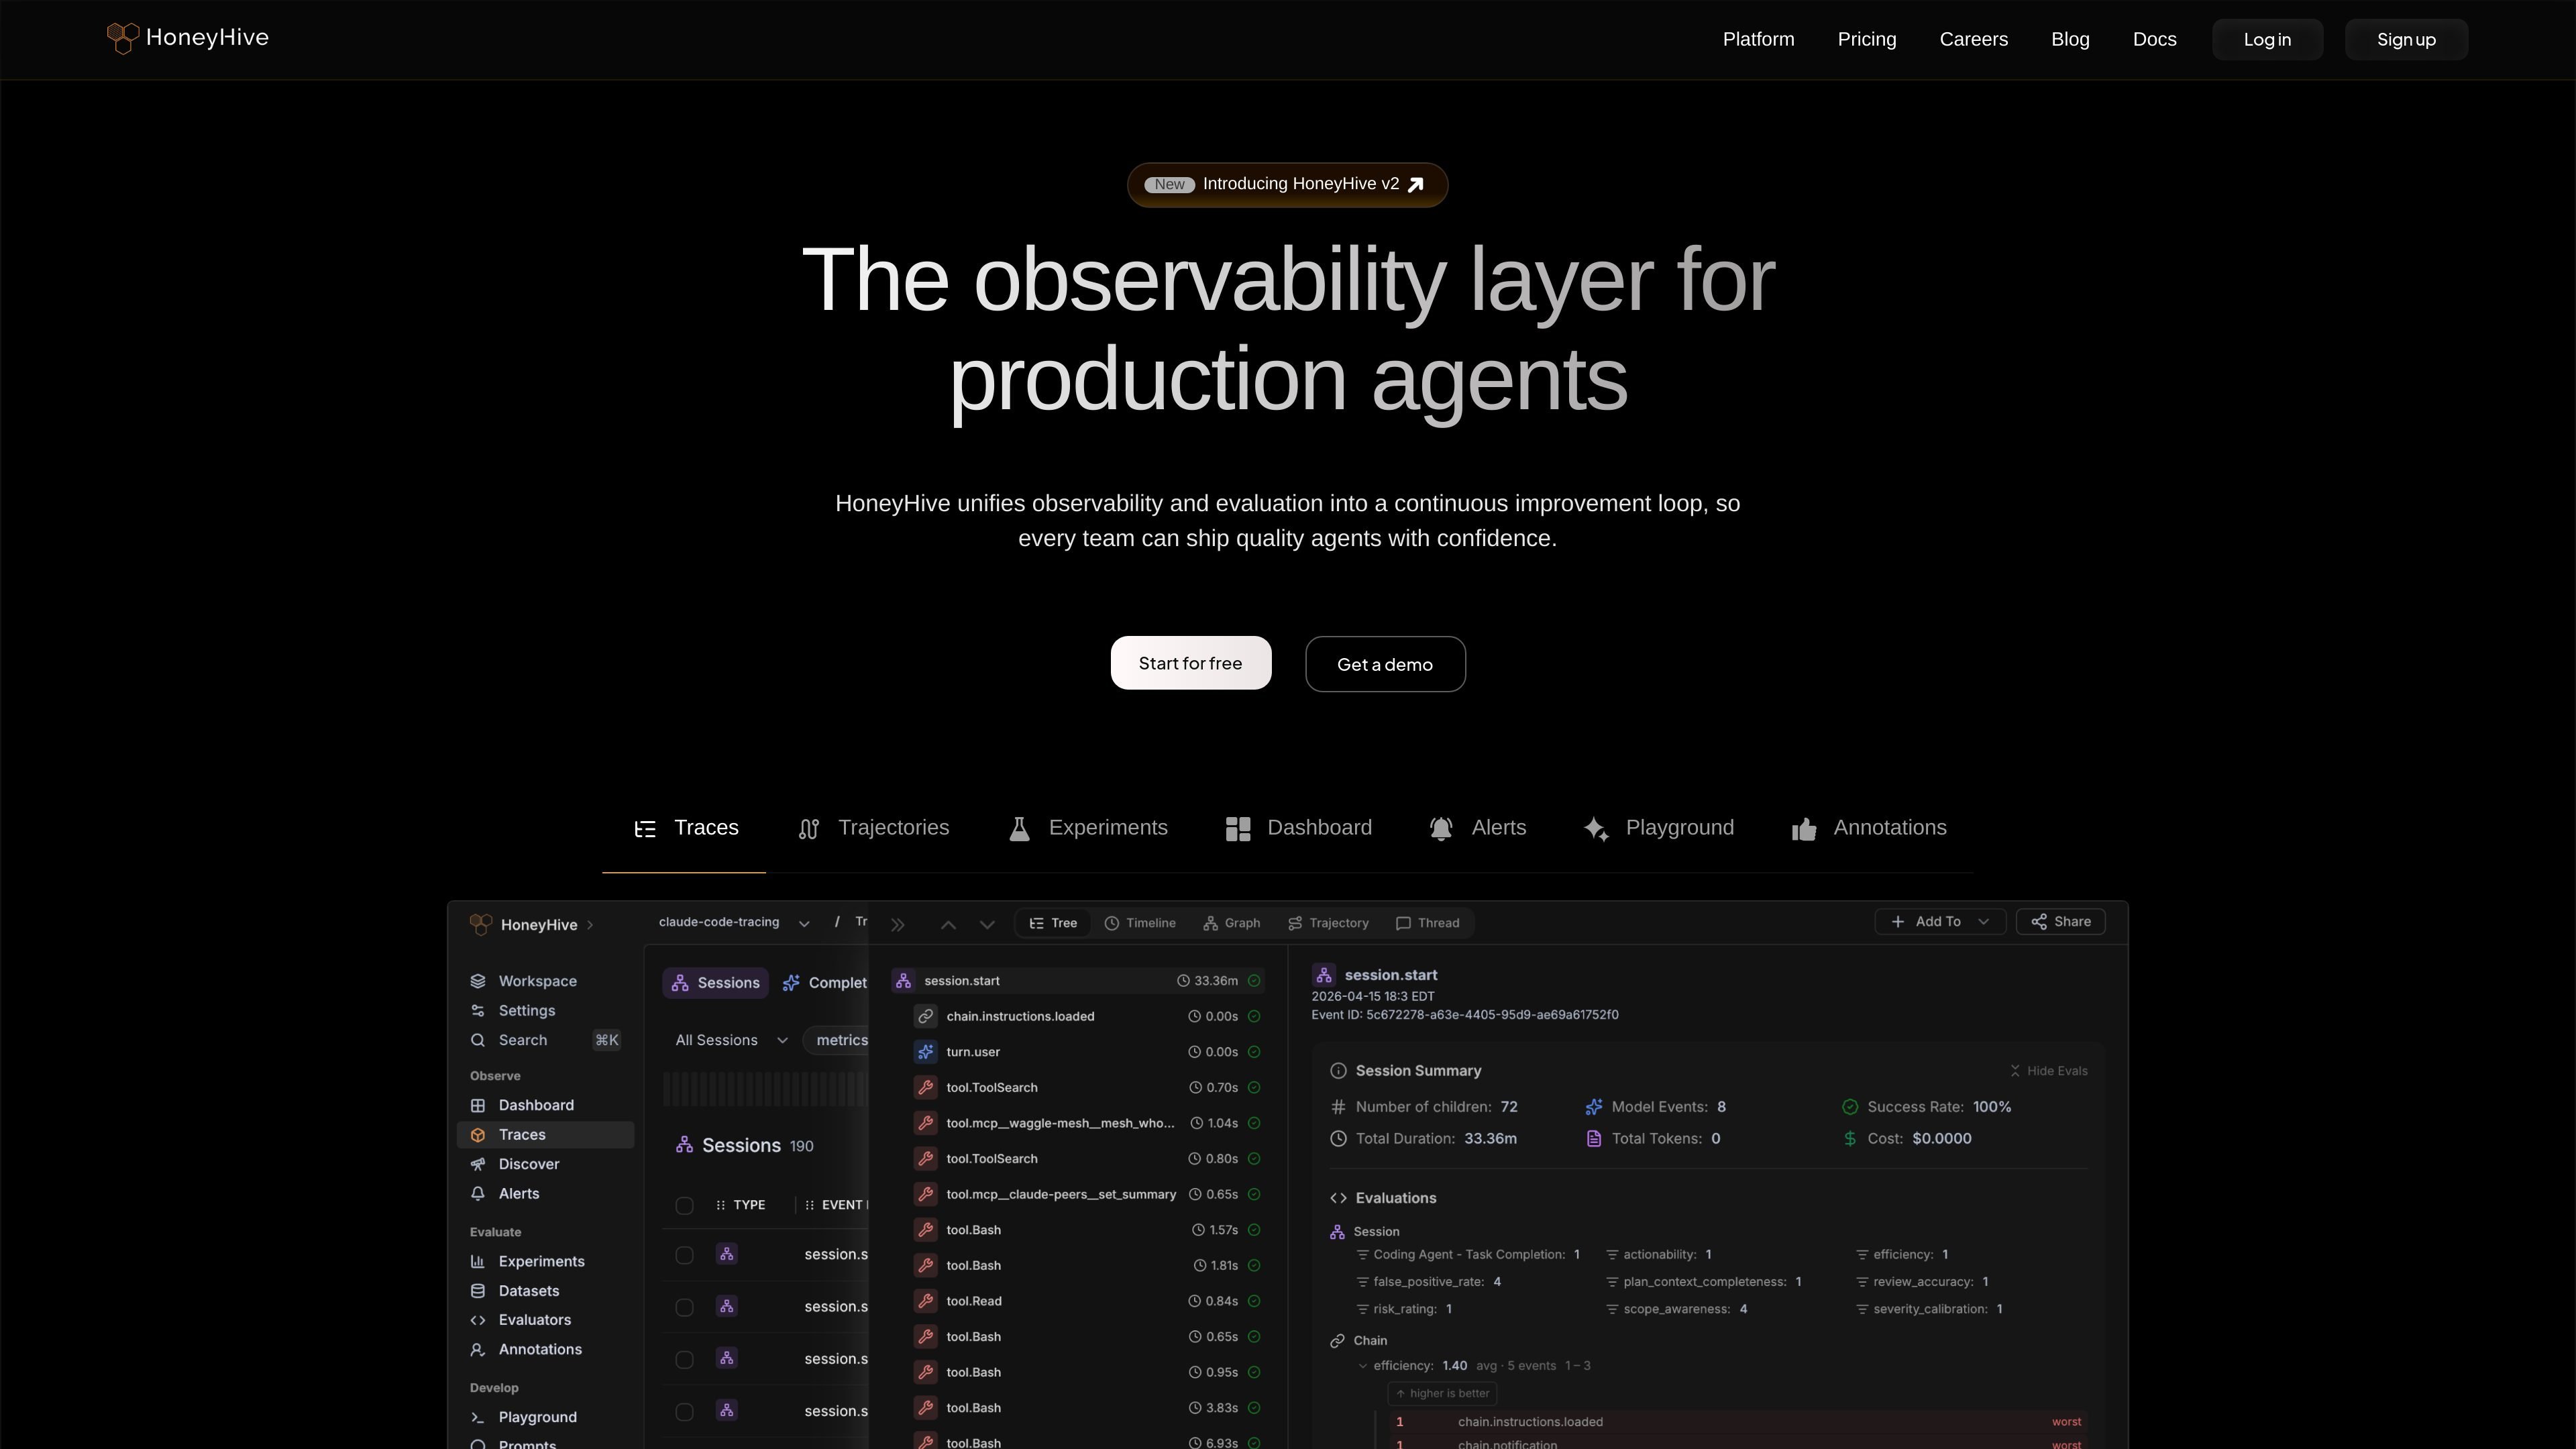
分布式追踪
使用 OpenTelemetry 为代理埋点,在不同框架、模型和运行时之间追踪行为,然后通过共享视图进行调试和分析。
HoneyHive 是面向生产环境 AI 代理的可观测性与评估平台。它结合了分布式追踪、在线评估、实验和审阅工作流,使团队能够检查代理行为、识别故障,并通过可重复的循环持续改进。
该网站将产品定位为原生支持 OpenTelemetry 且不受框架限制的平台,可在任意技术栈上为代理埋点。它面向希望拥有一个共享事实来源来调试代理行为、监控线上系统,并将生产问题转化为下一轮迭代测试用例的团队。
使用 OpenTelemetry 为代理埋点,在不同框架、模型和运行时之间追踪行为,然后通过共享视图进行调试和分析。
对追踪进行在线评估,以检测失败、给输出打分,并将自动检查与人工审阅结合起来。
通过告警、漂移检测和自定义仪表板监控真实世界中的行为,帮助团队在用户发现问题之前先行捕获。
回放聊天会话,并查看轨迹、图结构和时间线,以理解多步骤代理工作流如何展开。
将生产故障转化为离线测试套件,与基线进行对比,并在发布前检测回归。
将被标记的追踪路由到标注队列,应用自定义评分标准,并利用专家反馈整理数据集和对齐评估器。
为生产代理埋点,以便在调试实时系统中的异常行为时查看追踪、轨迹和会话回放。
使用在线评估、告警、漂移检测和仪表板监控实时流量,及时发现新出现的质量问题。
基于真实故障构建离线回归测试套件,将变更与基线进行比较,并在 CI/CD 中于发布前运行检查。
使用标注队列和自定义评分标准,让领域专家审阅边缘案例,并使评估器与业务标准保持一致。
在需要数据隔离、治理或企业级控制时,采用自托管或混合部署。
HoneyHive 支持自动评估和人工评估。自动评估可以使用代码或 LLM-as-a-judge 评分,而人工评估则允许领域专家使用自定义评分标准和标注队列审阅输出。
是的。Enterprise 套餐支持自托管,价格页面还列出了混合方案,即由 HoneyHive 托管控制平面,而数据平面自托管。
价格页面说明 HoneyHive 提供 Python 和 TypeScript SDK,并原生支持 OpenTelemetry,还可对 50+ 个库进行自动埋点,例如 LangChain、LangGraph、AWS Strands、Google ADK 和 OpenAI Agents SDK。
HoneyHive 专为 AI 代理的可观测性与评估而设计。该网站将其定位为适用于生产代理、分布式追踪、在线评估、实验、告警、标注和审阅工作流的平台。
流量数据仅供参考。
www.privent.ai
Privent 是面向智能体 AI 的运行时安全层,尤其适用于 n8n 工作流,可在敏感数据传给外部模型前进行脱敏,记录风险决策,并监控组织范围内对 ChatGPT、Claude 和 Gemini 的使用。

raindrop.ai
面向 AI agent 的监控与可观测性,助力调试生产运行

fiddler.ai
面向生产环境智能体系统的企业级 AI 可观测性与安全平台,提供评估、监控、实时护栏和治理。

keywordsai.co
用于可观测性、评测、提示词管理和网关路由的 LLM 工程平台

chirpz.ai
Chirpz AI 打造 PandaProbe,这是一个用于追踪、评估和监控生产环境中 AI 智能体的开源平台,帮助团队提升可观测性并调试智能体工作流。
lmnr.ai
面向 AI 智能体的开源可观测性平台,支持运行追踪、故障检测、评估、Slack 警报和自托管。