

跨多种金融格式的文档提取
使用针对文档阅读优化的 AI 模型,从发票、银行对账单、财务报表、PDF、扫描件和其他金融文档中提取数据。
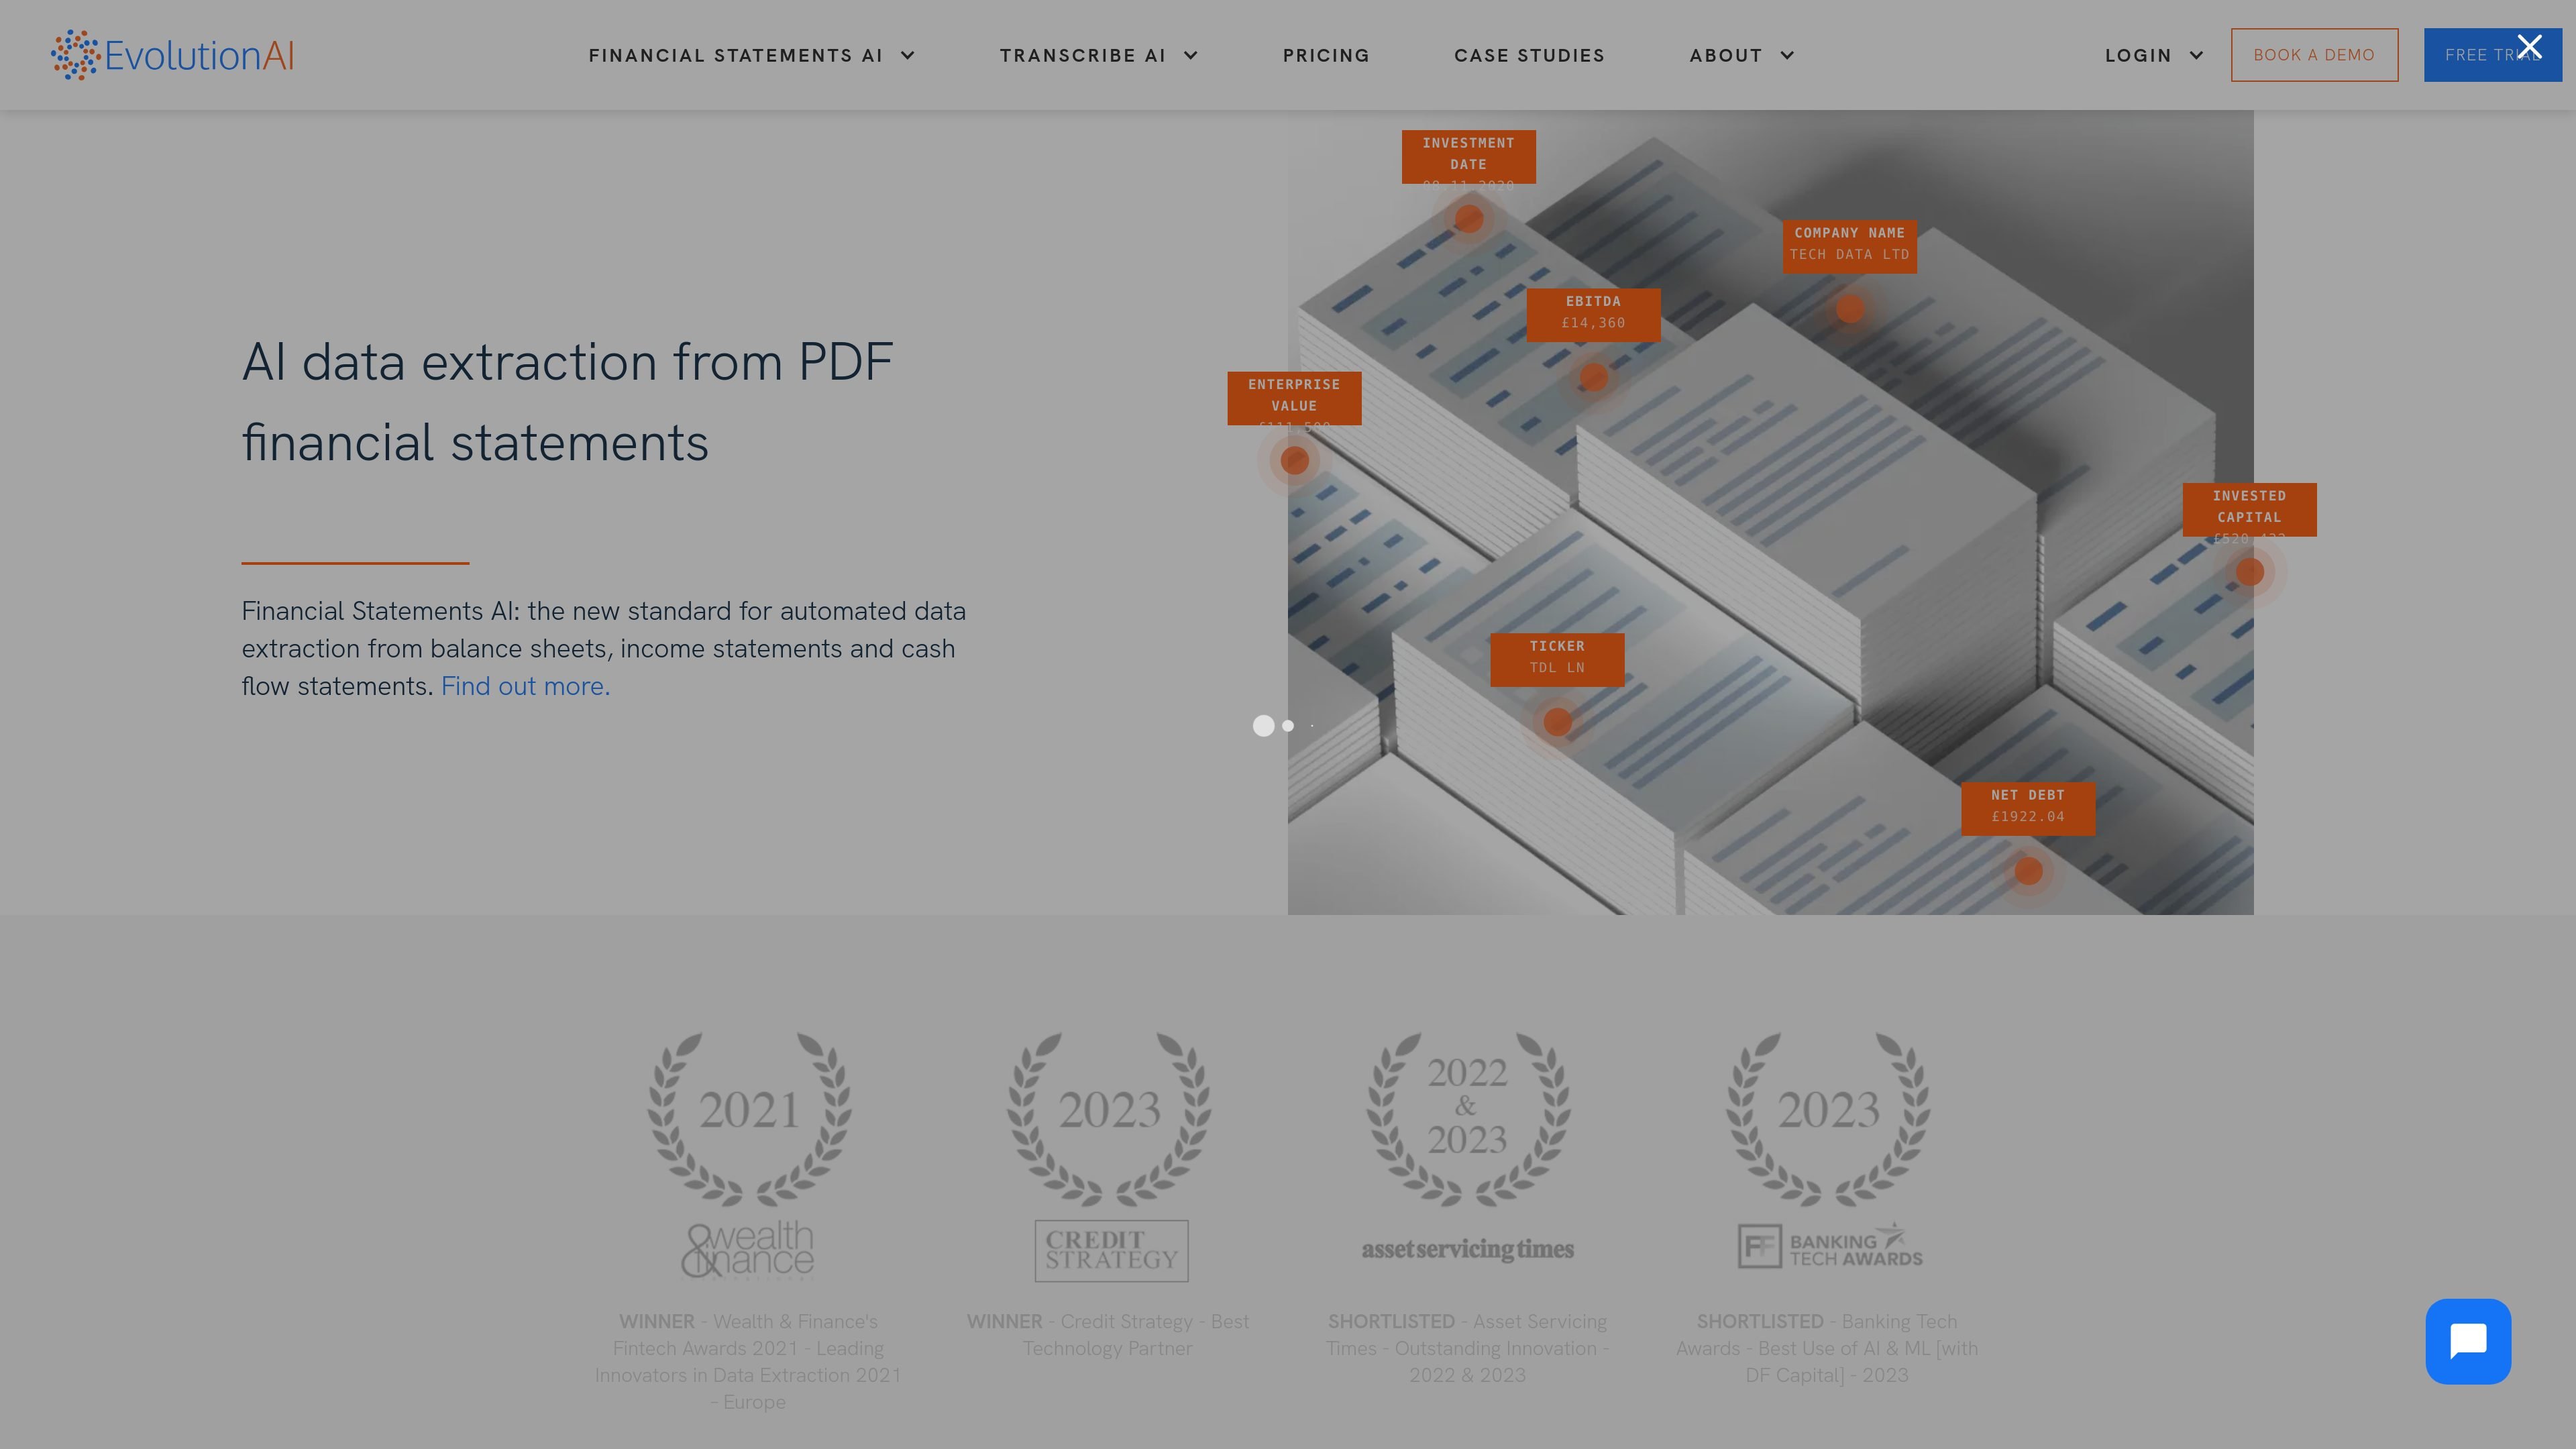
Evolution AI 是一个面向金融和文档密集型工作流的 AI 数据提取平台。其网站展示了两条主要产品路径:用于报表的 Financial Statements AI,以及用于其他 PDF 和扫描件(包括发票和银行对账单)的 Transcribe AI。
该平台旨在从复杂文档中捕获结构化数据,规范化日期和金额等字段,并在需要时支持人工审核。定价页面同时展示了自助和端到端服务选项,因此团队可以选择自行运营平台,或由 Evolution AI 负责设置和 QA。
使用针对文档阅读优化的 AI 模型,从发票、银行对账单、财务报表、PDF、扫描件和其他金融文档中提取数据。
在文档中可用时,支持明细行、总额、增值税或税费、发票元数据、卖方详情、报告期间、货币、倍数以及复杂的多页表格。
提供可配置的 QA 工作流,包含置信度阈值、人工在环审核、审批步骤以及已提取值的来源审计轨迹。
应用标准化日期格式和推断字段计算等后处理规则,在交付前规范化提取的数据。
提供 REST API 和 SFTP 集成路径,发票页面还注明支持 ERP/会计系统以及 UiPath、Automation Anywhere 和 Blue Prism 等 RPA 平台。
采用自学习和 zero-shot 方法,使团队可以从预训练模型开始,校正输出,并在无需单独且冗长的训练阶段的情况下重新训练。
为应付账款团队自动化发票采集,从 PDF 或扫描件中提取总额、税费、明细行、到期日和供应商详情。
从资产负债表、现金流量表和利润表中提取数值,同时保留报告期间、货币和多页表格结构。
规范化银行对账单及其他金融文档中的数据,以便后续处理和审核。
运行需要在数据发送到会计或 ERP 系统之前进行验证、可审计性和人工签核的文档工作流。
将提取功能集成到现有自动化栈中,包括基于 REST 的系统、SFTP 传输以及由 RPA 驱动的流程。
Evolution AI 提供自助和端到端两种选项。定价页面说明,自助客户使用基于云的平台并获得支持与培训,而端到端服务则由 Evolution AI 的专家标注团队负责设置和 QA。
该产品面向发票、银行对账单、财务报表以及其他文档类型等金融文档。how-it-works 页面还说明,Transcribe AI 适用于除财务报表外的 PDF 和扫描件,而财务报表则使用 Financial Statements AI。
对于发票,网站说明可从发票 PDF 或扫描件中提取数据,包括明细行以及发票编号、日期、总额和卖方信息等文档详情。对于财务报表,网站提到支持报告期间、货币、倍数以及复杂表格等财务概念。
how-it-works 页面说明该平台支持可配置的 QA 工作流、针对低置信度字段的人类审核、后处理规则,以及 REST API 和 SFTP 等多种集成路径。发票页面还提到了 ERP/会计系统集成以及 UiPath、Automation Anywhere 和 Blue Prism 等 RPA 工具。
该网站将 Evolution AI 定位为面向金融服务和文档密集型团队的产品,尤其适用于发票处理、财务报表提取,以及通过 Transcribe AI 进行更广泛的文档处理。
流量数据仅供参考。

www.browseract.com
BrowserAct is a no-code AI web scraping and browser automation platform that builds reusable Bots from plain-language data requests. It helps teams collect structured, refreshed web data in the cloud or give local AI agents a browser layer for web tasks.
starterbuild.com
Page to Markdown is a free Chrome extension that converts webpages or selected content into clean, usable Markdown. It is designed for notes, documentation, research, AI tools, and coding workflows.
microsoft.github.io
GraphRAG is a research project and data pipeline for extracting structured information from unstructured text with language models, then using graph-based context to support question answering over private data.

www.llamaindex.ai
LlamaParse is an AI document parsing platform that converts complex PDFs, office files, spreadsheets, images, and other documents into structured, AI-ready data. It is designed for developers and enterprise teams building retrieval, extraction, and document automation workflows.

python.useinstructor.com
Instructor is a developer library for extracting structured, validated data from large language models. It uses Pydantic schemas, automatic retries, streaming, and a consistent interface across cloud, local, and routed LLM providers.

imagetotext.info
免费的网页 OCR 工具,将图片和 PDF 转换为可编辑文本