

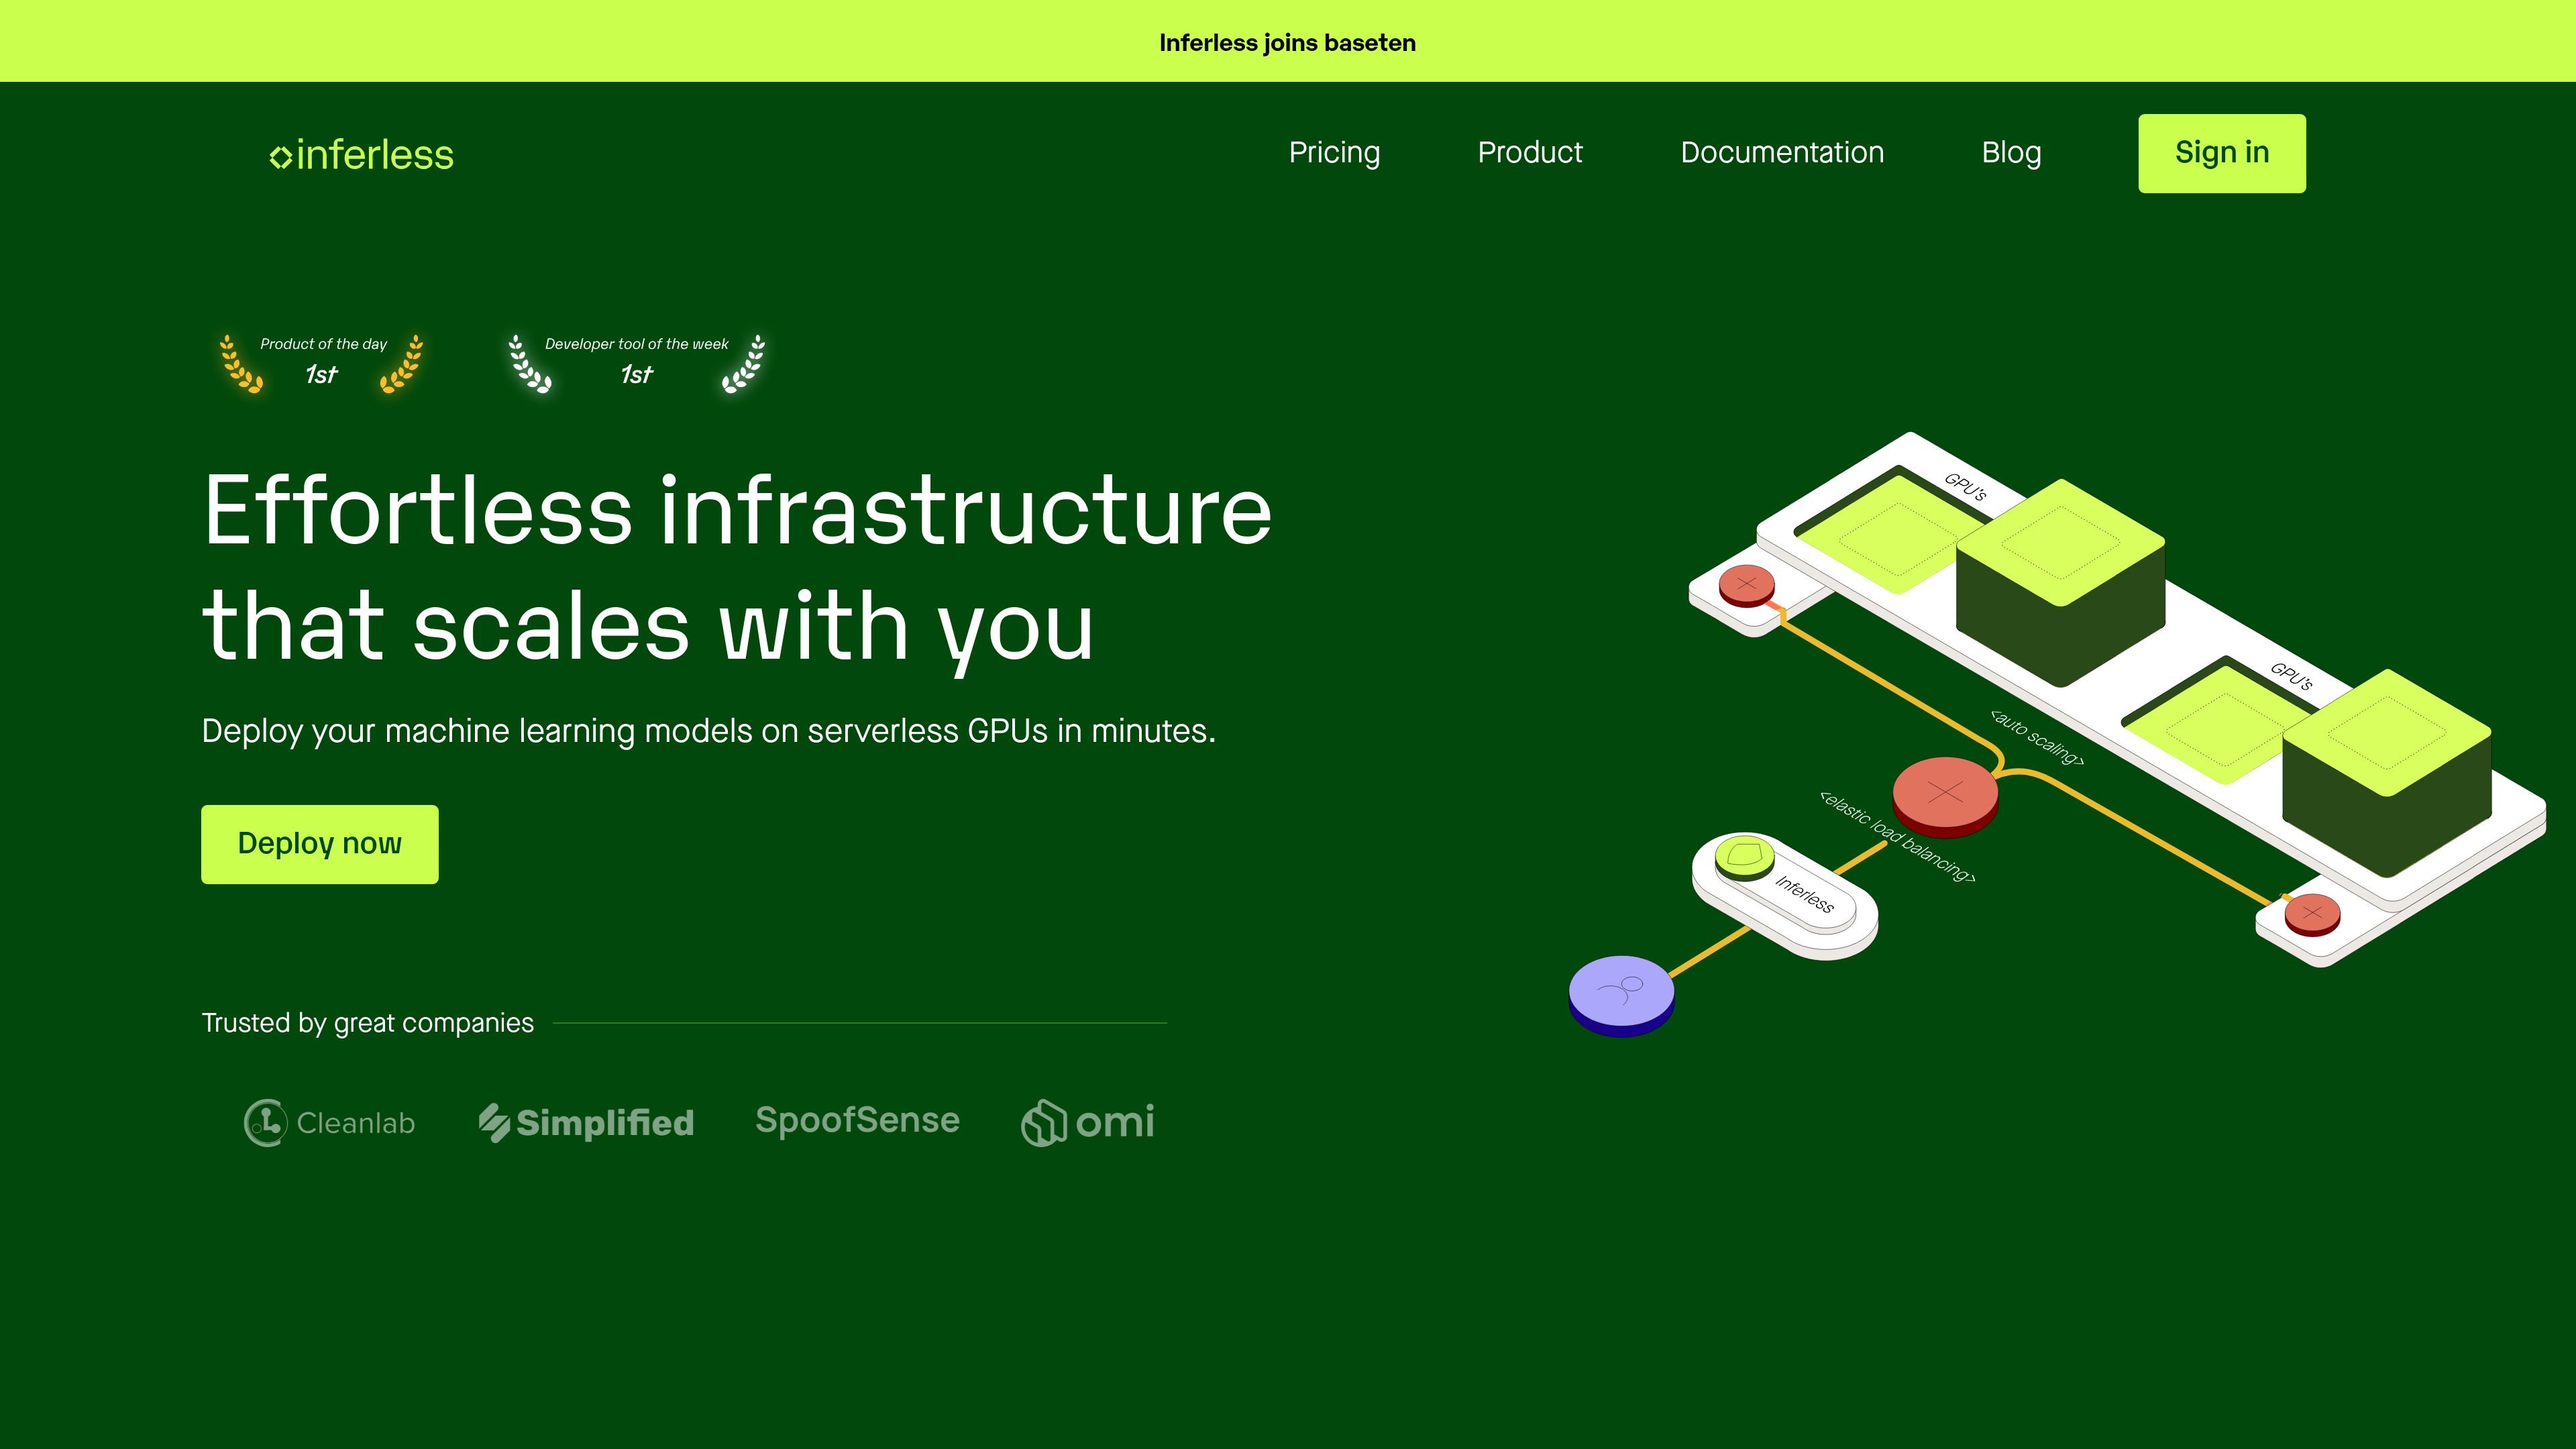
複数のデプロイ方法
Hugging Face、Git、Docker、CLIからモデルをデプロイし、その後は自動再デプロイを使ってコード変更とエンドポイントを同期できます。
Inferlessは、カスタム機械学習モデルをデプロイするためのサーバーレスGPU推論プラットフォームです。ファイルからエンドポイントまで数分でモデルを移行できるように設計されており、インフラを直接管理せずにGPU対応の推論を必要とする本番ワークロード向けに位置づけられています。
このプラットフォームは、Hugging Face、Git、Docker、CLIからのデプロイをサポートし、自動再デプロイ、カスタムランタイム、書き込み可能ボリューム、監視、動的バッチ処理、プライベートエンドポイント設定などの運用制御を追加します。料金ページでは、NVIDIA T4、A10、A100 GPUに対して秒単位課金が示されており、共有インスタンスと専有インスタンスの両方が利用できます。
Hugging Face、Git、Docker、CLIからモデルをデプロイし、その後は自動再デプロイを使ってコード変更とエンドポイントを同期できます。
モデルエンドポイントをゼロから数百台のGPUまでスケールでき、需要に応じて容量を調整する自社製ロードバランサーを備えています。
実行時にモデルが必要とするソフトウェアや依存関係を含めるように、コンテナ環境をカスタマイズできます。
モデルファイルやその他の共有データ向けに、複数レプリカから同時接続できるNFS風の書き込み可能ボリュームを利用できます。
バッチ処理の恩恵を受けるワークロード向けに、サーバー側でリクエストをまとめてスループットを向上できます。
呼び出しログとビルドログを確認し、スケールダウン、タイムアウト、同時実行数、テスト、Webhook設定などのエンドポイント動作を構成できます。
GPUクラスターを直接管理せずに、コンピュータビジョン、NLP、推薦、または科学計算モデル向けのGPU対応推論をデプロイします。
リクエストの増減に応じてエンドポイントをゼロから数百台のGPUまでスケールし、変動の大きいワークロードを処理します。
リクエストのまとめ処理の恩恵を受けるモデルを、動的バッチ処理を使って負荷時のスループット向上のために提供します。
Hugging Face、Git、Docker、またはCLIベースのワークフローでの変更が、手動の再インポートを減らしつつエンドポイントに反映されるように、自動再デプロイのフローでモデル更新を実行します。
より低コストを優先するか、より一貫したリソース割り当てと分離を優先するかに応じて、共有または専有GPUインスタンスを選択します。
InferlessはGPUベースの機械学習モデルをデプロイするために設計されています。ソースの例には、コンピュータビジョン、NLP、推薦、科学計算のワークロードに加え、Llama2 13B、Stable Diffusion ControlNet、Vicuna 7B などのモデルが挙げられています。
ホームページによると、Hugging Face、Git、Docker、またはCLIからデプロイできます。また、自動再デプロイにも対応しているため、手動で再インポートせずにモデル更新を反映できます。
Inferlessは秒単位課金を採用しています。料金は、モデルが正常な状態で実行されている時間と選択したマシンタイプに基づいて算出され、料金ページでは初期費用は不要とされています。
料金ページによると、初回呼び出しでは10〜20秒のコールドスタートが発生する場合があり、その後の呼び出しは推論時間に依存します。つまり、モデルがすでにウォームかどうかによってレイテンシーは変動します。
Inferlessでは、共有インスタンスはGPUリソースを複数ユーザーで分割して低コストを実現し、専有インスタンスは1人のユーザーにGPU全体を確保して、より一貫した性能とデータ分離を提供するとしています。
トラフィックデータは参考情報としてご利用ください。

trysoup.dev
Soup CLIは、ファインチューニング、選好学習、評価、モデルのマージ、デプロイ、データ準備など、ポストトレーニングと関連するモデルワークフローに対応したオープンソースのコマンドラインツールです。ローカルまたは借用したハードウェア上で、単一のオフラインCLIを使ってモデルの学習から提供まで管理したいユーザーに向けています。

kastra.ai
Kastraは、プロンプト、ツール呼び出し、シェルコマンド、APIリクエスト、ブラウザ操作を実行前に検査する、AIシステム向けの認可インフラです。ポリシー適用、署名付き監査証跡の保持、ローカルおよびエンタープライズAIワークフローのガバナンスを支援します。

aakar-ai.dev
AIプロバイダー、プロジェクト設定、ログ、分析を1つのダッシュボードで管理。BYOK対応。

dstack.ai
GPUクラウド、Kubernetes、オンプレミスクラスター向けのオープンソースAIワークロード制御プレーン
ddshub.cc
ClaudeとOpenAI系モデルのワークフロー向けAI APIプラットフォーム。トークン課金と設定ガイドを提供

groq.com
Groq LPUとGroqCloudによる高速・低コストなAI推論