AIテストアシスタントでテストケースの生成、カバレッジ確認、バグ検出、自動テストの効率化を支援します。
カタログ更新日:2026/11/19
AIテストアシスタント
Katalonは、QAチーム向けに手動テスト、自動テスト、AIを活用したテスト生成を一つのワークフローに統合します。Web、モバイル、API、Windowsデスクトップアプリの作成から実行、レポートまでを支援します。
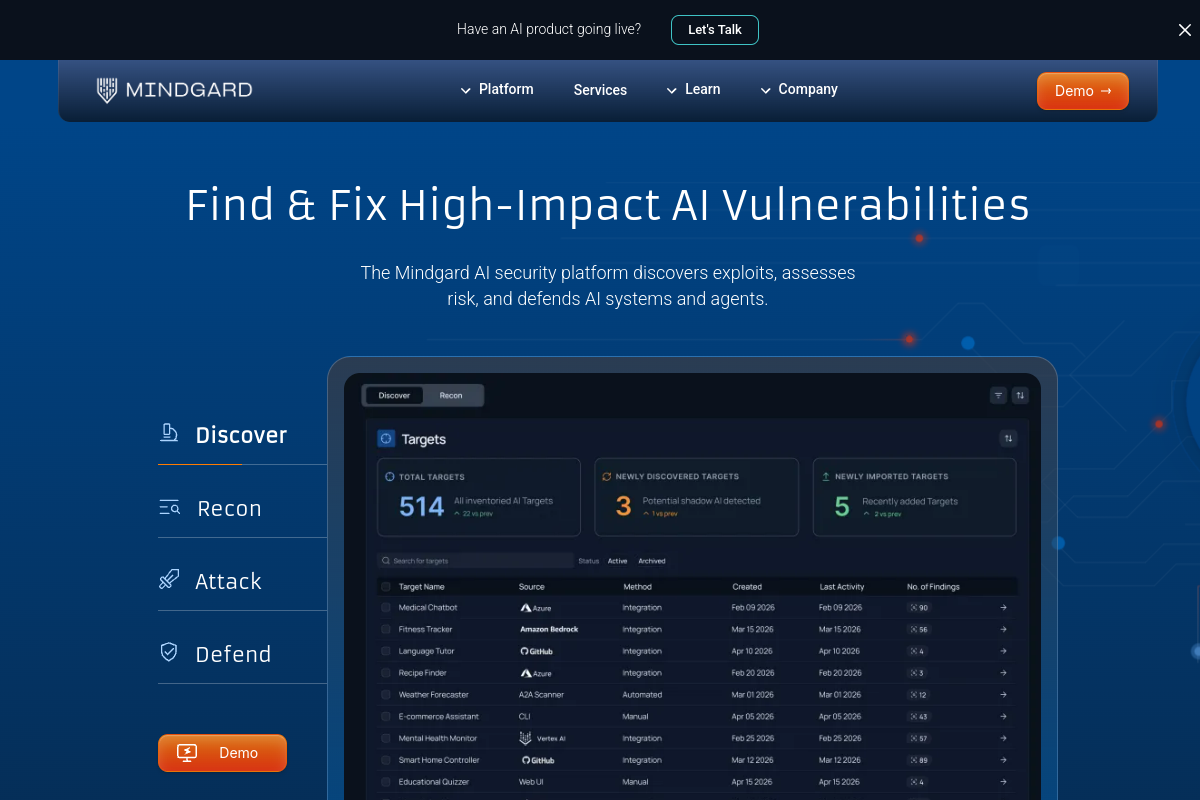
Mindgardは、企業が導入するモデル、エージェント、AIアプリケーションの攻撃面を可視化し、敵対的テストで脆弱性を検証するAIセキュリティプラットフォームです。
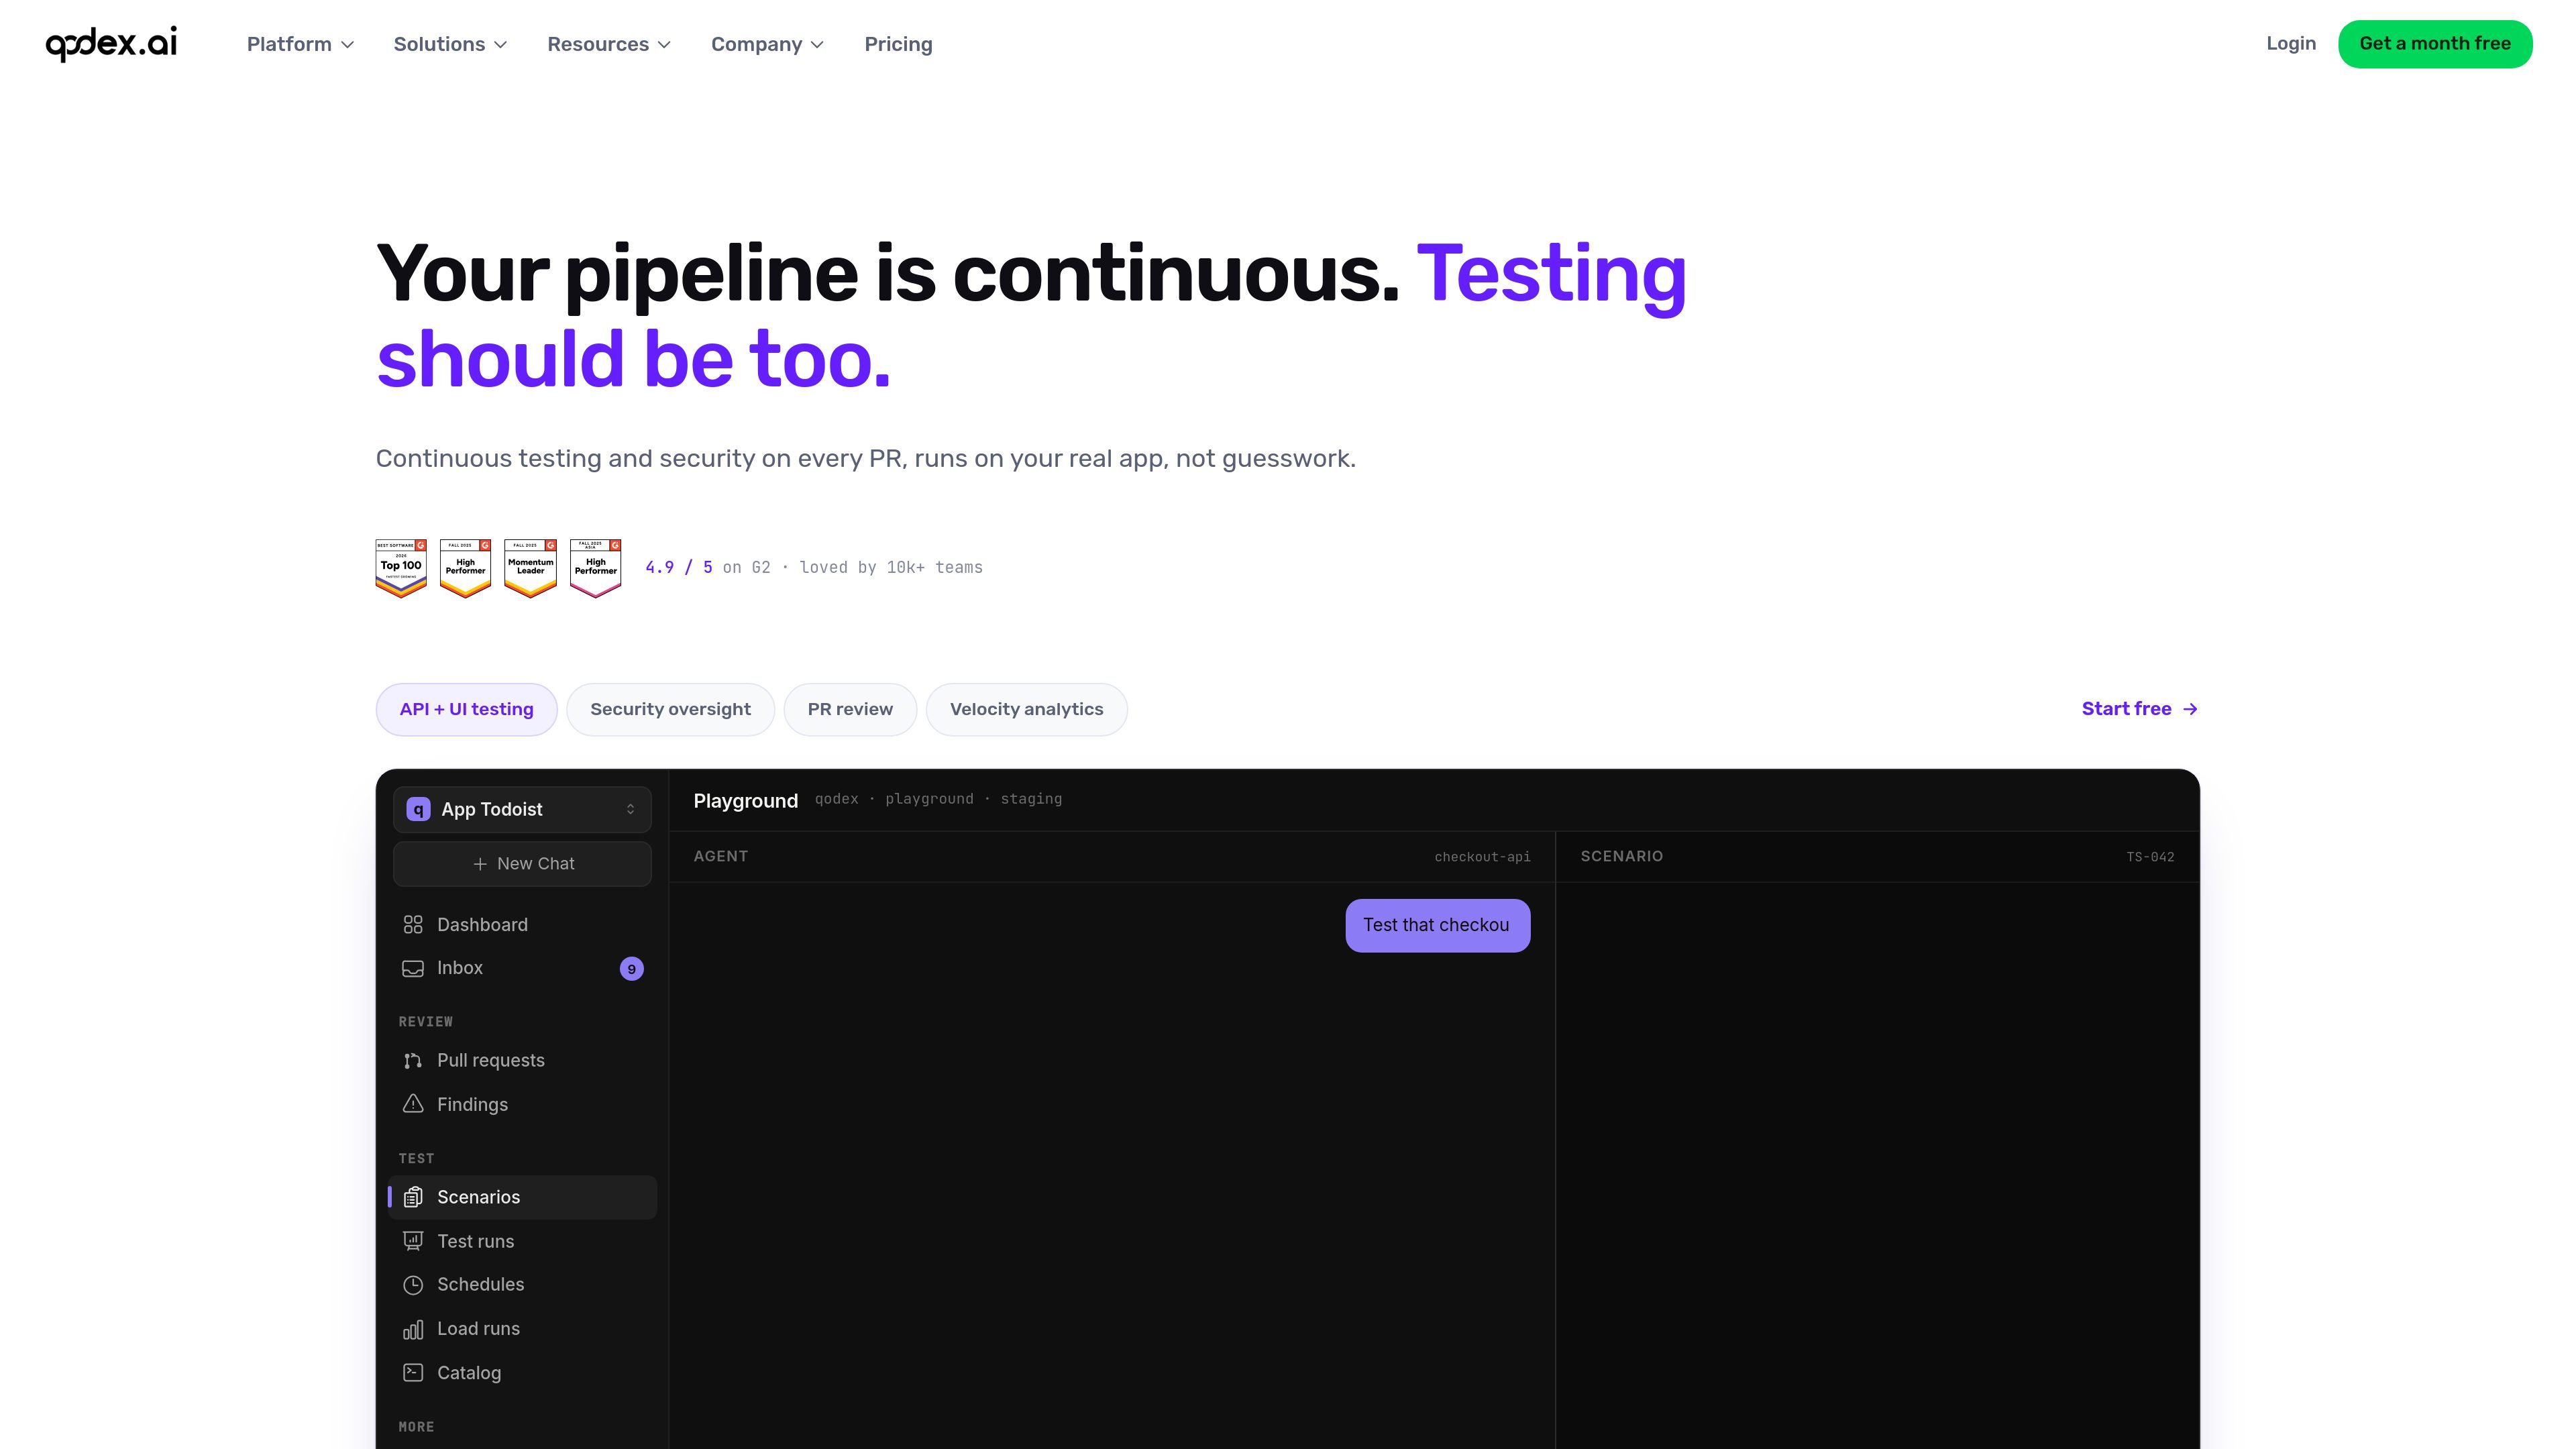
プルリクエストとデプロイで実シナリオを実行する継続的テスト基盤
AI開発者ツール
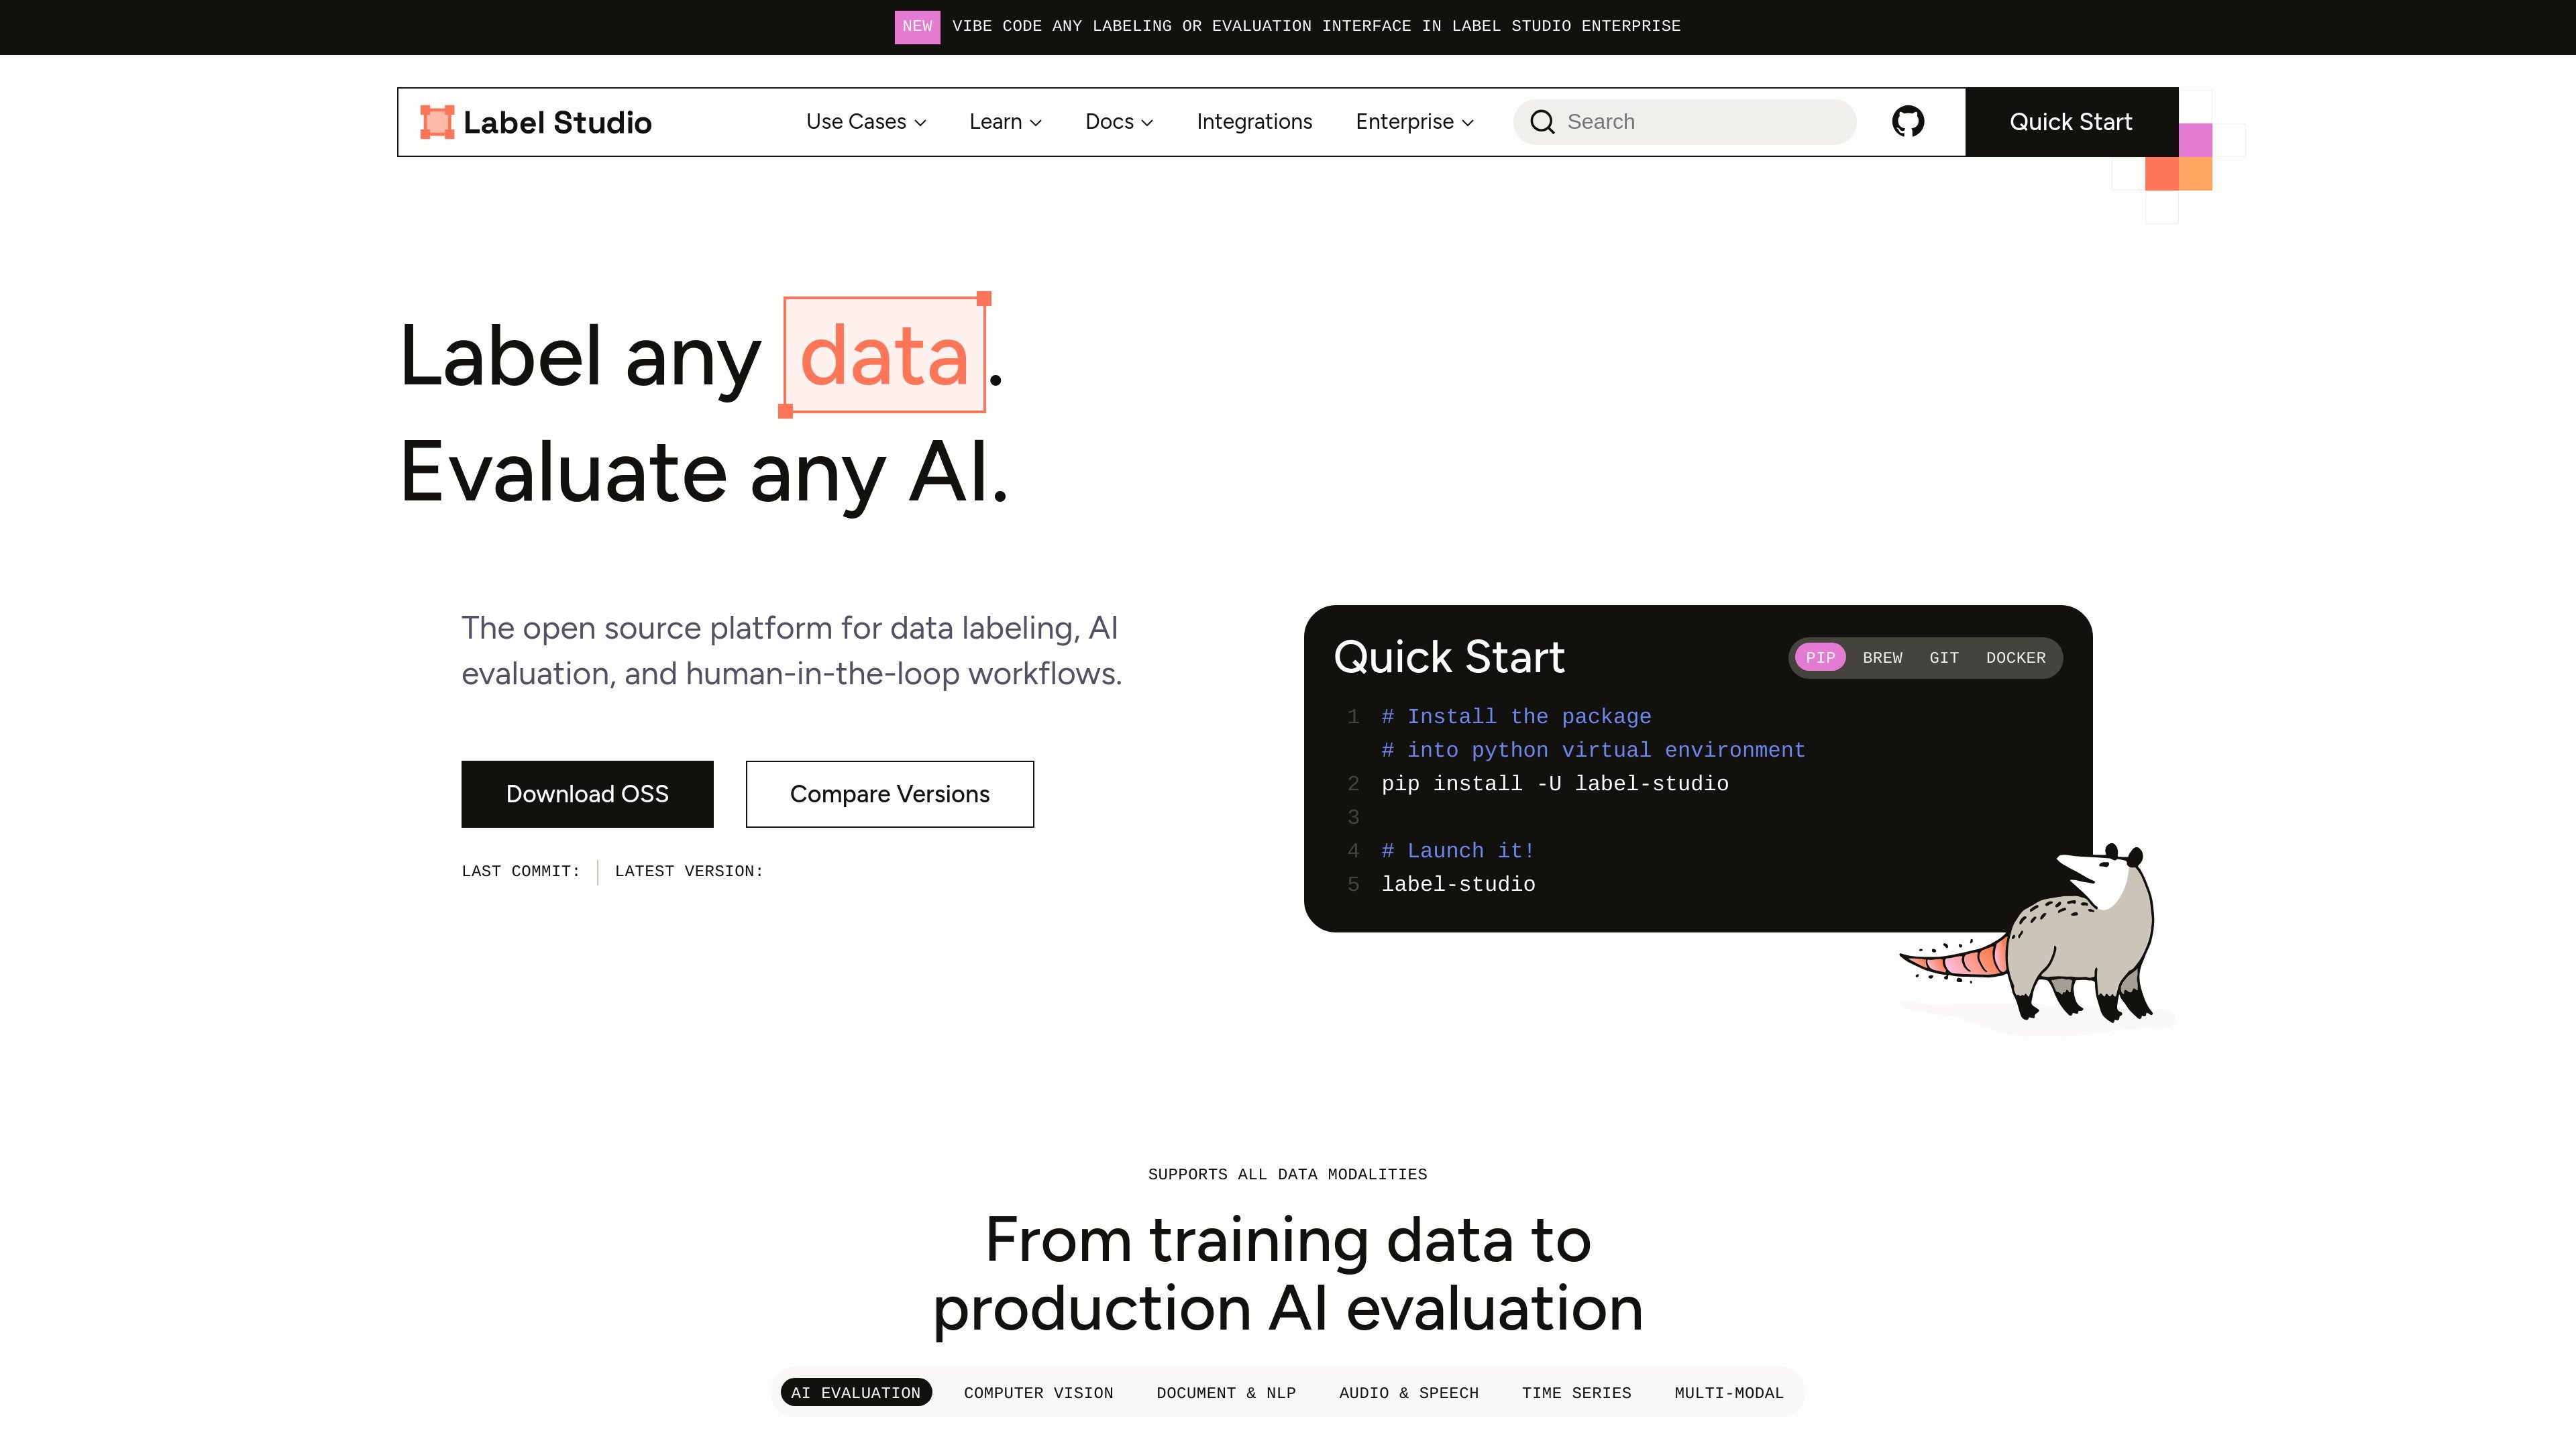
オープンソースのデータラベリング・AI評価プラットフォーム
AIコードアシスタント
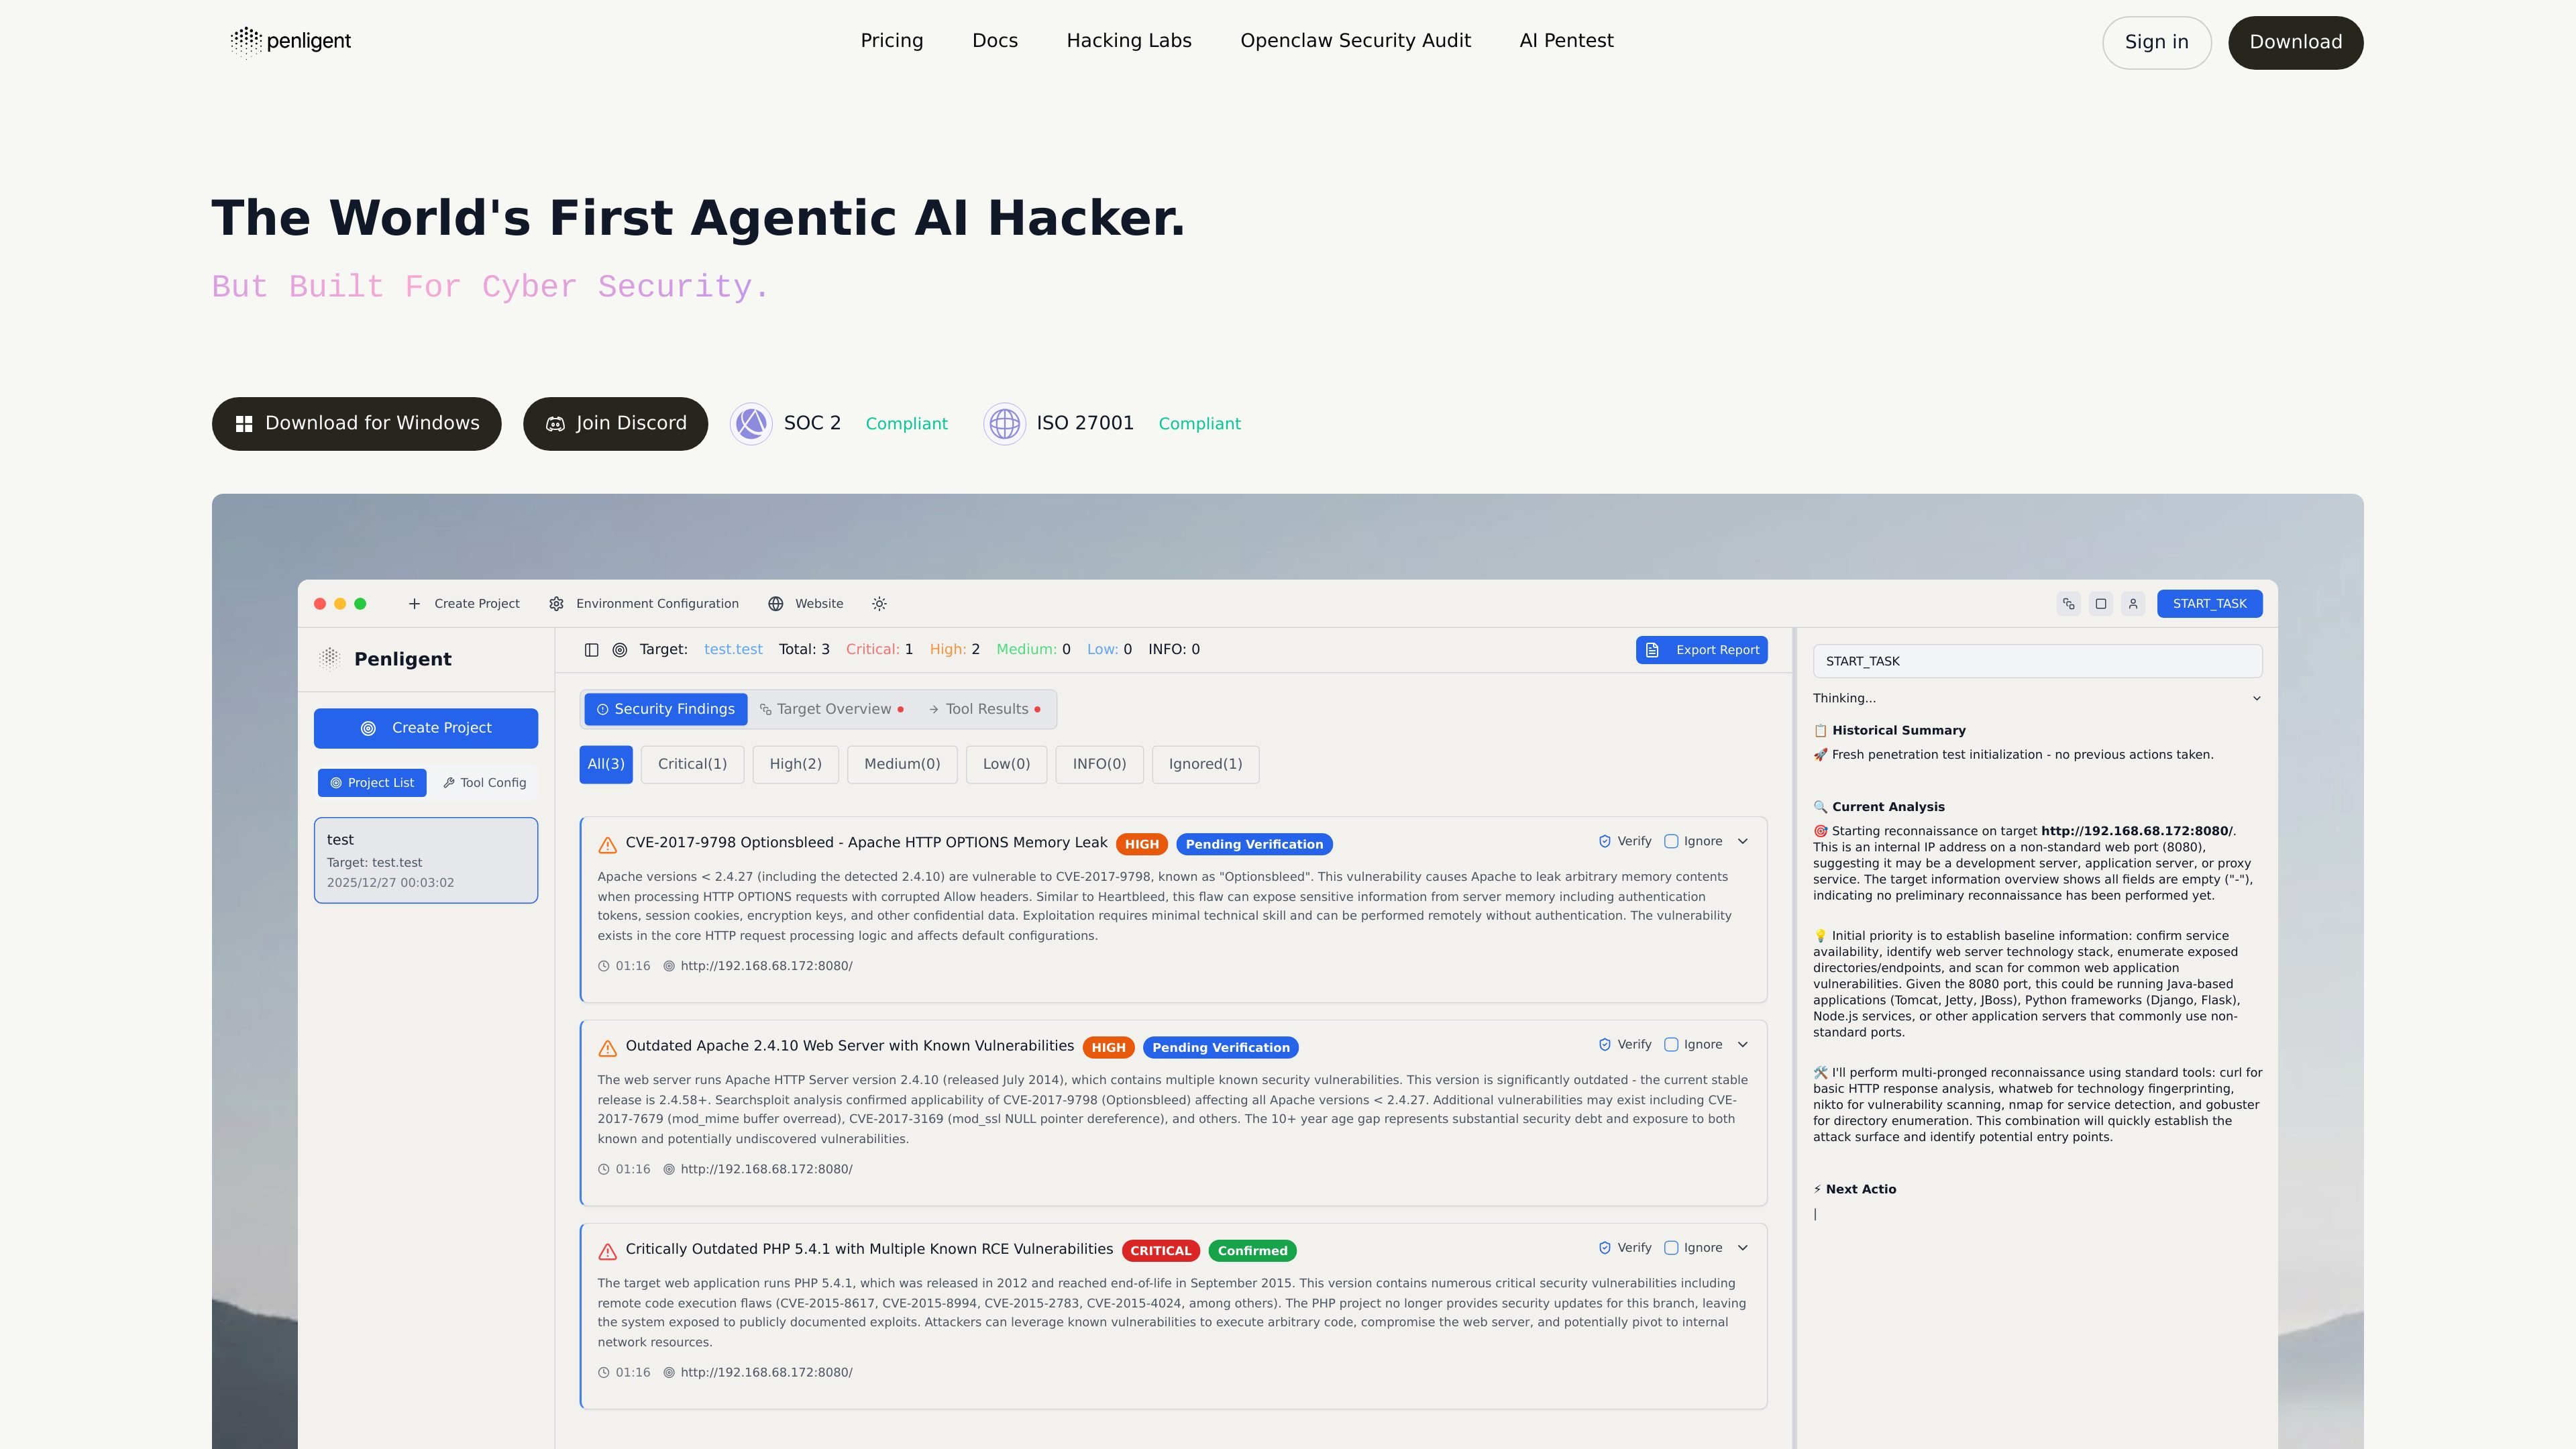
Penligentは、セキュリティチーム、ペンテスター、レッドチーム向けのAI支援型ペネトレーションテスト platformです。Webアプリ、API、ビジネスロジック、AIエージェントの探索、検証、エクスプロイト再現、証拠に基づくレポート作成を自動化します。
プルリクエストの悪用可能な脆弱性を発見するAIコードレビュー・アプリケーションセキュリティツール
AIエージェント開発チーム向けのGenAI評価・可観測性プラットフォーム
実ブラウザ上で自然言語によるテストを作成・実行できるクラウドAI E2Eテスト基盤
AIオブザーバビリティ
LLMアプリ、RAGシステム、AIエージェント、予測機械学習モデルを評価・テスト・監視するオープンソースのフレームワークです。開発時の品質確認から、導入後の変化やリスクの追跡まで支援します。
実行中のフロントエンドやバックエンドを探索してエンドツーエンドテストを作成・実行し、失敗時には証拠付きで報告します。開発者はCLI、IDE、CI、ダッシュボードから利用できます。
Promptfooは、LLMアプリケーション、エージェント、モデル、ワークフローを評価するAIセキュリティ・テスト基盤です。開発者やセキュリティチームが攻撃テストで脆弱性を見つけ、ガードレールを検証し、修正状況を追跡できます。
Galileoは、LLMアプリケーションやAIエージェントのテスト、デバッグ、ガバナンスを支援する評価・可観測性プラットフォームです。評価結果を本番監視やガードレールに結び付け、問題の検出と調査を支援します。
平易な英語の指示や既存の手動テストケースから、編集可能なエンドツーエンドテストを作成できます。Web、モバイル、API、メール、メッセージングのワークフローに対応します。
Web、モバイル、AIアプリ、API向けのエージェント型テスト自動化
DeepEvalは、LLMアプリケーションをテスト・ベンチマークするオープンソースの評価フレームワークです。開発者はpytestとPythonを使い、出力やエージェントの実行トレースを評価できます。
Web、モバイル、Salesforceの操作を記録し、手順を編集して期待結果の検証を追加できます。チームでテストを実行し、失敗箇所のログや結果を確認できます。
Hopliteは、分離された開発環境で作業を実行し、タスクの完了後にプルリクエストを作成できるコーディングエージェントプラットフォームです。エージェントにリポジトリ作業を委任し、リアルタイムのフィードバックと承認を活用したいチーム向けです。
Coarenaは、実際のブラウザ操作タスクを投稿し、最先端のAIエージェント2体がライブで挑戦する様子を見ながら、勝者をブラインド判定できるコンピュータ操作アリーナです。評価用のベンチマーク指標、選好ラベル、データセットアクセスも提供します。
プロンプトとエージェントワークフローのバージョン管理・テスト・監視プラットフォーム
Confident AI は、AI システムのテスト、監視、改善を支援する AI 品質プラットフォームです。