
Investigación con citas
Research planifica consultas, recupera y lee fuentes, vuelve a buscar para cubrir lagunas y sintetiza una respuesta con citas vinculadas a cada afirmación. Según el plan, están disponibles los modos Fast y Balanced.

Tabstack es una API web gestionada para que desarrolladores y agentes obtengan respuestas con citas, extraigan datos estructurados y realicen tareas en sitios públicos.
Tabstack es una API web gestionada desarrollada por Mozilla para aplicaciones y agentes que necesitan obtener resultados de sitios web activos. Se encarga del trabajo entre encontrar fuentes y generar resultados utilizables: leer páginas, cubrir lagunas de información, conciliar fuentes contradictorias y preparar respuestas con citas.
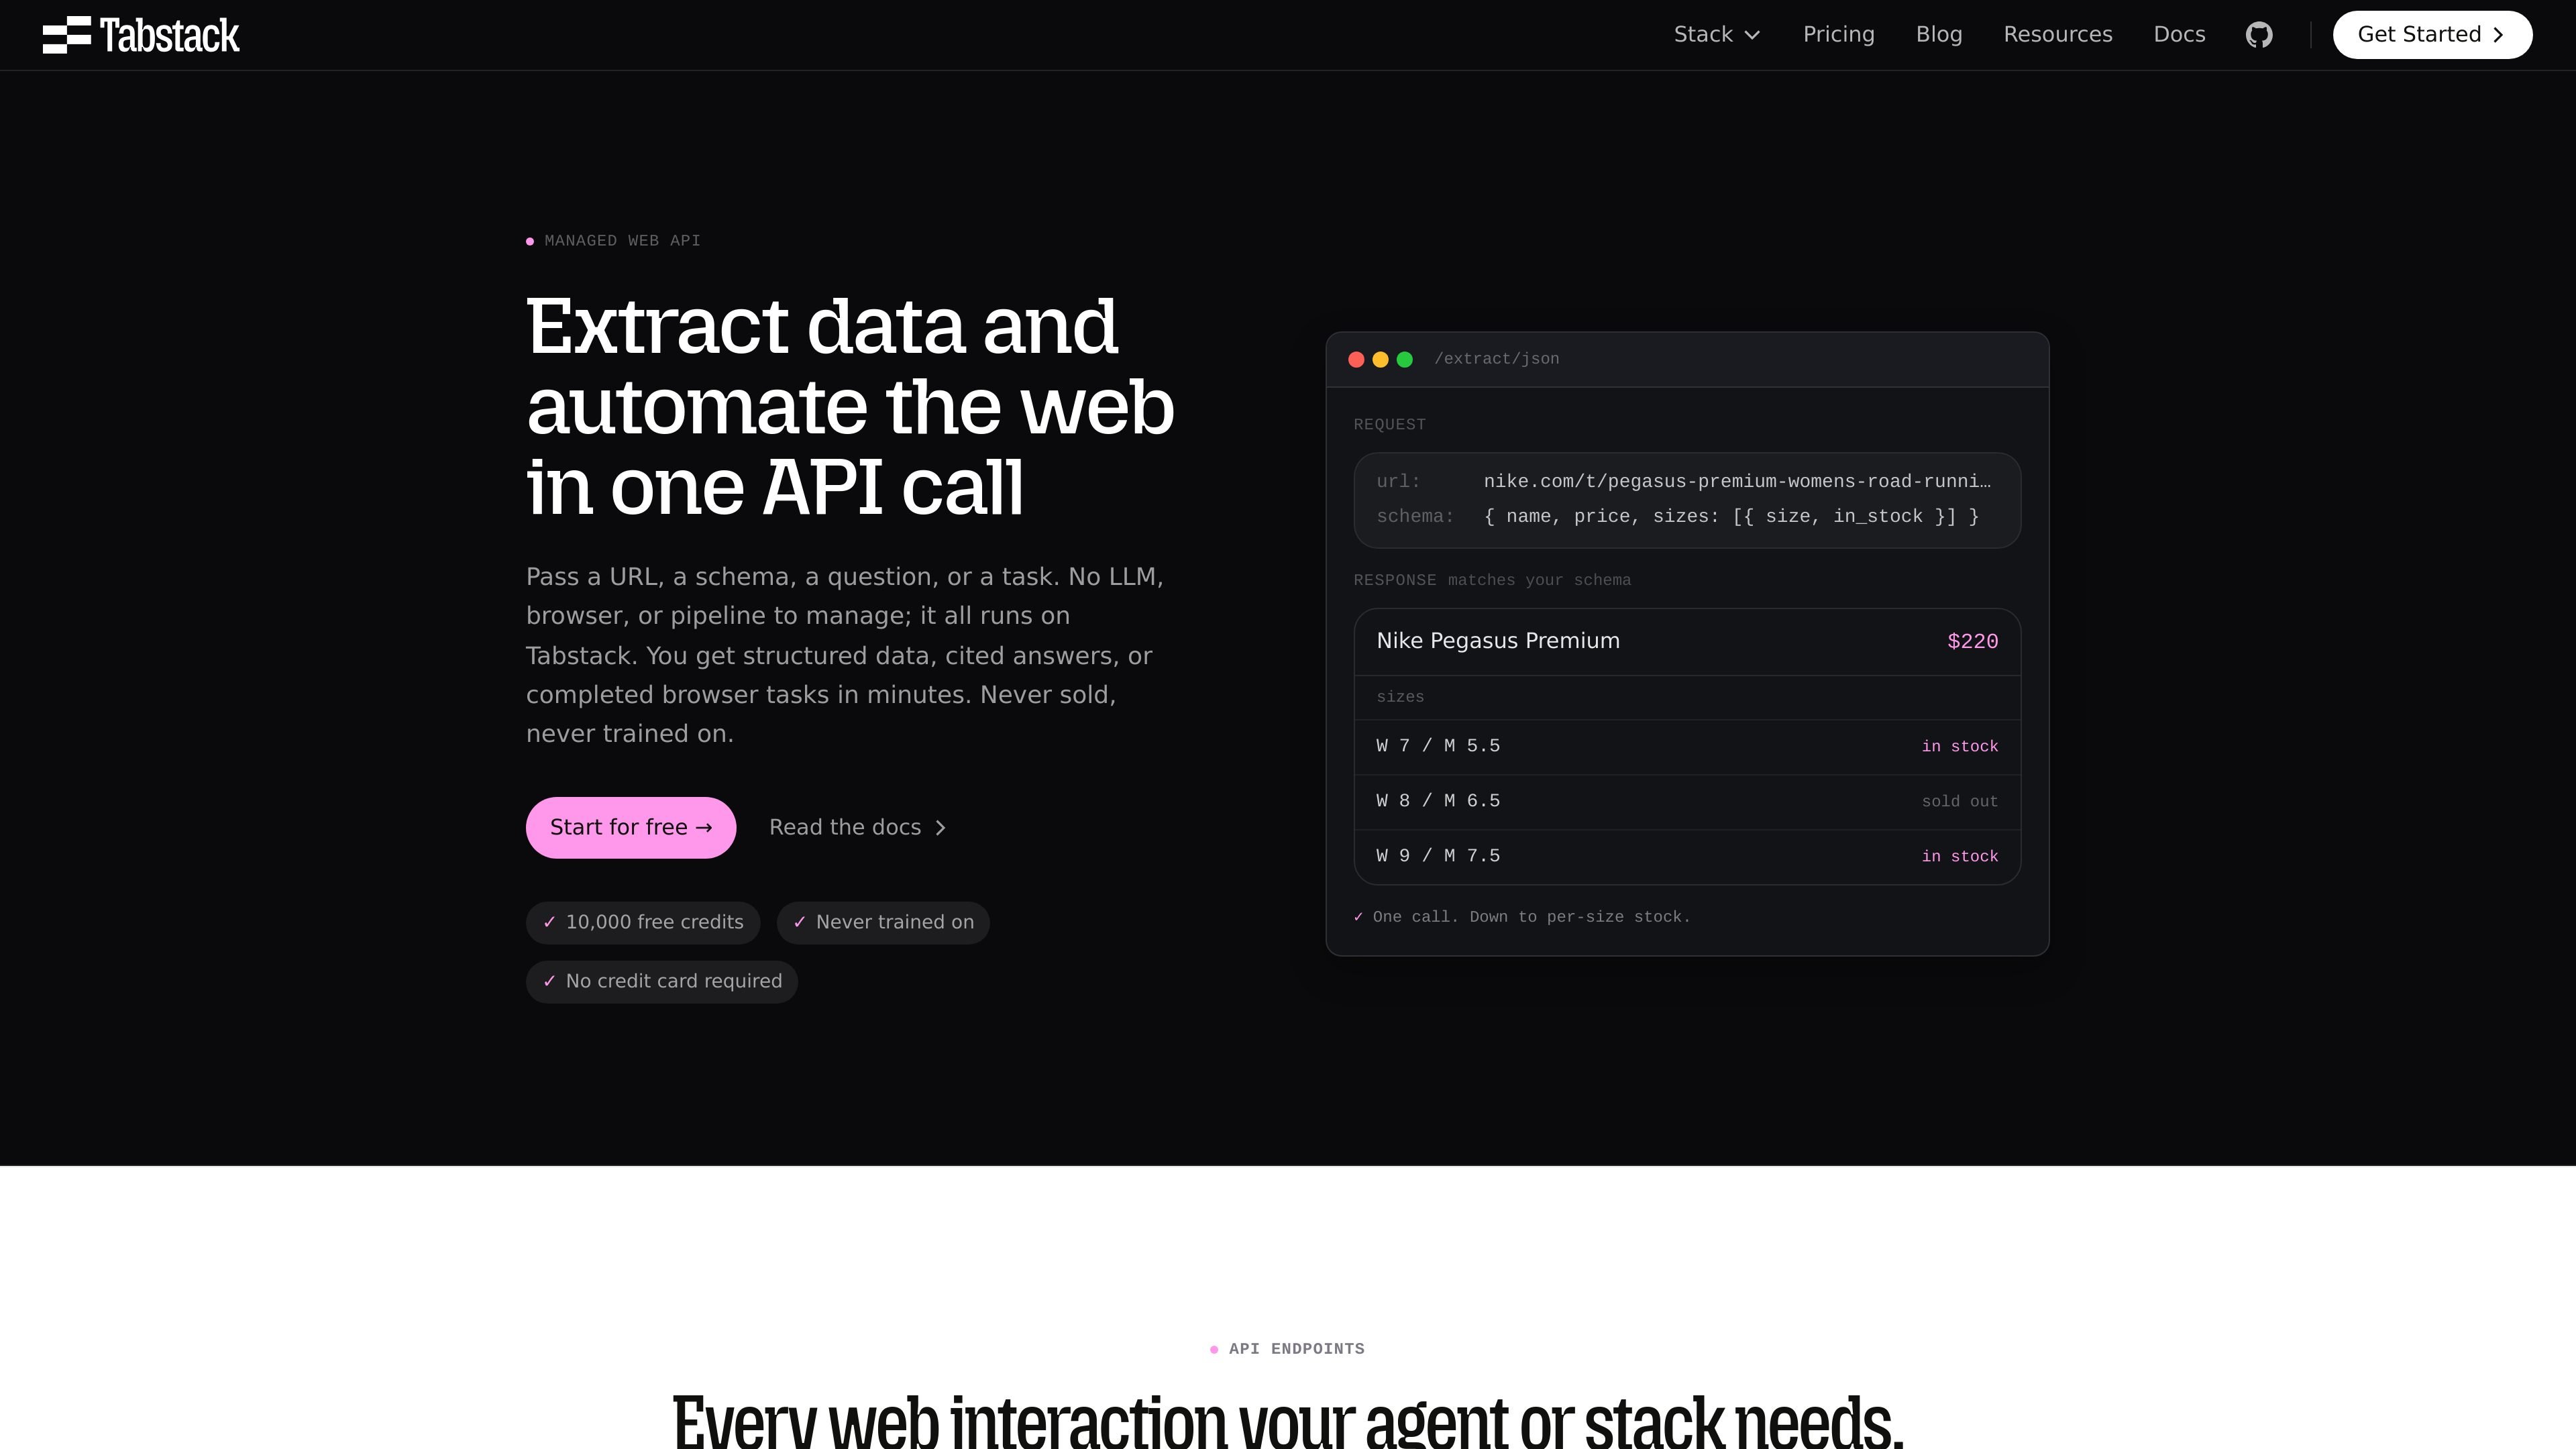
Los desarrolladores también pueden solicitar Markdown limpio, JSON que se ajuste a un esquema definido o la realización de una tarea en un sitio web público. El flujo de trabajo web se ejecuta fuera del modelo que realiza la llamada, por lo que las aplicaciones pueden consumir el resultado sin mantener su propia lógica de búsqueda, renderizado, análisis y citas.
Research planifica consultas, recupera y lee fuentes, vuelve a buscar para cubrir lagunas y sintetiza una respuesta con citas vinculadas a cada afirmación. Según el plan, están disponibles los modos Fast y Balanced.
Extract obtiene y renderiza páginas, incluidos sitios con mucho JavaScript, y devuelve Markdown limpio sin contenido superfluo o JSON que sigue el esquema solicitado.
Generate obtiene una página y usa AI para transformar su contenido en JSON derivado o reformulado, con resultados que van más allá de la extracción directa de campos.
Automate navega e interactúa con sitios web públicos a partir de una URL inicial y una tarea en lenguaje natural. Devuelve el resultado junto con los eventos de la tarea.
Accede a Tabstack mediante Python, TypeScript, HTTP o una CLI. Las integraciones incluyen LangChain, Vercel AI SDK, OpenAI Agents, Claude Agent, Mastra, LlamaIndex, eve y Hermes Agent.
Haz una pregunta a un asistente sobre cambios en versiones o documentación actual y recibe una respuesta con fuentes para evaluar decisiones de implementación.
Extrae contenido legible de un conjunto de fuentes para una base de conocimientos y usa llamadas de extracción repetidas para mantener actualizado el material de referencia.
Define campos como el precio de un producto y extrae de una página JSON con los datos coincidentes para usarlo en el flujo de datos de una aplicación.
Pide a un agente que encuentre una tarifa o complete otra tarea web pública mediante interacciones con un navegador alojado, sin ejecutar un navegador localmente.
Las cuentas nuevas reciben 10 000 créditos gratis, sin necesidad de tarjeta de crédito. Se pueden usar en Research, Extract, Generate y Automate. A las tarifas publicadas, cubren 1000 llamadas de extracción en Markdown o 40 acciones de Fast Research; una tarea de investigación puede implicar varias acciones.
Starter cuesta 10 $/mes e incluye 100 000 créditos y 15 solicitudes/minuto. Team cuesta 99 $/mes e incluye 500 000 créditos y 25 solicitudes/minuto. Pro cuesta 499 $/mes e incluye 3 000 000 de créditos y 100 solicitudes/minuto. Todos incluyen todos los endpoints; Starter ofrece Fast Research, mientras que Team y Pro también ofrecen Balanced. El exceso de uso cuesta 0,30 $ por cada 1000 créditos en Starter y Team, o 0,25 $ en Pro, sujeto a los límites de la cuenta.
No. Automate alojado se limita a sitios web públicos y no puede iniciar sesión. Pilo, el motor de automatización de código abierto de Tabstack, ofrece una opción autoalojada cuando necesitas controlar el navegador.
Tabstack no entrena modelos con los datos enviados por los clientes. La recopilación detallada de datos está desactivada, salvo que la cuenta la habilite. Automate alojado envía el texto de la tarea y el contenido de la página a un proveedor de modelos contratado.
Sí. Tabstack es compatible con aplicaciones que usan modelos en hardware local, en una cuenta de nube privada o a través de un proveedor, manteniendo el control de la capa de aplicación.
Los datos de tráfico son solo como referencia.

www.tinyfish.ai
TinyFish es infraestructura web para agentes de IA que buscan, consultan, navegan y completan tareas en sitios web activos. Ayuda a equipos de desarrollo y empresas a obtener datos web actuales, usar portales autenticados y automatizar flujos de trabajo basados en navegador.
digitalocean.com
DigitalOcean ofrece infraestructura en la nube y servicios gestionados de inferencia y agentes para que los desarrolladores creen, desplieguen y ejecuten aplicaciones y cargas de trabajo de IA.

pipedream.com
Plataforma para desarrolladores que permite crear integraciones de API, automatizaciones de flujos de trabajo y herramientas para agentes de IA, combinando construcción sin código con control a nivel de código.

ona.com
Plataforma para ejecutar agentes y desarrolladores de software con IA en segundo plano, con ejecución gobernada, entornos reproducibles y flujos de trabajo para equipos en la nube o en la VPC del cliente.

bitrise.io
Entornos de desarrollo remotos de Bitrise con máquinas virtuales en la nube bajo demanda para desarrolladores y agentes de IA, usando las mismas máquinas, cadenas de herramientas y cachés que Bitrise CI o Build Hub.
surrealdb.com
Base de datos multimodelo que integra documentos, grafos, vectores, series temporales y datos relacionales en una sola transacción ACID para aplicaciones y agentes de IA.