Oqoqo logo

Oqoqo

Freemium
Visitar

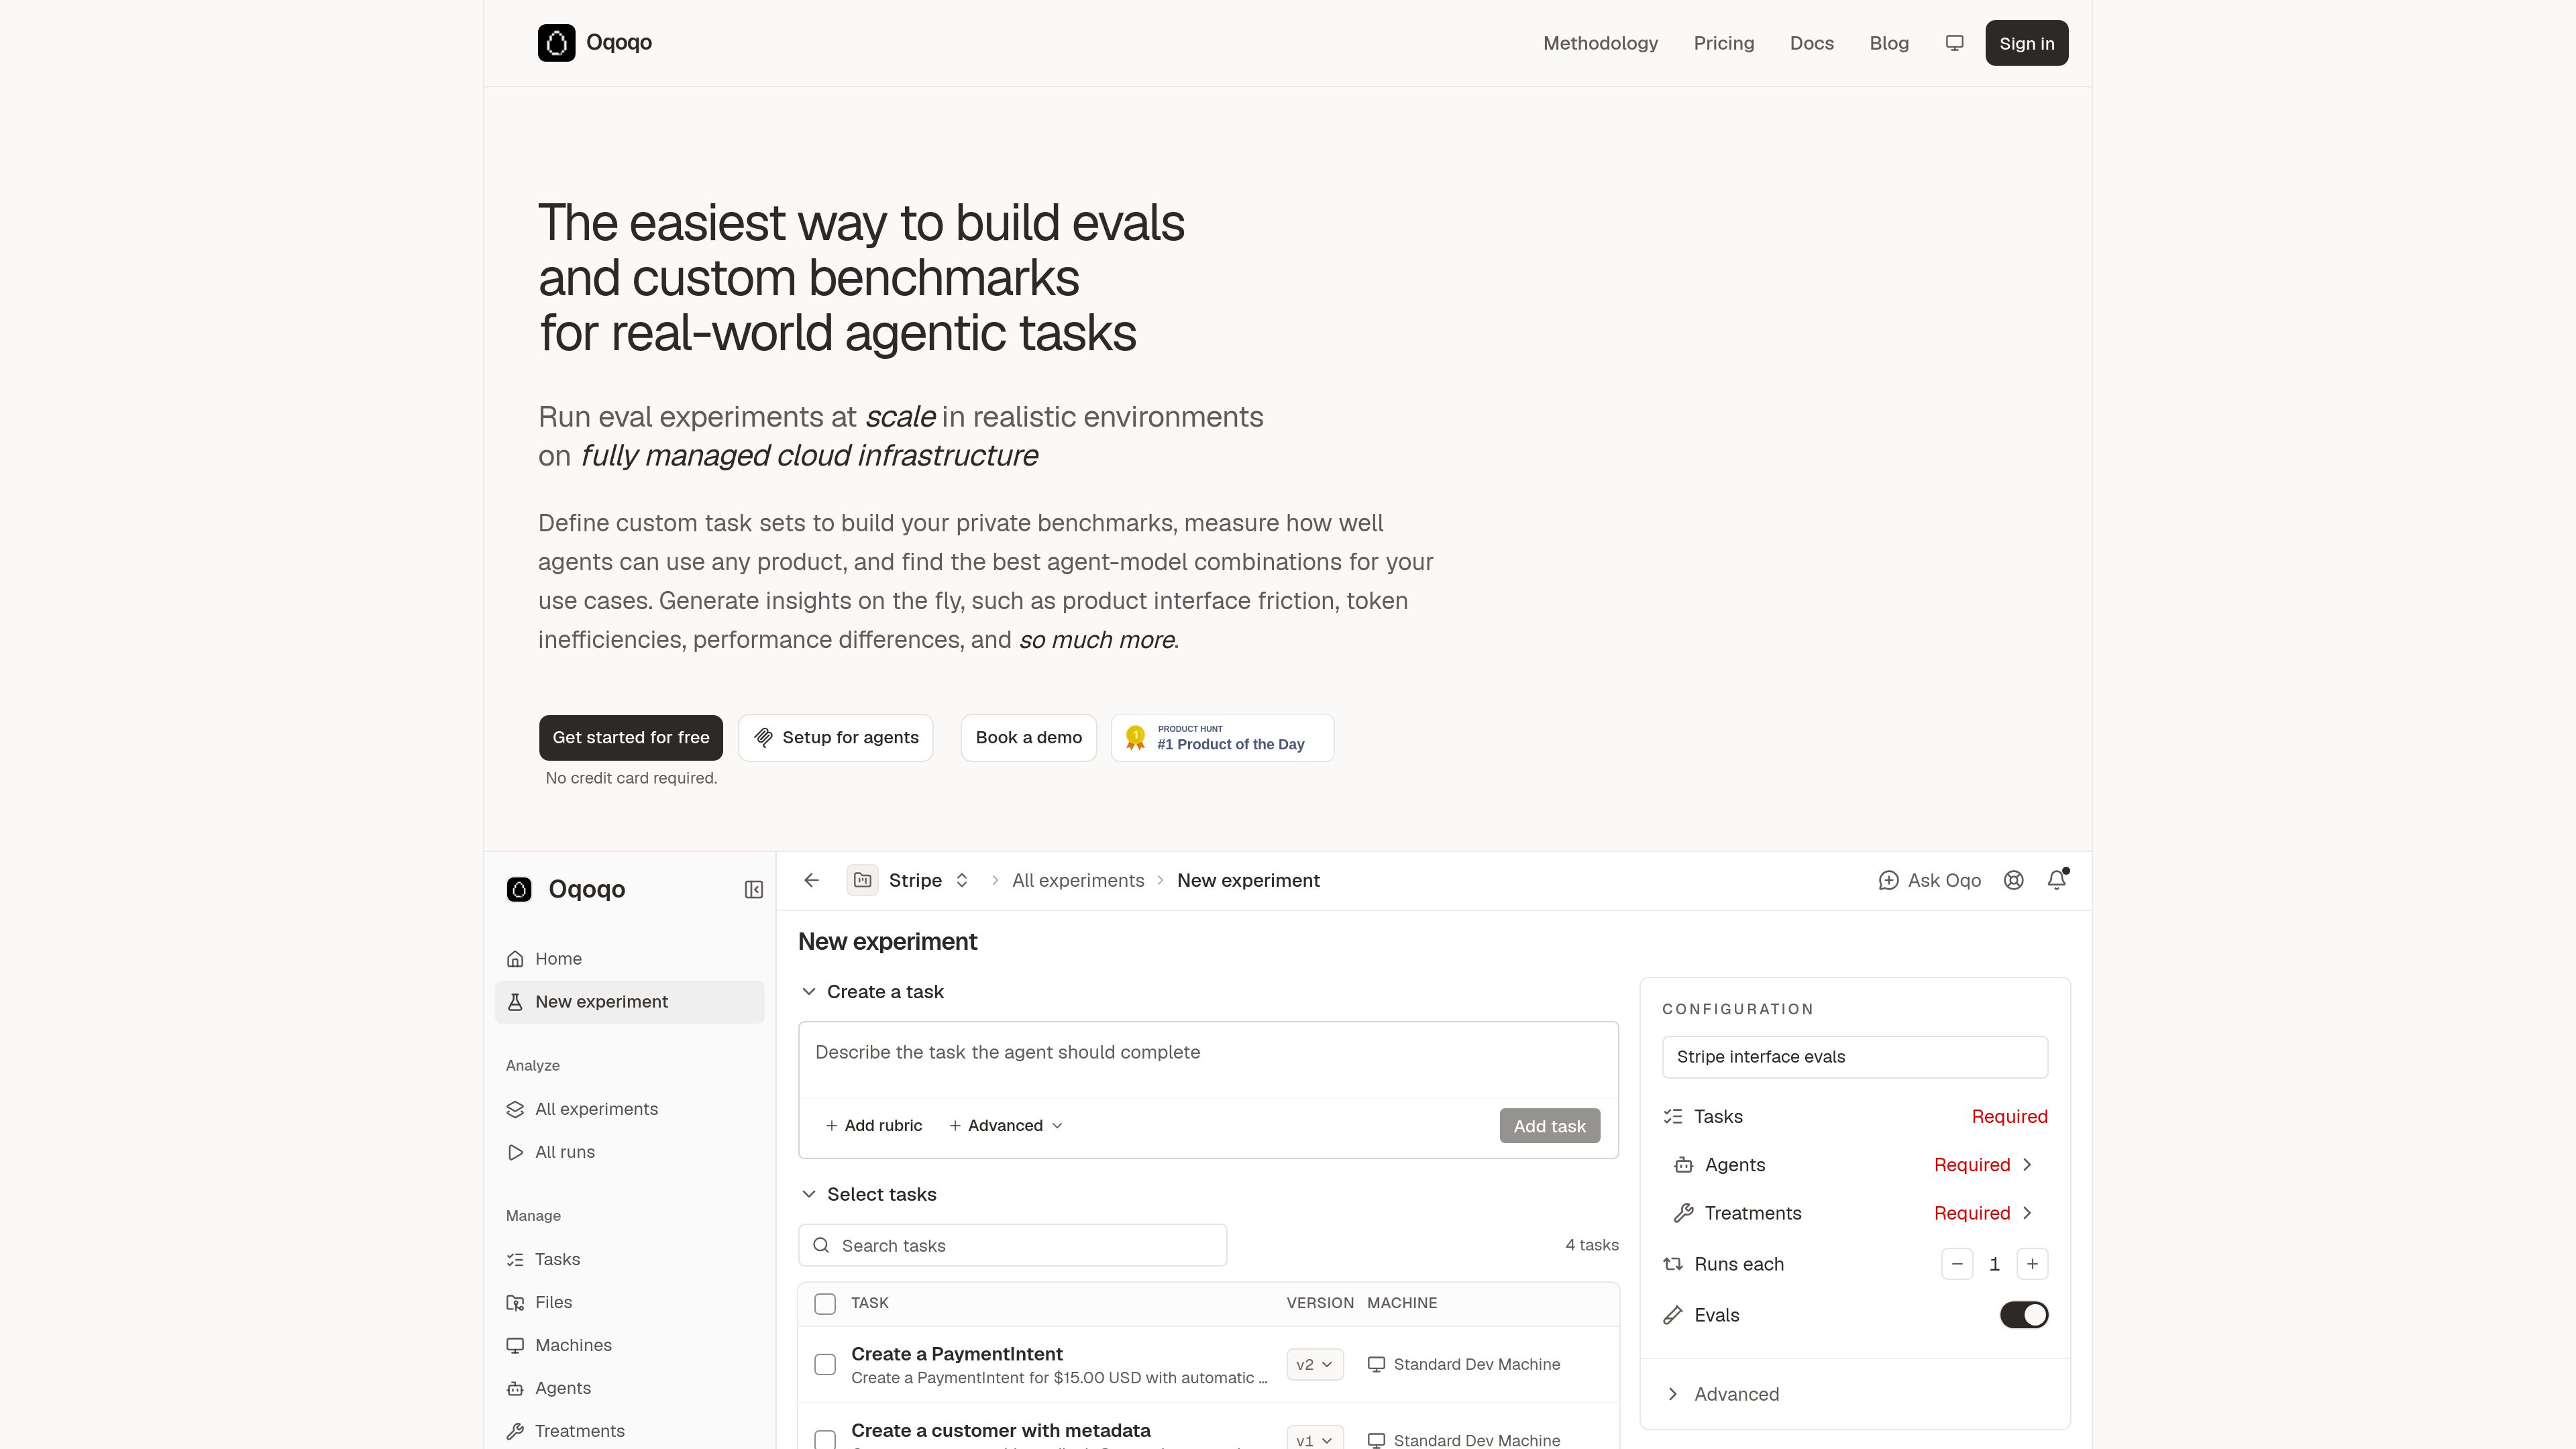
Plataforma de evaluación para ejecutar experimentos repetibles con agentes en entornos realistas y aislados. Permite crear benchmarks privados, comparar agentes y modelos e investigar por qué los flujos de trabajo tienen éxito o fallan.

¿Qué es Oqoqo?

Oqoqo es una plataforma para diseñar, ejecutar y analizar evaluaciones de agentes de AI en tareas del mundo real. Un experimento combina definiciones de tareas y rúbricas con agentes, modelos, configuraciones de esfuerzo, tratamientos de producto y pruebas repetidas, lo que permite a los equipos comparar el comportamiento en condiciones controladas.

Cada prueba se ejecuta en un sandbox nuevo que contiene los archivos del proyecto, las credenciales, las dependencias y las herramientas necesarias para la tarea. Oqoqo registra la trayectoria completa e informa tanto de las medidas de resultados, como la tasa de aprobación y la mejora, como de las medidas operativas, incluidos los pasos, las llamadas a herramientas, los tokens y la duración.

La plataforma está dirigida a equipos que crean benchmarks privados, evalúan productos orientados a agentes o investigan fallos en los flujos de trabajo. Los hallazgos incluyen fricciones respaldadas por evidencias y pueden orientar un ciclo de corrección y nueva ejecución, mientras que los resultados se limitan a las tareas, los agentes, los modelos y los entornos seleccionados para el experimento.

¿Qué puede hacer Oqoqo?

Configuración de experimentos entre productos

Define tareas, requisitos de la rúbrica, agentes, tratamientos y ejecuciones repetidas en un solo experimento. Los tratamientos pueden representar paquetes de habilidades, servidores MCP, CLI o SDK, con una configuración utilizada como referencia para la comparación.

Entornos de prueba nuevos y aislados

Ejecuta cada prueba en un entorno aislado y no reutilizado, con archivos del proyecto, credenciales, dependencias y herramientas instaladas. Los tiempos separados de configuración, trabajo del agente y desmontaje ayudan a distinguir el tiempo de la infraestructura del tiempo del agente.

Captura completa de la trayectoria

Revisa los pasos, las llamadas a herramientas, los comandos, las salidas y los archivos modificados durante una ejecución. La trayectoria registrada muestra dónde se detuvo un agente o tomó un camino improductivo, en lugar de reducir el resultado a una única puntuación.

Evaluación a nivel de requisito

Evalúa cada requisito de la rúbrica con un resultado de aprobado o no aprobado, un motivo y una cita de la ejecución. El trabajo registrado puede volver a evaluarse después de cambiar la rúbrica sin ejecutar de nuevo el agente.

Métricas comparativas y análisis de fricciones

Compara las tasas de aprobación y la mejora de tratamientos y agentes junto con los pasos, tokens, llamadas a herramientas y duración. Los hallazgos de fricción agrupados describen el obstáculo, la gravedad, la recuperación, el responsable probable y las evidencias de la trayectoria que los respaldan.

Acceso web, CLI y MCP

Las personas pueden iniciar experimentos desde la aplicación web, mientras que los agentes pueden iniciarlos mediante acceso CLI o MCP. Las tareas y las configuraciones de los experimentos tienen versiones, y al iniciar se toma una instantánea de los tratamientos, las habilidades y el entorno utilizados.

Casos de uso

“Crear un benchmark privado para un flujo de trabajo de producto”

Convierte flujos de trabajo del mundo real en conjuntos de tareas versionados con rúbricas explícitas. Las pruebas repetidas proporcionan un benchmark propiedad del equipo para los flujos representados por esas tareas.

“Comparar combinaciones de agentes y modelos”

Ejecuta la misma cuadrícula de tareas, tratamientos y pruebas con distintos agentes, modelos y configuraciones de esfuerzo. Utiliza las tasas de aprobación, la mejora, los tokens y la duración para comparar conjuntamente los resultados y el coste operativo.

“Evaluar interfaces y herramientas orientadas a agentes”

Prueba si los agentes pueden utilizar una configuración de producto que incluya habilidades, servidores MCP, CLI o SDK. Compara un tratamiento de referencia con una configuración mejorada para medir el efecto del cambio.

“Diagnosticar y corregir ejecuciones fallidas”

Inspecciona la trayectoria y las citas de los requisitos para localizar el fallo, y utiliza las evidencias de fricción para distinguir problemas del producto, la documentación, el entorno, el arnés, el agente y la tarea antes de volver a ejecutar.

“Activar evaluaciones desde flujos de desarrollo”

Utiliza el acceso CLI o MCP para iniciar experimentos cuando un cambio pueda afectar a los flujos de trabajo de los agentes. Las tareas versionadas y los tratamientos guardados en instantáneas ayudan a mantener identificable la configuración medida.

Preguntas frecuentes

¿Qué es una ejecución en Oqoqo?

Una ejecución es un intento de un agente en una tarea y bajo un tratamiento. Las ejecuciones con errores o canceladas no se descuentan del grupo de ejecuciones de la organización. La inferencia del modelo es independiente de las tarifas de plataforma e infraestructura de Oqoqo.

¿Cómo evalúa Oqoqo una tarea?

Un evaluador revisa la trayectoria registrada y los archivos modificados requisito por requisito. Cada requisito recibe un resultado de aprobado o no aprobado, con un motivo y una cita de la ejecución; la tarea se aprueba únicamente cuando se cumplen todos los requisitos.

¿Se puede cambiar una rúbrica sin volver a ejecutar el agente?

Sí. El trabajo registrado permanece fijo, por lo que se puede aplicar una rúbrica revisada mediante una reevaluación de la misma ejecución. Si cambia la tarea en sí, la metodología de Oqoqo indica que se debe iniciar un nuevo experimento.

¿Qué mide Oqoqo además de la tasa de aprobación?

Los informes incluyen la mejora frente a una referencia, los pasos, las llamadas a herramientas, los tokens y la duración. El análisis de fricciones identifica obstáculos específicos y registra su familia, gravedad, recuperación, responsable probable y las evidencias de la trayectoria que los respaldan.

¿Cuáles son las principales limitaciones de los resultados?

Los resultados describen únicamente las tareas seleccionadas y no establecen el rendimiento en todos los flujos de trabajo. También dependen de los agentes, modelos y configuraciones de esfuerzo utilizados, que pueden cambiar con el tiempo. Los juicios del evaluador pueden ser incorrectos, por lo que conviene comprobar los motivos y las citas de los veredictos.

Datos rápidos

Categoría
Evaluación de AI y herramienta para desarrolladores
Usuarios principales
Equipos que crean o prueban productos y flujos de trabajo orientados a agentes
Acceso
Aplicación web, CLI y MCP
Modelo de ejecución
Pruebas repetidas de agentes en sandboxes nuevos y aislados en la nube
Plan gratuito
100 ejecuciones del plan al mes; las ejecuciones del plan no utilizadas no se acumulan
Modelo de facturación
Las ejecuciones de Oqoqo cubren las tarifas de plataforma e infraestructura en la nube; la inferencia del modelo es independiente

Análisis de tráfico de Oqoqo

Los datos de tráfico son solo como referencia.

Valoración del dominio
11

Alternativas a Oqoqo

Artificial Analysis logo

Artificial Analysis

artificialanalysis.ai

Plataforma independiente de evaluación y análisis de IA para comparar modelos, proveedores de inferencia y hardware, con planes Pro y Enterprise y una API gratuita con datos de benchmarks y límites de uso.

SuperAnnotate logo

SuperAnnotate

superannotate.com

Plataforma de datos de IA para crear flujos de anotación y evaluación de imágenes, vídeo, texto y audio.

OpenTrain AI logo

OpenTrain AI

opentrain.ai

Marketplace y servicio gestionado para contratar formadores de IA, etiquetadores de datos y expertos de dominio previamente evaluados, para RLHF, evaluación, red teaming, anotación y flujos de trabajo con agentes en tus herramientas actuales.

micro1 logo

micro1

micro1.ai

micro1 combina software y expertos de dominio para crear conjuntos de datos de entrenamiento y evaluar el comportamiento de modelos y agentes para equipos de IA.

ComputeArena logo

ComputeArena

computearena.ai

Directorio comunitario de benchmarks para medir el rendimiento de modelos de IA locales en distintos chips, cuantizaciones y entornos de ejecución.

Horizon logo

Horizon

labelbox.com

Producto de entornos RL de Labelbox para posentrenamiento y evaluación de tareas de IA de largo alcance.