
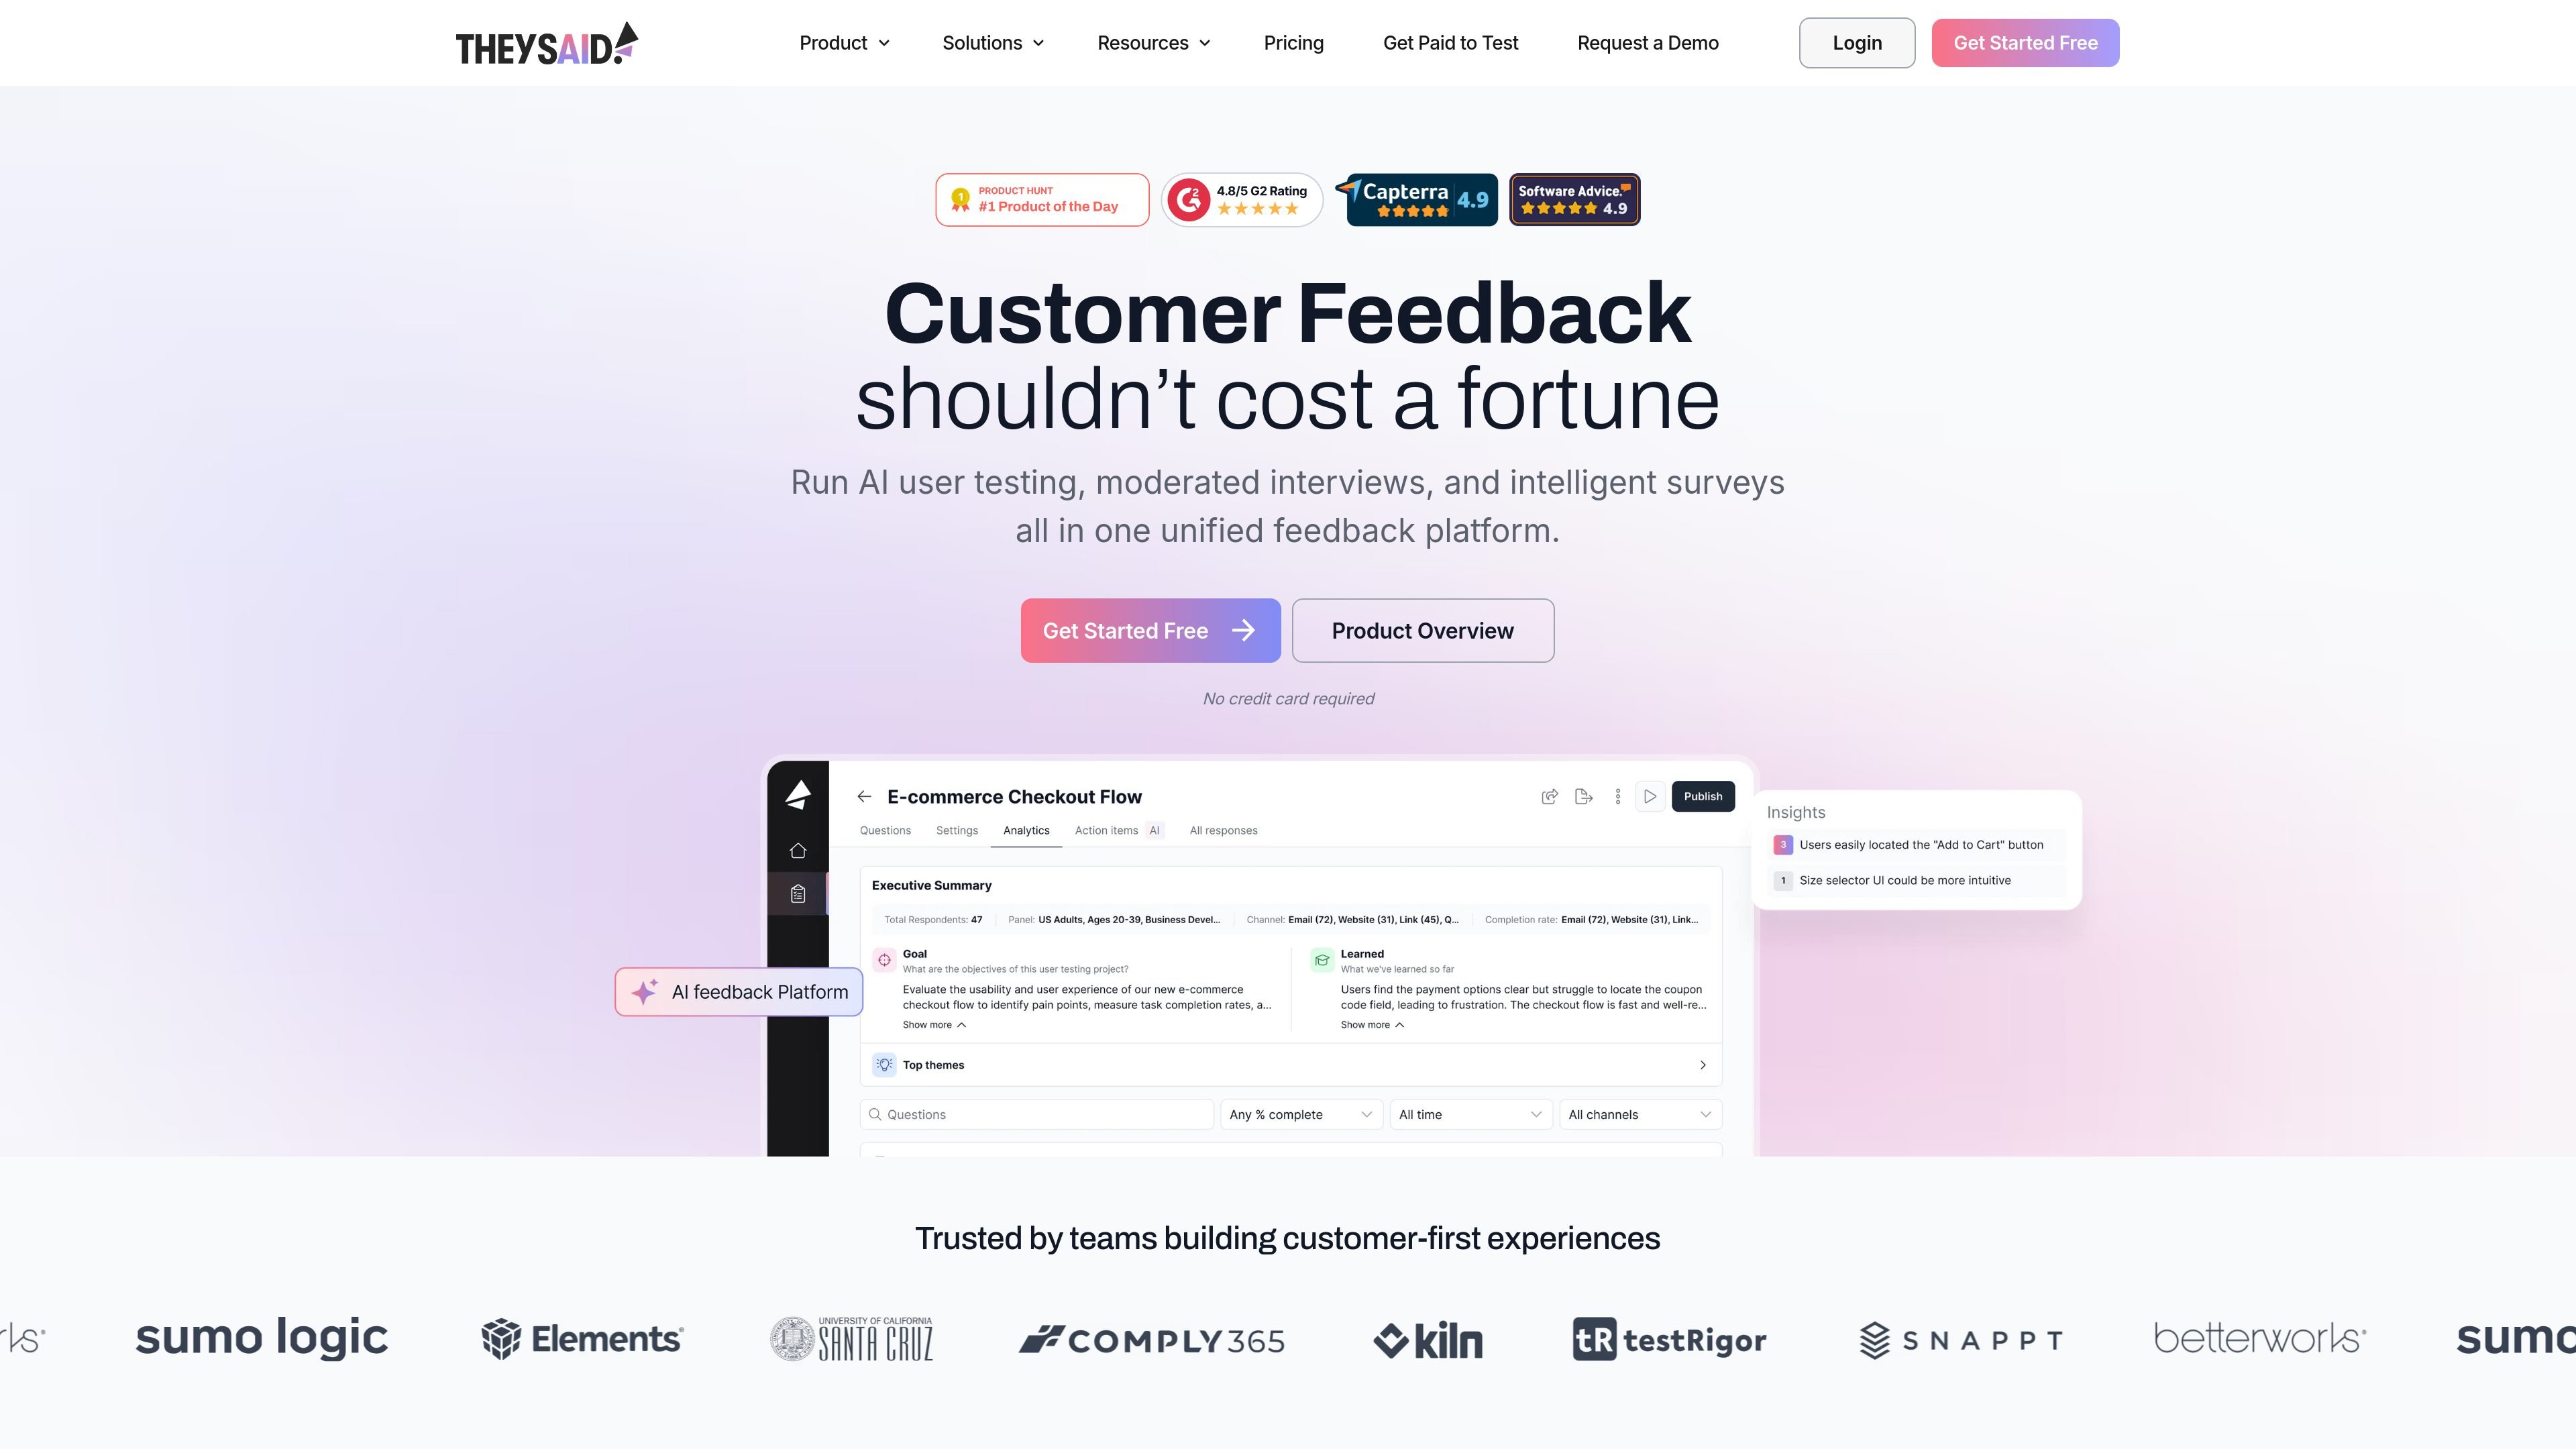
AI 引导的真人测试
参与者打开测试链接,完成引导任务,并分享屏幕和想法。AI 会提出后续问题,并记录屏幕活动、语音反馈和带时间戳的行为数据。

TheySaid 面向产品经理、设计师和研究人员,通过真人参与者或基于客户数据的模拟用户测试设计与可用产品。AI 引导测试并分析反馈,帮助团队在发布前评估可用性,也支持问卷、访谈和投票。
TheySaid 是面向产品经理、设计师和研究人员的 AI 用户研究平台。它通过真人参与者或基于客户数据的模拟用户测试设计和可用产品,帮助团队在发布前评估可用性。它还支持问卷、访谈和投票。
团队可以通过 Claude Code、Cursor、v0、Replit 和 Lovable 等工具请求验证。测试会记录参与者完成任务的方式,AI 则分析反馈并返回研究结果,帮助团队据此改进工作。
参与者打开测试链接,完成引导任务,并分享屏幕和想法。AI 会提出后续问题,并记录屏幕活动、语音反馈和带时间戳的行为数据。
使用选定的通话录音、问卷、支持工单或 CRM 数据调整模拟测试者。预构建的市场用户群体可作为起点,并提供 Fast 和 Full 模式以适应不同的会话深度。
生成摘要、任务完成指标、任务耗时统计、反复出现的问题模式和按优先级排序的建议。带时间戳的文字记录和重点片段帮助团队检查证据。
通过 MCP 运行测试,或在工单进入“设计完成”等阶段时触发验证。研究结果会附加到工单,并在编辑器中提供用于处理已发现问题的建议提示词。
在参与者测试前,根据产品规格和最佳实践检查体验。团队还可以在合并拉取请求前,根据规格检查可运行的构建版本。
通过其他研究形式收集可用性测试之外的反馈。企业版选项包括条件逻辑、项目模板、跨项目洞察以及自定义 API 和 webhook。
使用模拟用户群体在确定方向前探索不同方案。在一份报告中比较买家、终端用户和高管对同一设计的反应。
让参与者完成定价页面、结账步骤或引导流程,以发现令人困惑的信息以及他们难以完成任务的环节。
在继续投入开发之前,使用现有客户或经过筛选的参与者测试拟议功能或原型。
使用 Critical Experiences 对发布后的客户旅程各阶段进行评分,并通过 Experience Hub 将反馈证据带入待办工单。
用户测试免费方案每月包含 5 次 AI 用户测试和 50 次 AI 问卷、1 个工作区以及 1 个活动中的测试。它还包括 AI 项目创建、引导和分析功能。无需信用卡。企业版价格需定制。
对于真人测试,参与者点击测试链接,在分享屏幕和想法的同时完成引导任务。网站说明无需下载或进行技术设置。
TheySaid 将模拟测试者定位为用于缩小选项范围和辅助早期设计决策,几分钟即可获得结果。真人测试则使用客户或招募的参与者,在做出更大投入前提供直接证据。
团队可以选择用于调整模拟用户群体的客户数据来源、AI 解读这些数据的方式,以及 AI 可以据此采取的行动。真人测试还支持筛选问题和 Response Quality Monitor,用于过滤不合适的参与者和敷衍的回答。
流量数据仅供参考。


