自动扩缩容推理
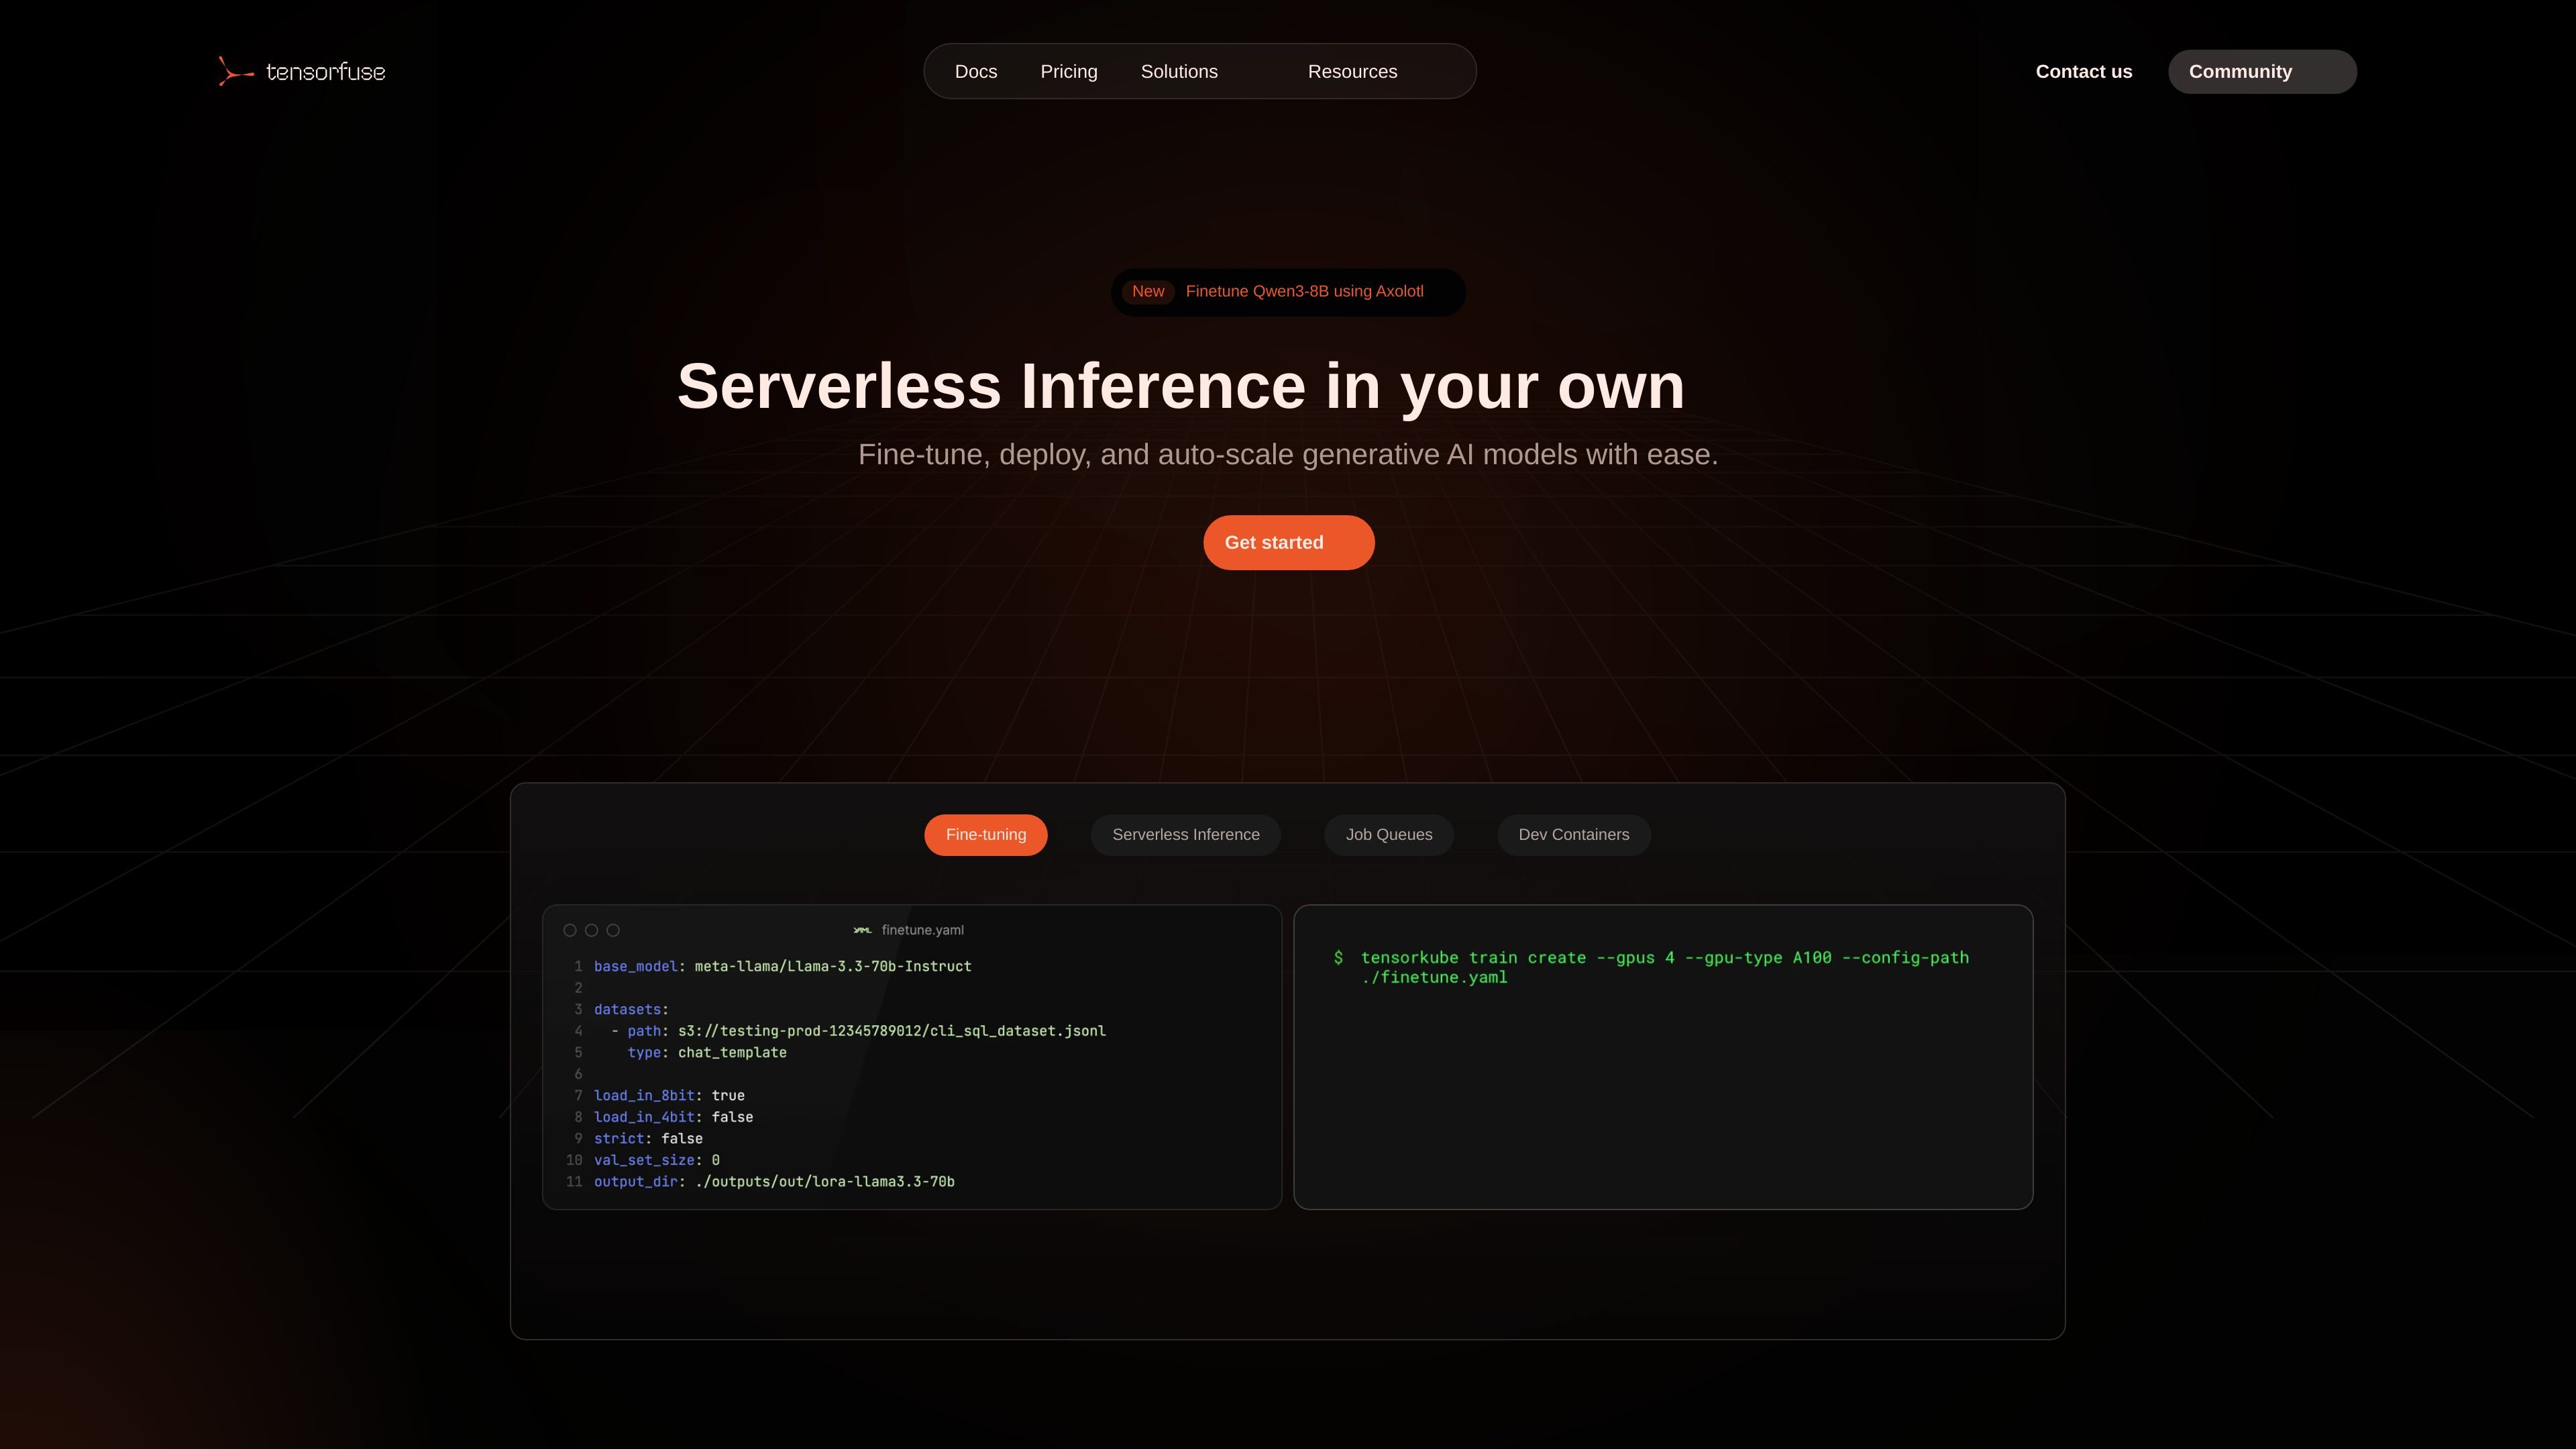
将容器化的语言、图像、视频、语音或自定义模型部署为端点,可配置身份验证、就绪检查和副本数量限制,并支持缩容至零。

Tensorfuse 帮助团队在自己的 AWS 账户和 VPC 中部署模型推理服务、运行队列任务和微调实验,并按需扩缩 GPU 资源。团队可使用自有模型,通过 CLI 配置端点、存储和密钥,并自动化部署流程。
Tensorfuse 在您的 AWS 环境中管理 AI 工作负载,涵盖在线推理、队列任务和微调。它通过跨账户 IAM 角色配置专用 EKS 集群,模型服务工作负载则运行在您的 VPC 中。团队可以使用自己的模型和云资源,并配置 GPU、端点设置、密钥、持久化存储和部署自动化。
将容器化的语言、图像、视频、语音或自定义模型部署为端点,可配置身份验证、就绪检查和副本数量限制,并支持缩容至零。
部署任务、提交带参数的运行请求,并轮询运行状态,适用于批量推理、数据处理或评估。
运行 Axolotl、Unsloth、Hugging Face 或自定义训练工作流。Axolotl 指南涵盖多种数据集格式、超参数搜索、模型比较,以及使用 Weights & Biases 进行监控。
将本地代码同步到 GPU 开发容器,开展交互式实验,无需手动使用 SSH。
使用私有 S3 存储、项目密钥、持久卷和 GitHub Actions,支持可重复执行的部署流程。
为请求流量不断变化的应用提供所选模型的推理服务。
将各自携带独立请求数据的推理或数据处理运行请求加入队列。
使用您的数据集比较微调配置,并评估生成的适配器或模型。
模型服务在您的 VPC 中运行,但您仍需配置网络访问、存储权限和外部集成。例如,Axolotl 工作流可以将模型上传到 Hugging Face Hub,并将实验信息发送至 Weights & Biases。
Axolotl 工作流支持 JSONL、CSV、Parquet 和 Hugging Face 数据集,包括指令和对话格式。
Hacker 套餐包含 100 个托管 GPU 小时,可用于无服务器推理和开发容器。基础设施运行在您的 AWS 账户中;初创企业优惠取决于资格条件和现有云服务抵扣额度。
流量数据仅供参考。