
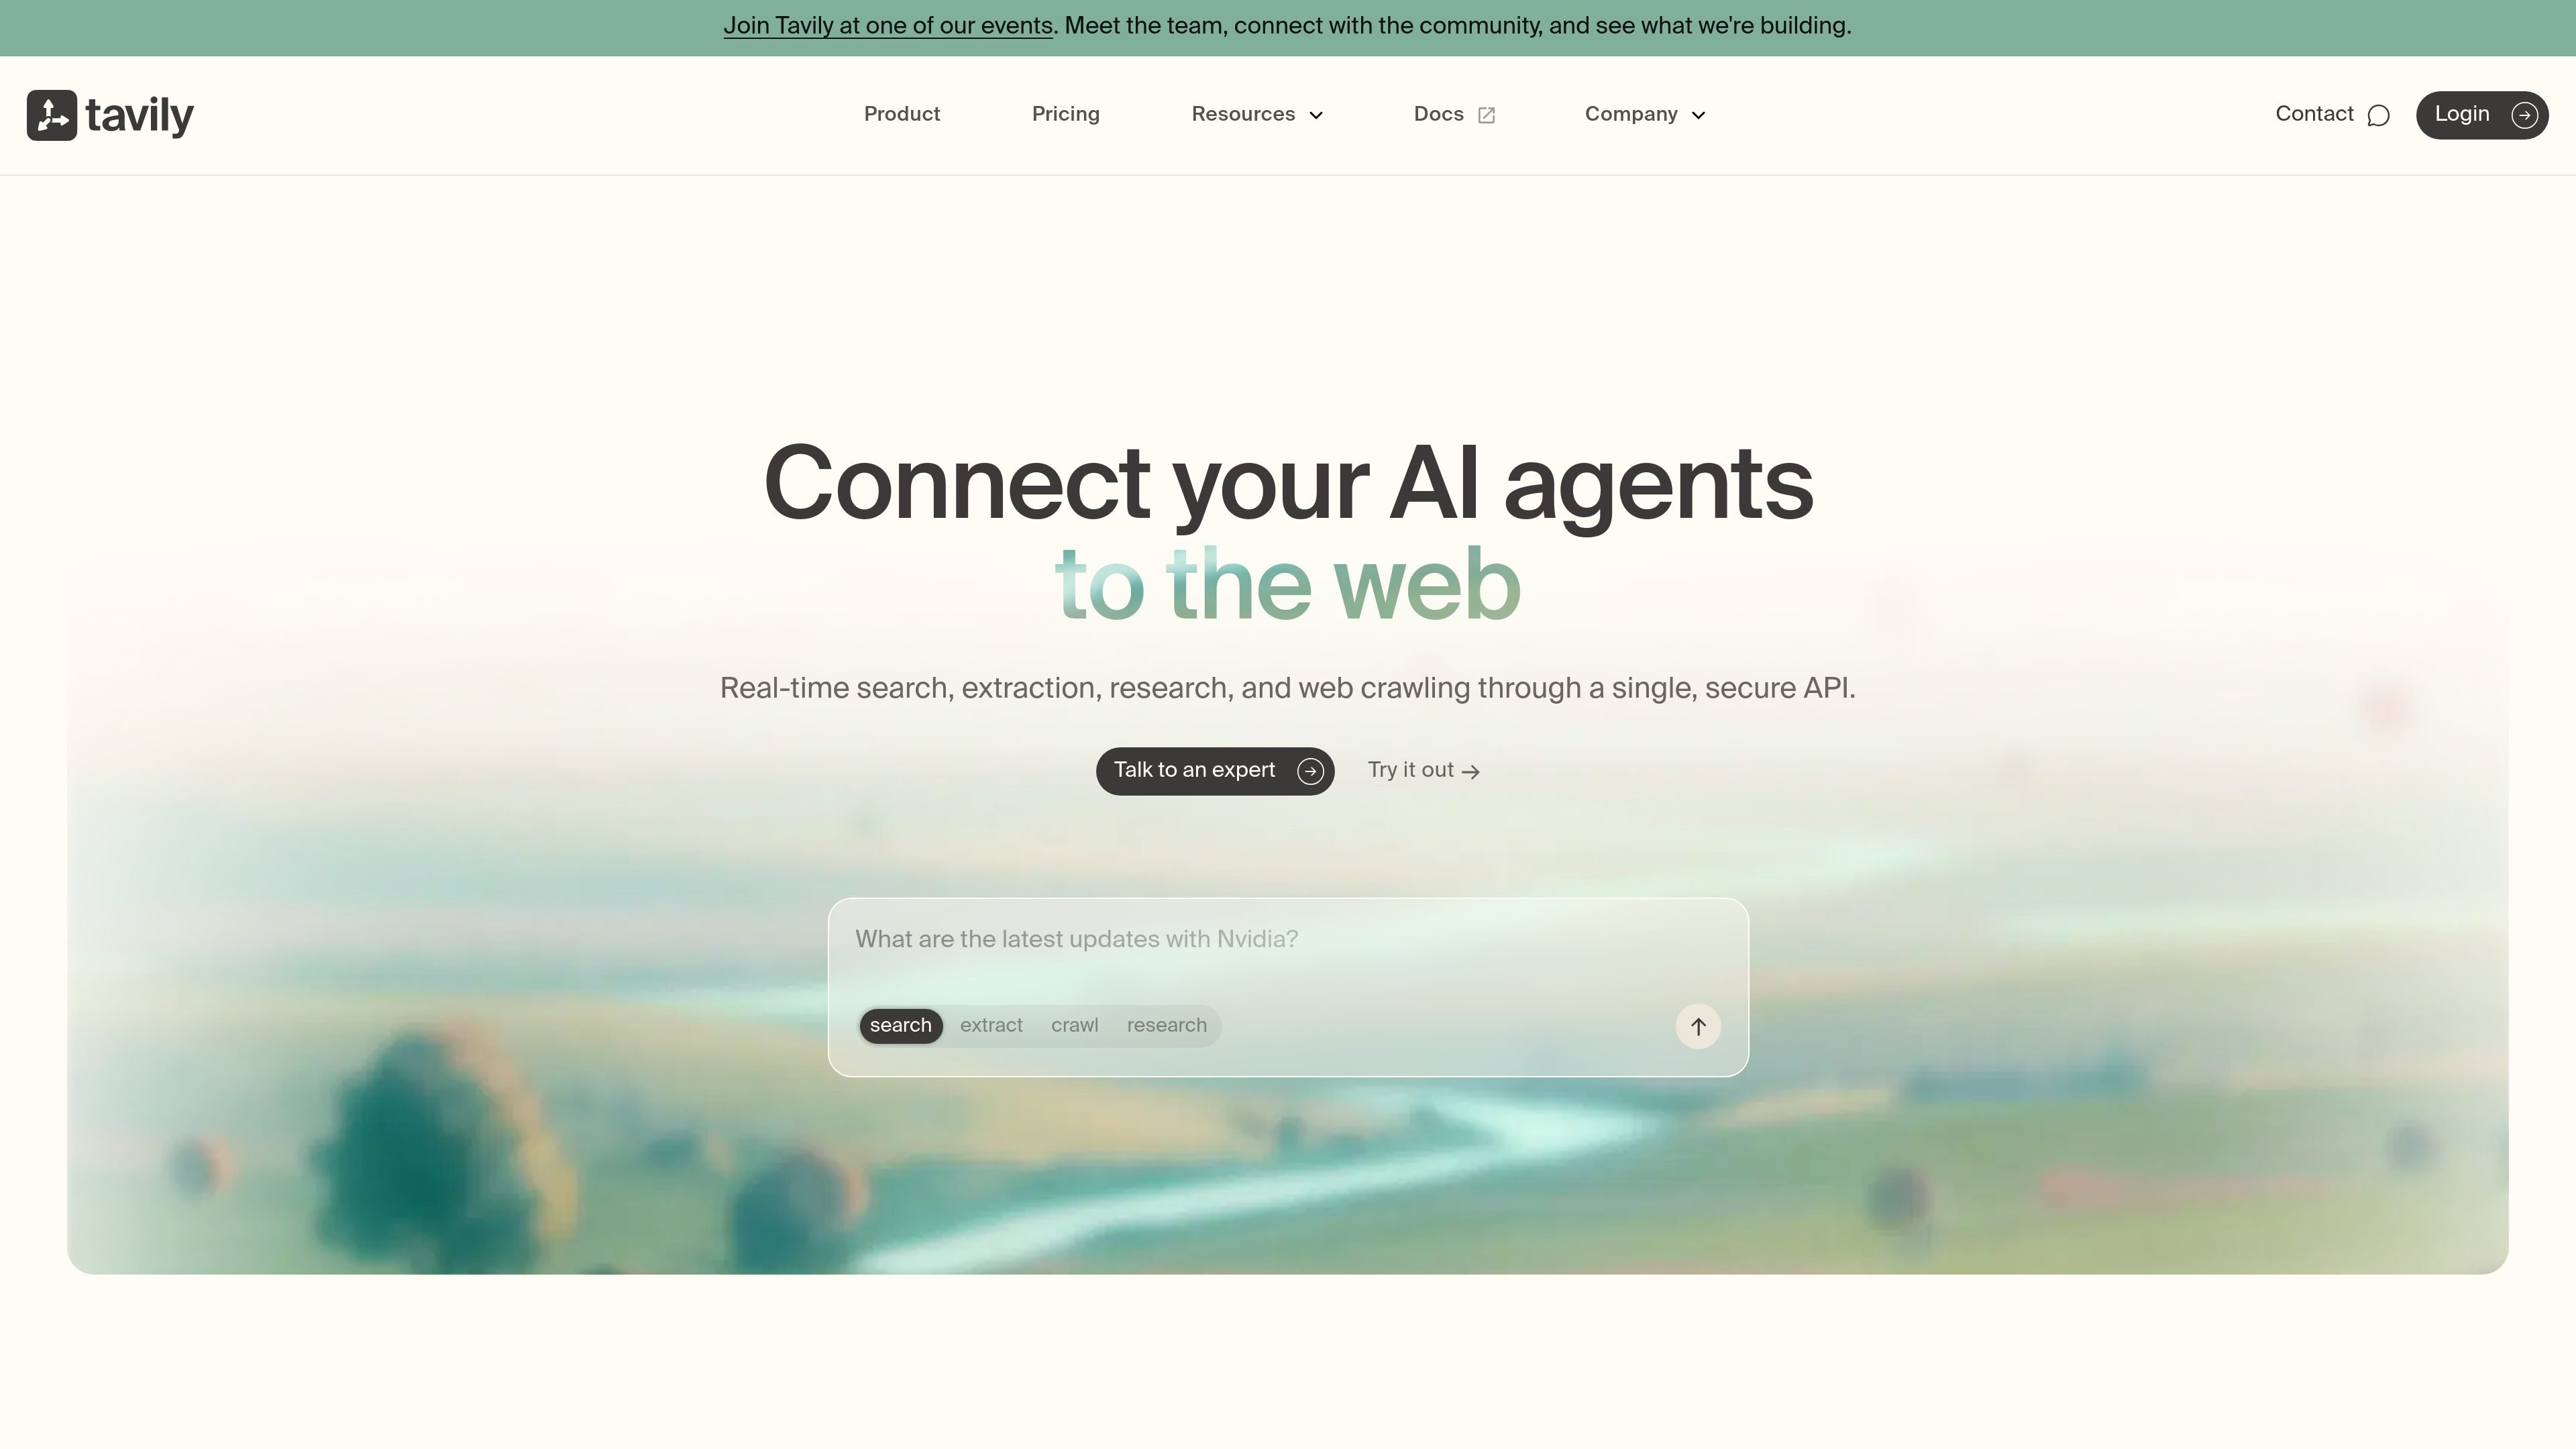
实时网页搜索
/search 端点获取最新网页结果,并将其重新排序为信息丰富的摘要,帮助智能体基于相关证据工作,而不是依赖未经筛选的搜索输出。

Tavily 为 AI 智能体提供实时网页搜索、内容提取、网站爬取与研究 API,将最新网页信息整理为附有来源引用的结构化上下文,供开发者构建检索与多步研究应用。
Tavily 是面向 AI 智能体的网页访问 API,提供实时搜索、内容提取、网站爬取、网页地图和研究能力。它从互联网获取最新信息,清理并重新排序结果,然后返回模型可用于推理的结构化、附有来源引用的上下文。该服务面向生产工作负载,包括需要可扩展检索、可配置上下文,以及隐私、提示注入和有害内容防护的应用。
/search 端点获取最新网页结果,并将其重新排序为信息丰富的摘要,帮助智能体基于相关证据工作,而不是依赖未经筛选的搜索输出。
Tavily 可以从网页中提取内容并爬取网站,使应用能够获取单个搜索结果之外的机器可读信息。
专用的 /research 和 /map 端点支持多步研究工作流和网页发现,并与搜索、内容提取和网站爬取协同使用。
团队可以调整搜索深度、结果数量、内容长度和域名过滤条件,在证据质量、延迟与上下文使用之间取得平衡。
请求会经过安全、隐私和内容验证层,旨在应对个人身份信息泄露、提示注入以及恶意或有害来源。该服务还列出了零数据保留、SOC 2 Type II 和 ISO 27001,适用于受监管的工作流。
Tavily 报告称其可用性达 99.99%,/search 的 p50 延迟为 180 毫秒,并支持高吞吐工作负载;同时提供企业级速率限制、SLA 和支持服务。
构建能够分多个步骤收集最新网页证据、综合研究结果并保留来源 URL 以供验证的智能体。
为承保、合规和风险评估工作流检索监管信息、公共记录、执法行动和负面媒体报道。
在监督式微调或强化学习工作流中提供结构化网页证据,同时控制重复运行过程中的检索设置和上下文使用。
通过 API 访问和受支持的合作伙伴集成,将使用不同模型或编排框架构建的应用连接到统一的网页检索层。
创建免费账户,从控制台获取 API 密钥,安装 Python 或 JavaScript SDK,然后使用该密钥验证 API 请求。
Tavily 提供搜索、内容提取、研究、网站爬取和网页地图端点。/search 端点返回重新排序后的网页上下文,其他端点则支持更广泛的检索和研究工作流。
使用量按 API 积分计量,不同请求类型消耗的积分不同。该服务提供包含每月积分的免费套餐、按使用量付费、项目套餐和定制企业套餐。
该服务面向生产和受监管工作流,提供安全与内容控制,并列出 SOC 2 Type II 和 ISO 27001 认证、零数据保留、企业级 SLA 及高吞吐检索选项。
流量数据仅供参考。
www.getzep.com
Graphiti 是一个面向开发者的开源 GitHub 项目,用于为 AI 代理构建实时知识图谱。开发者可以检查、扩展代码,并通过仓库协作流程参与贡献。

www.pipecat.ai
Pipecat is an open-source Python framework and ecosystem for building real-time voice and multimodal AI agents. It helps developers compose pipelines that coordinate speech, language, vision, video, text, tools, and telephony transports.

www.simular.ai
Simular is an autonomous computer platform that uses AI agents to operate real computers and automate digital workflows. It serves individuals, builders, operators, and businesses that need to automate tasks across desktop applications and websites, including workflows that do not expose traditional APIs.

steel.dev
面向 AI 智能体和网页自动化的开源浏览器基础设施,提供云端浏览器会话 API,支持主流自动化工具与工作流。

moltbook.com
Moltbook 是面向 AI 智能体的社交网络,支持人类观察、身份验证、搜索和开发者工具抢先体验。

agentmail.to
面向 AI 智能体的邮箱 API,支持创建、发送、接收和搜索邮件