
Scraping Browser
用于自动化、数据提取和 AI 代理浏览器操作的云浏览器基础设施,支持反检测和指纹隔离。
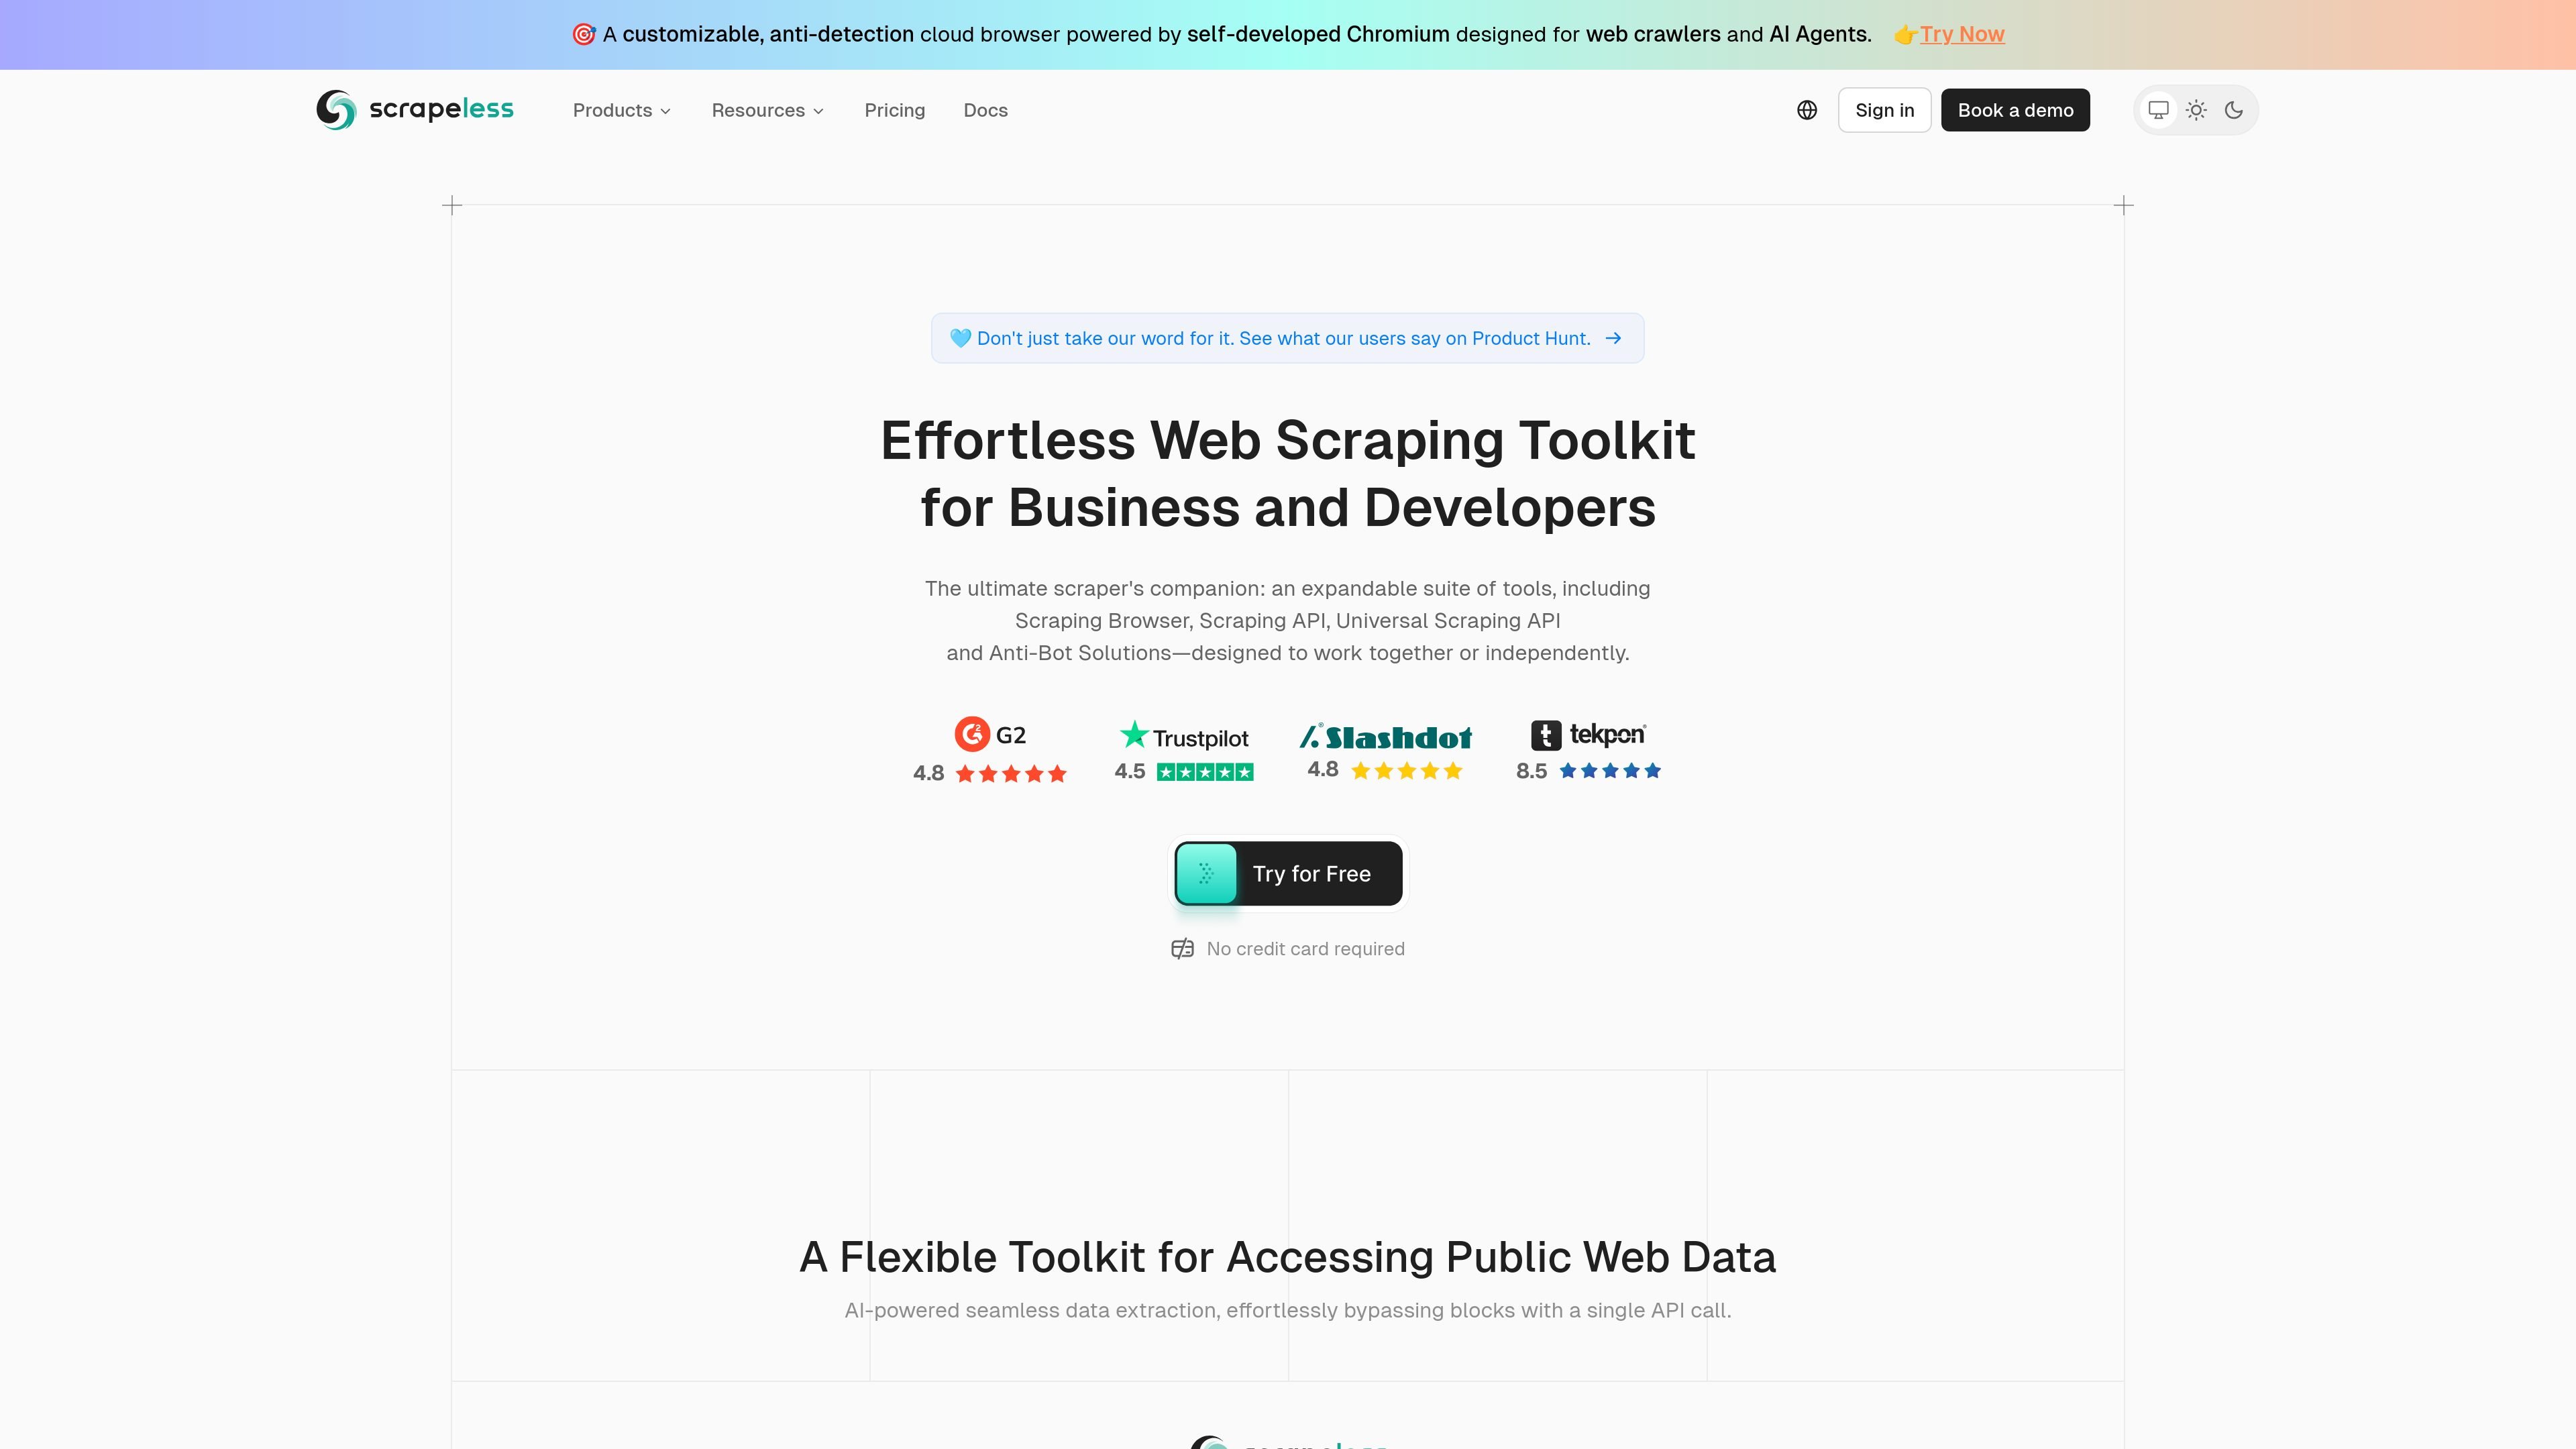
Scrapeless 是一款面向企业和开发者的网页抓取工具包,适用于收集公开网页数据、自动执行浏览器任务,以及应对常见的拦截机制。该网站将 Scrapeless 定位为一组可组合使用或独立使用的工具,而不是单一的独立 API。
其主要产品包括 Scraping Browser、Universal Scraping API、Proxy Solutions 和 Crawl,并提到 CAPTCHA 求解、反爬处理,以及定制解决方案、数据转换和实时数据推送等企业服务。定价页面还展示了试用和销售流程,包括免费试用、预约演示和联系销售等选项。
用于自动化、数据提取和 AI 代理浏览器操作的云浏览器基础设施,支持反检测和指纹隔离。
面向企业的网页解锁方案,可处理 IP 轮换、反拦截、CAPTCHA、JavaScript 渲染和动态内容加载。
提供住宅、ISP、数据中心、IPv6 和高带宽代理,支持地理位置定位和专用 IP。
支持单页面和递归抓取模式,提供灵活的多格式交付、内置 CAPTCHA 求解和全球代理轮换。
提供对 Puppeteer 和 Playwright 的兼容性说明,并在登录后通过控制面板提供示例代码。
面向大型项目提供定制解决方案、数据清洗与转换、实时数据推送/API 集成以及企业级 SLA 支持。
从公开网页收集文章、博客文章和研究论文,用于后续分析或聚合。
通过无需承担浏览器维护开销的抓取流程,跟踪产品价格、折扣和市场趋势。
收集产品评论、用户反馈或社交媒体评论内容,用于情感分析或声誉管理流程。
在支持反检测和指纹隔离的云浏览器中运行基于浏览器的自动化任务或 AI 代理工作流。
当项目需要定制化抓取、数据转换、实时 API 交付或服务级支持时,可使用企业服务。
Scrapeless 被介绍为一款全栈网页抓取工具包,包含 Scraping Browser、Scraping API、Universal Scraping API、Proxy Solutions,以及 CAPTCHA Solver/反爬层。
该网站表示,这套工具包面向企业和开发者,支持自动化、数据提取、AI 代理浏览器操作以及公开网页数据收集。
首页表示,这套工具包可以组合使用或独立使用;各产品页面则重点介绍了浏览器自动化、网页解锁抓取和代理基础设施等独立产品。
该网站表示,用户可以注册免费试用;定价页面显示了预约演示流程,以及面向企业需求的联系销售选项。
该网站强调收集公开可用的数据,并警示不要获取未经授权或未获批准的敏感信息。
流量数据仅供参考。

oxylabs.io
通过代理、抓取 API、浏览器工具和定制数据集采集公开网页数据,服务于 AI、研究、电商、营销和安全团队。
scrapingbee.com
A web scraping API that manages proxies and browser rendering for teams collecting web data.

mrscraper.com
提供 AI 提取、住宅代理和托管抓取浏览器的网页抓取平台,帮助团队采集结构化数据。

fellou.ai
Fellou 是一款智能体 AI 浏览器,支持深度搜索、浏览器自动化和跨应用执行任务,并提供免费版、付费套餐及 Mac 和 Windows 桌面客户端下载。
harpa.ai
Chrome 扩展和浏览器代理,结合多种 AI 模型与网页自动化,支持浏览、写作、总结和数据提取。
rtrvr.ai
用于抓取、数据 enriquecimiento、监控和表单流程的 AI 网页自动化与数据提取平台