

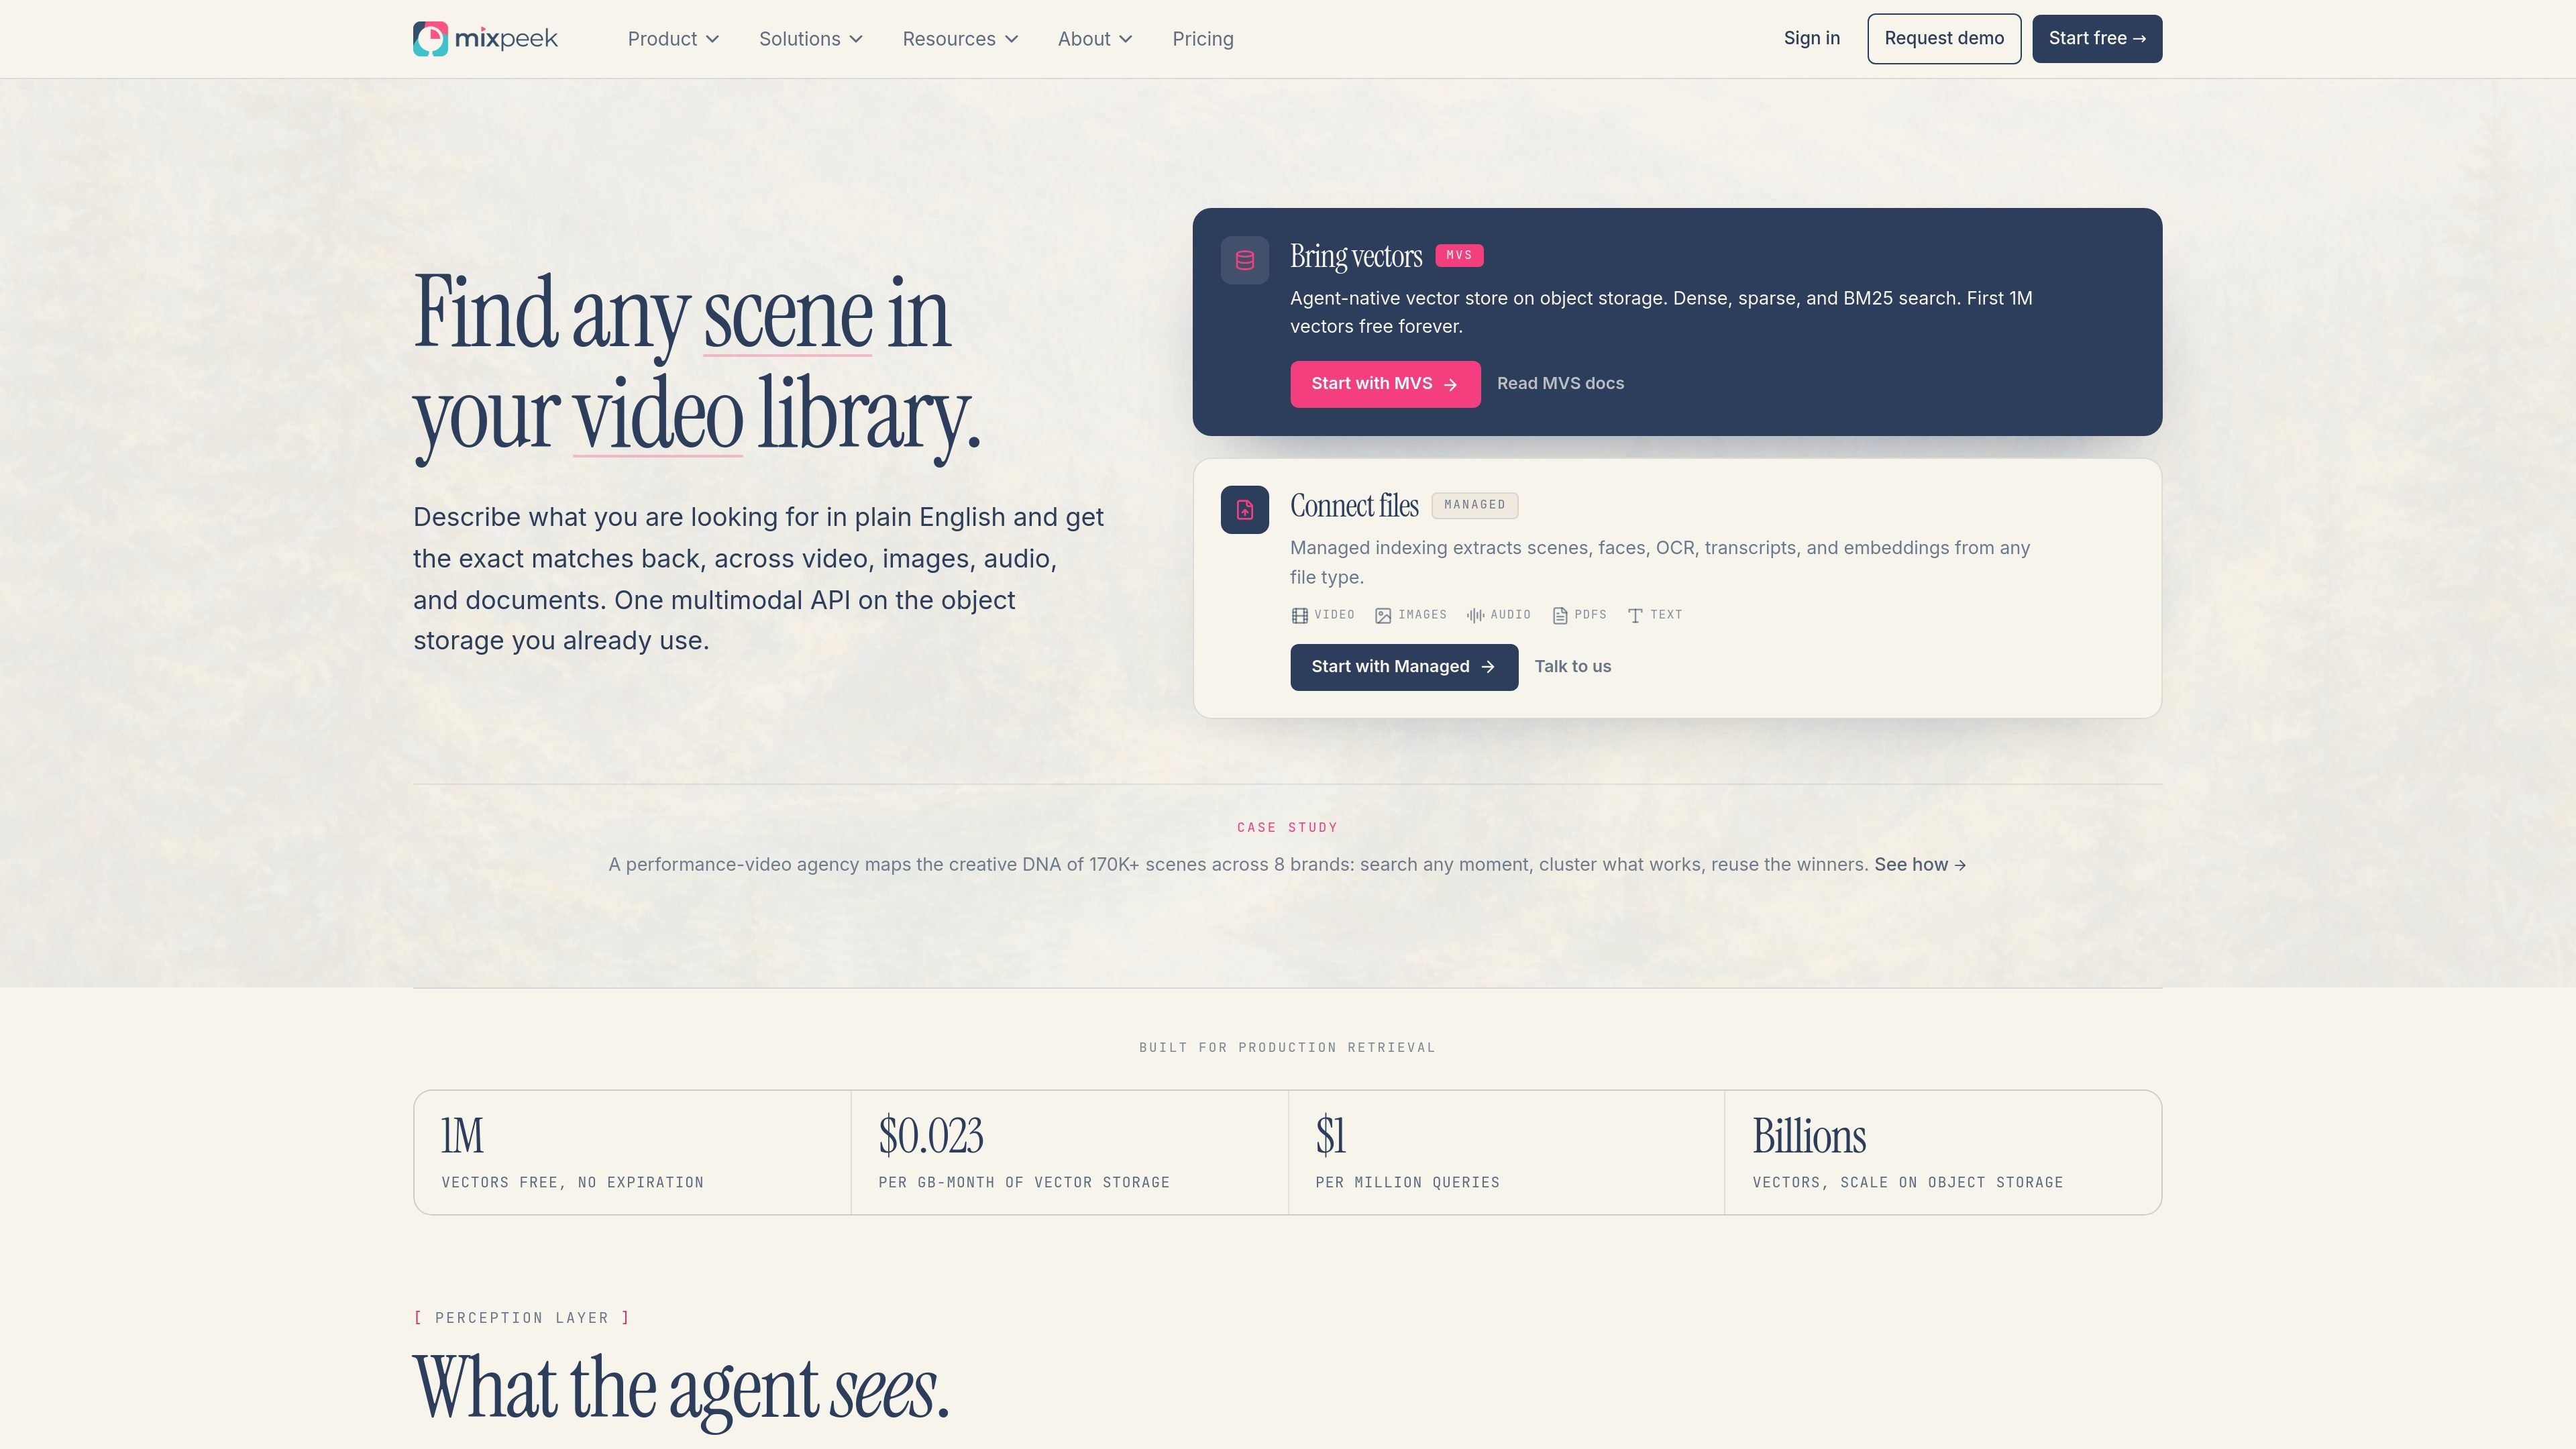
自然语言多模态搜索
用自然语言描述一个场景,即可检索视频、图片、音频和文档中匹配的片段。首页将其定位为对多模态内容进行语义搜索。
Mixpeek 是一个视频搜索和多模态检索平台,支持使用自然语言查询在视频、图片、音频和文档库中查找场景、片段及其他内容。它将面向原始文件的托管提取路径与面向已拥有嵌入的团队的向量存储路径结合在一起。
主页和定价页都将产品围绕对象存储来展开:你可以连接文件并让 Mixpeek 提取场景、面孔、OCR、转录文本和嵌入,也可以导入自己的向量,并使用稠密、稀疏或 BM25 查询进行搜索。这样就为媒体库、档案和需要基于内容检索而非文件名查找的代理工作流提供了一个可搜索层。
用自然语言描述一个场景,即可检索视频、图片、音频和文档中匹配的片段。首页将其定位为对多模态内容进行语义搜索。
连接对象存储,让 Mixpeek 自动提取场景、面孔、OCR、转录文本和嵌入。这是面向希望在不自建管道的情况下完成文件索引的团队的托管路径。
将 MVS 作为对象存储上的向量存储使用,支持稠密、稀疏和 BM25 搜索。定价页面还显示你可以导入自己的嵌入并直接搜索。
在多阶段检索流水线中组合过滤、关联和重排序步骤。网站称这些检索器可在 100 毫秒内完成组合。
使用面向类型的提取器处理面孔、场景、转录文本、OCR、指纹和嵌入。提取器页面表明这些流程有文档支持并且可以串联。
将 Mixpeek 连接到现有存储和工具,例如 S3、GCS、R2、Mux、LangChain 和 MCP。集成页面的组织方式更侧重于接入现有技术栈,而不是迁移数据。
让编辑、制作人或内部工具直接按场景中发生的内容搜索视频档案,而不是按文件名或手动标签。首页明确将产品定位为在视频库中查找精确片段。
识别某个人物或面孔在媒体库中出现于哪些片段。网站将面孔和人物搜索突出为核心用例,包括跨大型视频集合的检索。
在 PDF、讲座录音或会议转录文本中搜索特定的口头短语、图表布局或文档区域。来源展示了转录搜索、OCR 和版式提取的示例。
连接存储并自动索引新上传内容,使库在内容变化时仍保持可搜索。这适合希望在不手动标注的情况下持续索引的团队。
使用跨模态关联来回答需要多种信号的复合问题,例如在同一时间戳匹配说话人、屏幕文字和场景上下文。
Mixpeek 提供两条主要路径:托管索引,即你连接一个存储桶,由 Mixpeek 从文件中提取场景、面孔、OCR、转录文本和嵌入;以及 MVS,即你导入自己的嵌入并在对象存储上进行搜索。
来源展示了视频搜索、面孔和人物搜索、文档搜索、音频转录搜索以及跨模态检索等流程。它面向需要按内容而非文件名或手动标签搜索媒体库的团队。
来源表明,托管索引会处理视频、图片、音频、PDF 和文本等原始文件,然后返回可搜索的特征和检索器。MVS 支持在你自己的向量上进行稠密、稀疏和 BM25 搜索。
定价页面描述了按月计费、无长期承诺的自助服务方案,以及提供自定义基础设施、SSO、审计日志和专属支持的 Enterprise 选项。
来源没有描述除连接存储或安装 SDK 之外的完整实施流程,因此具体设置将取决于你使用的是 MVS 还是托管索引。
流量数据仅供参考。

lighton.ai
文档智能与 AI 搜索,提供有依据的引用式答案

linguamatics.com
为医疗和生命科学团队提供 AI 语言与翻译工具

myaidrive.com
AI Drive 是面向法律及专业团队的云端文档管理与 AI 分析平台,支持 OCR、语义搜索和自定义 AI 智能体。

octen.ai
Octen 是面向 AI 应用的搜索基础设施平台,提供实时网页搜索、答案生成和信息提取工具,适用于需要获取最新网页信息的 AI 代理、智能副驾和聊天机器人。

imaginario.ai
通过自然语言、视觉、音频或对白搜索,查找并再利用视频内容

memories.ai
Memories.ai 是一款具备长期视觉记忆的 AI 视频理解平台,支持搜索、摘要、分析和编辑视频,服务于企业安全、媒体、营销和机器人团队。