

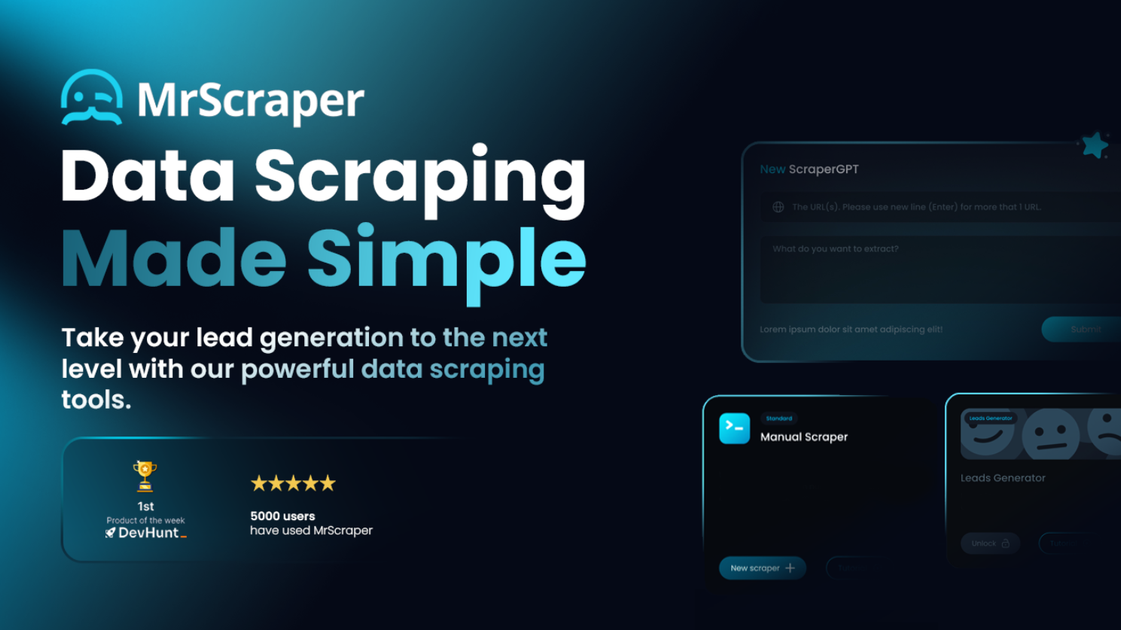
AI搭載のWeb抽出
ページのレイアウトを識別し、APIに適した形式で結果を返すAIベースの抽出により、Webページを構造化データに変換します。
MrScraperは、AI抽出、プロキシインフラ、ホスティング済みのスクレイピングブラウザを組み合わせたWebスクレイピングプラットフォームです。サイトでは、必要なスクレイピング基盤をすべて自分で構築・維持しなくても、公開Webページを構造化データに変換できる製品として紹介されています。
製品ページでは、構造化抽出用のWebスクレイパーAPI、リクエストのルーティングとジオターゲティング用のResidential proxy、動的ページ、CAPTCHA処理、ブラウザレベルの自動化に対応するスクレイピングブラウザという3つの主要要素が示されています。これらを組み合わせることで、公開Webサイトから大規模に自動データ収集を行いたいチームを支援します。
ページのレイアウトを識別し、APIに適した形式で結果を返すAIベースの抽出により、Webページを構造化データに変換します。
完全にホスティングされたスクレイピングブラウザを使用して、動的サイトの閲覧、CAPTCHAの処理、ブラウザインフラの自前管理の負担軽減を行えます。
ローテーションするResidential proxyを経由してリクエストをルーティングし、ブロック回避、ジオターゲティング対応、必要に応じた固定またはローテーションセッションの利用を実現します。
クリック、スクロール、待機、カスタムJavaScriptによって抽出前のページ操作を制御し、動的コンテンツを表示します。
APIを通じてWebページの全体または一部のスクリーンショットを取得し、視覚的なページ記録に利用できます。
ドメイン固有のエンドポイントとカスタムスキーマを使ってスクレイピングを設定でき、ソースページでは求人や一般的なAIスクレイピングなどの領域向け専用APIが示されています。
手作業のコピー&ペースト収集ではなく、API駆動のワークフローが必要な場合に、公開Webページから構造化された項目を抽出します。
読み込み後に変化するページ、操作が必要なページ、ブラウザ描画やJavaScriptに依存するページからデータを収集します。
Residential proxyとブラウザレベルの制御を使って、ブロック、CAPTCHA確認、リクエストフィルタリングを行うページにアクセスします。
専用のスクレイパーエンドポイントを使い、求人サイト、eコマースページ、不動産物件一覧、ソーシャルメディアページなどのドメイン固有ソースからデータを取得します。
構成可能なリクエスト処理と再試行を備えた、繰り返し取得する構造化Webデータを必要とする社内調査や運用パイプラインを支援します。
MrScraperは、ウェブサイトから構造化データを抽出するためのWebスクレイピングAPIと関連ツールを提供します。ソースページには、AIベースのスクレイピング、スクレイピングブラウザ、Residential proxy、ドメイン固有のスクレイパーAPIが示されています。
料金ページには、無料プラン、StandardとProの有料プラン、そして営業への問い合わせが必要なEnterpriseオプションが表示されています。
ソースページによると、Web Scraper APIはJSONやCSVを含む複数の形式で結果を返せます。スクレイピングブラウザのページでもJSONとCSVの出力が強調されています。
スクレイピングブラウザのページでは、動的なWebサイト、CAPTCHAチャレンジ、プロキシローテーション、ブラウザフィンガープリンティング、ユーザーエージェント制御、リファラー見出し、Cookie、再試行、JavaScriptレンダリングに対応するよう設計されていると説明されています。
ソースページでは、この製品は一般向けアプリというより、APIとスクレイピング基盤のツールセットとして説明されています。公開されているページは、開発者や自動データ抽出ワークフローを構築するチームでの利用を想定しています。
トラフィックデータは参考情報としてご利用ください。
scrapingbee.com
A web scraping API that manages proxies and browser rendering for teams collecting web data.

oxylabs.io
プロキシ、スクレイピング API、ブラウザツール、カスタムデータセットで公開Webデータを収集する基盤。

import.io
価格分析・競合監視・デジタル棚分析に対応する企業向けWebスクレイピング

browse.ai
構造化データ抽出とワークフロー自動化を実現するノーコードWebスクレイピング・監視

octoparse.com
構造化データを収集できるノーコードWebスクレイピング基盤
harpa.ai
複数のAIモデルとウェブ自動化を組み合わせたChrome拡張機能兼ブラウザエージェント。閲覧、執筆、要約、データ抽出に対応。