
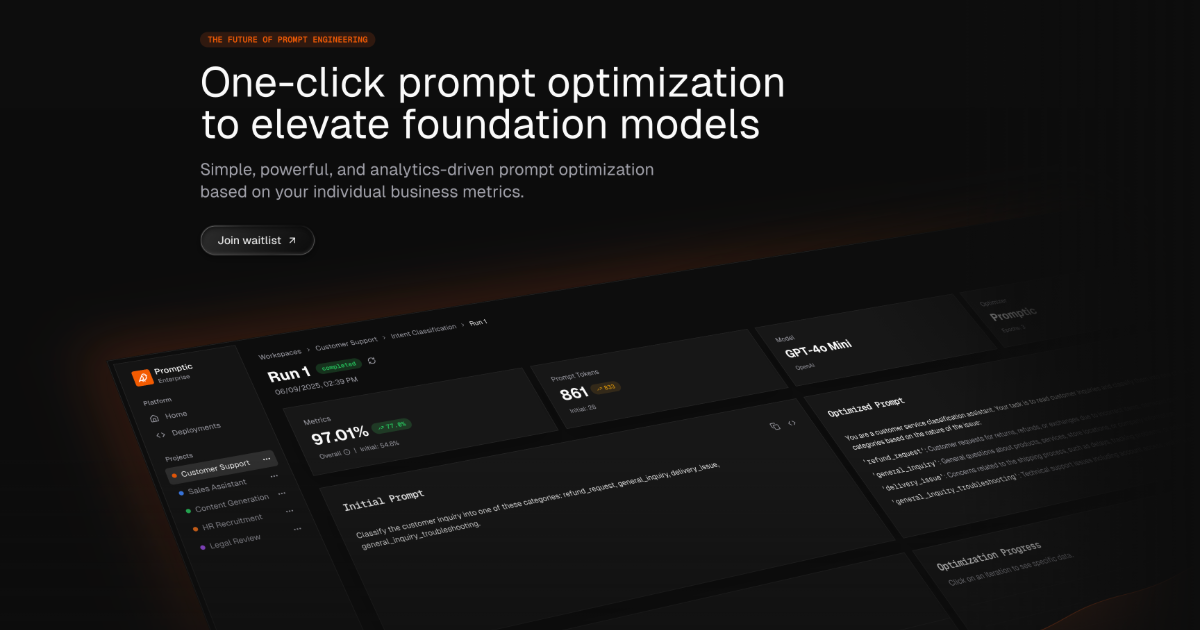
Prompt optimization
Optimize prompts against labeled examples, evaluators, and business metrics. Promptic supports multi-variable prompts and structured chat-message templates so experiments can match the format used in an application.

Promptic est une plateforme d’optimisation GenAI qui permet d’évaluer des modèles, d’améliorer des prompts et des agents, et de choisir des configurations selon des indicateurs métier. Elle associe le traçage basé sur OpenTelemetry à des jeux de données, des benchmarks et des workflows d’optimisation pour les équipes qui développent des applications d’IA.
Promptic helps teams evaluate and improve AI applications using representative data, expected outputs, and business metrics. It covers model comparison, prompt tuning, agent evaluation, information extraction, and tool-selection workflows.
Users can benchmark candidate configurations for quality, cost, and latency, inspect production behavior through OpenTelemetry traces, and retrieve or deploy a validated configuration from application workflows.
Optimize prompts against labeled examples, evaluators, and business metrics. Promptic supports multi-variable prompts and structured chat-message templates so experiments can match the format used in an application.
Benchmark different foundation models on the same task and compare quality, inference cost, and latency to identify a configuration that fits the project’s priorities.
Evaluate complete agents and compare their outputs, artifacts, trajectories, and architectures, including workflows that use routing, retrieval, or tools.
Capture LLM calls, tool calls, and workflow steps with provider-agnostic spans. Traces can include request and response payloads, token counts, cost, and latency for debugging and optimization.
Score only the output fields that matter, with per-field inclusion, weighting, required-field handling, strategy overrides, and configurable LLM-judge behavior.
Use the Python SDK, REST API, CLI, or documented dashboard workflows to instrument applications, manage experiments, and retrieve optimized prompts or configurations. The SDK supports first-class tracing for OpenAI, Anthropic, Google, LangChain, and Cohere.
Run the same evaluation dataset across candidate models and weigh output quality against inference cost and latency before choosing what to deploy.
Compare complete agent architectures, inspect failing traces and spans, and validate a revised implementation against fixed cases before shipping it.
Optimize prompts for documents or other structured tasks, then evaluate important output fields individually so optional or noisy fields do not obscure meaningful regressions.
Evaluate how reliably a model selects tools from an MCP server and use trace evidence to investigate incorrect routing, retries, or other tool-use failures.
Promptic can optimize prompts, compare models, evaluate agent architectures, improve information-extraction workflows, and optimize model tool selection. The documentation also describes support for multi-variable prompts, chat-message prompts, and structured-output evaluation.
Users provide representative inputs and expected outputs, define the metrics that matter, and benchmark candidate prompts, models, or architectures against the same dataset. Promptic surfaces differences in the results and helps select a configuration based on the chosen trade-offs.
Promptic uses OpenTelemetry-based instrumentation to capture LLM calls, tool calls, and workflow steps. Trace data can include payloads, token counts, cost, and latency, and can then be used for debugging, dataset creation, and optimization.
Yes. Promptic documents a Python SDK, REST API, CLI workflows, and dashboard-based workflows. The Python SDK provides drop-in initialization for tracing and supports OpenAI, Anthropic, Google, LangChain, and Cohere integrations.
The pricing page distinguishes Promptic Credits from model or token usage. Users can bring their own model keys, while managed model usage is optional on applicable plans and billed separately; enterprise terms are customized.
Les données de trafic sont fournies à titre indicatif uniquement.

braintrust.dev
Braintrust est une plateforme d’observabilité de l’IA qui permet de suivre le comportement de l’IA en production, d’exécuter des évaluations et de détecter les régressions avant qu’elles n’atteignent les utilisateurs. Elle aide les équipes à concevoir et exploiter des produits d’IA grâce aux traces, jeux de données, scores et outils de workflow.
pangea.cloud
Pangea est une plateforme de sécurité pour les applications d’IA qui ajoute des garde-fous aux prompts, aux sorties, à l’accès aux données et à la journalisation. Sécurisez les workflows LLM via des API, des SDK, des outils d’IA ou des passerelles API.
maritime.sh
Maritime est une plateforme pour déployer, gérer et faire évoluer des agents IA avec des micro-VM isolées et un point de terminaison API actif. Elle permet de créer des agents destinés aux clients, des workflows personnalisés et des déploiements par client.
superqode.dev
SuperQode est une couche de harness open source pour les agents de programmation. Elle permet de découvrir, créer, exécuter, évaluer et optimiser des harnesses d’agents depuis un seul terminal. Elle assure l’interopérabilité entre A2A, ACP, MCP et UHP, afin que les équipes puissent conserver leurs agents de programmation et modèles existants.

openlit.io
Plateforme open source d’observabilité LLM basée sur OpenTelemetry pour surveiller, tracer et évaluer les applications IA.

dreamflow.app
Dreamflow est un outil visuel de création avec AI pour applications mobiles prêtes pour la production. Il permet aux équipes et aux développeurs indépendants de créer des apps Flutter avec des prompts AI, l’édition visuelle, le contrôle du code et des options de déploiement web et mobile.