Findings24
Liquid Inference logo

Liquid Inference

Freemium
Visiter

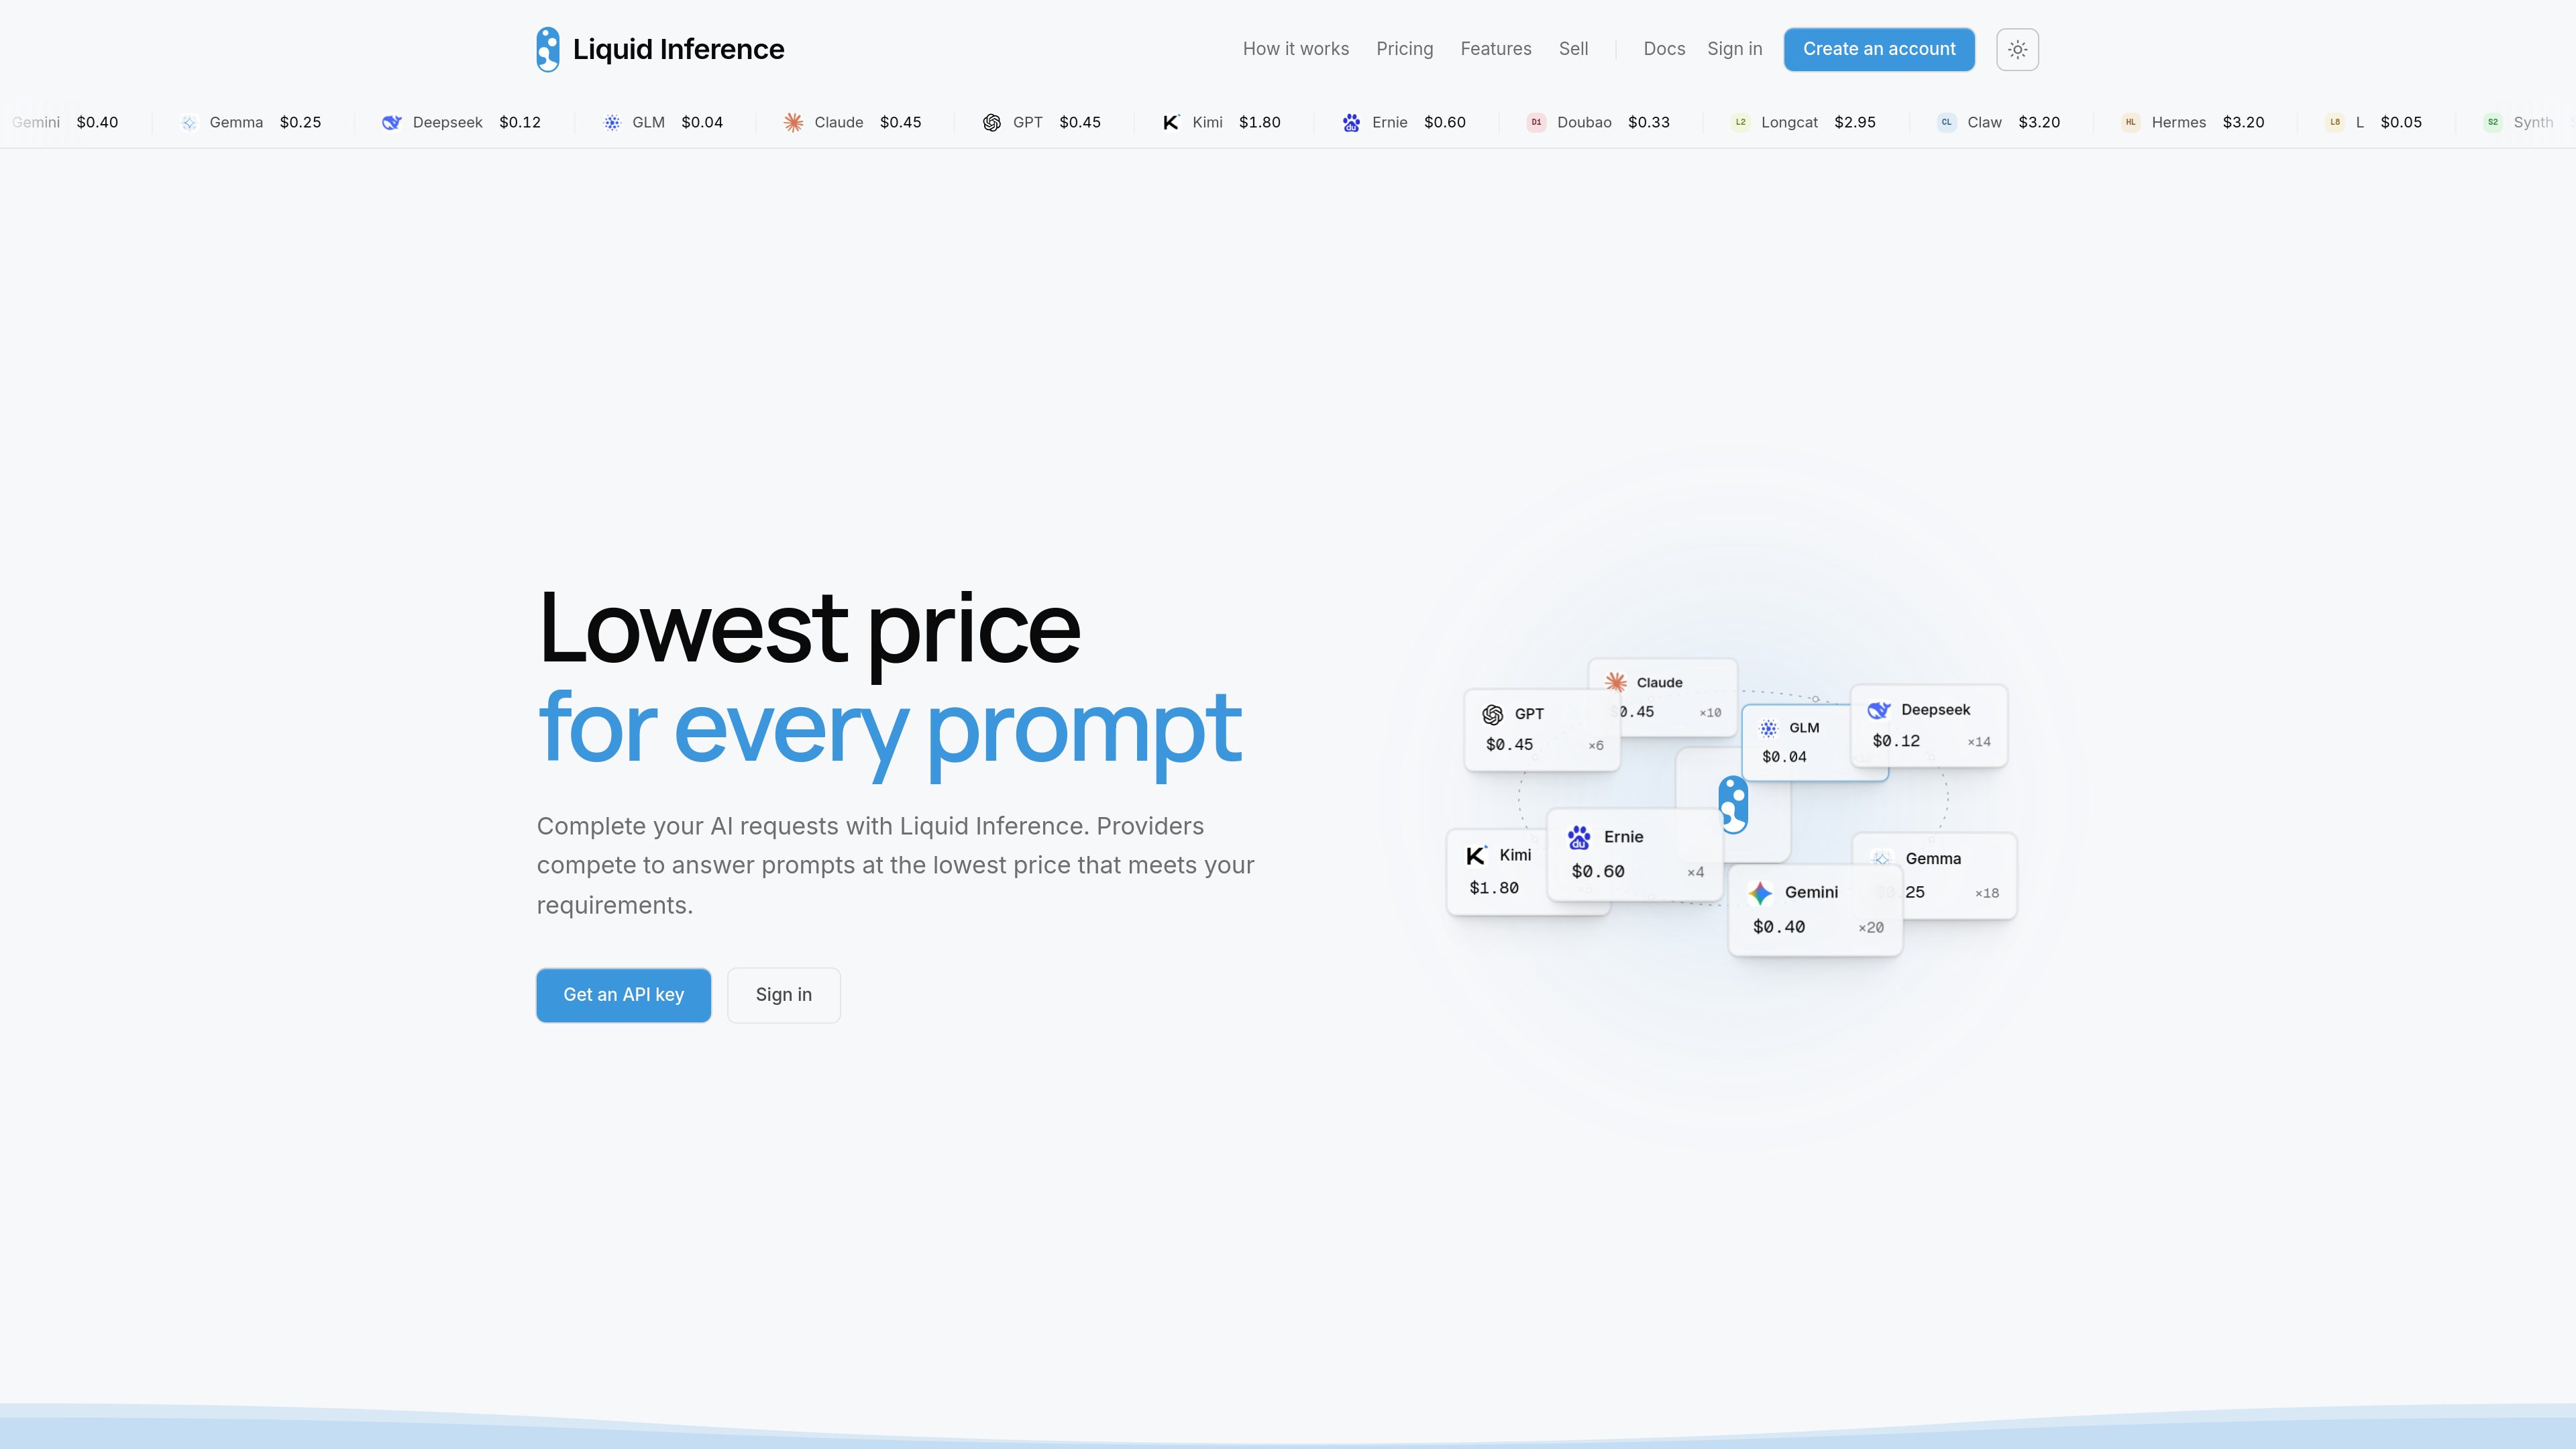
Liquid Inference achemine chaque requête d’IA via une enchère entre fournisseurs, selon le modèle, la région, la vitesse et le niveau de qualité requis. Les équipes peuvent ainsi contrôler leurs coûts d’inférence via une API.

Qu'est-ce que Liquid Inference ?

Liquid Inference est une place d’enchères pour l’inférence de grands modèles de langage proposée par Architect. Elle permet aux fournisseurs de modèles d’indiquer leurs tarifs pour les modèles qu’ils proposent, tandis que les acheteurs définissent des exigences telles que le choix du modèle, la région, la vitesse et la qualité minimale. Pour chaque requête, les fournisseurs éligibles sont mis en concurrence et l’offre retenue sert à générer la réponse.

Le service est conçu pour les équipes qui envoient des requêtes d’IA via une API ou des outils de programmation et d’agents compatibles. Son processus de routage affiche les offres en temps réel, prend en charge des plafonds de dépense par requête et facture les jetons utilisés. Les acheteurs peuvent également consulter le détail du coût de chaque requête et l’historique public des prix.

Que peut faire Liquid Inference ?

Enchère entre fournisseurs pour chaque requête

Les fournisseurs publient un prix par jeton pour les modèles qu’ils proposent. Les offres éligibles sont mises en concurrence pour chaque requête, puis l’offre la moins chère qui respecte les exigences de l’acheteur est sélectionnée.

Paramètres de routage configurables

Avant d’envoyer une requête, les acheteurs peuvent préciser les modèles, les régions, la vitesse et la qualité minimale, afin de limiter l’enchère aux fournisseurs qui respectent ces paramètres.

Intégration compatible avec les API

Liquid Inference fournit un point de terminaison d’API et documente une modification de l’URL de base pour les clients utilisant les formats d’API OpenAI ou Anthropic.

Plafonds de dépense et facturation à l’usage

Les requêtes peuvent être soumises à un plafond de prix, tandis que la facturation dépend des jetons utilisés. Le détail de la facturation indique le coût de chaque requête.

Évaluations des fournisseurs et données de marché

Le service indique tester régulièrement les fournisseurs au moyen de benchmarks standards, publier les résultats et fournir les prix actuels et historiques des modèles.

Outils de place de marché pour les fournisseurs

Les fournisseurs de modèles peuvent enregistrer des déploiements, définir et ajuster leurs prix, contrôler leur capacité et consulter les tâches traitées, les taux de victoire, les pertes aux enchères, les revenus et les versements.

Cas d'utilisation

“Inférence applicative maîtrisant les coûts”

Acheminez les requêtes de production ou de développement vers des fournisseurs de modèles éligibles, tout en utilisant les exigences et les plafonds par requête pour gérer les dépenses d’inférence.

“Agents de programmation et workflows dans le terminal”

Utilisez Liquid CLI avec des agents de terminal pris en charge, tels que Claude Code, Codex ou OpenCode, en sélectionnant une stratégie de classement et un plafond par requête.

“Migration d’un client d’API existant”

Connectez les applications qui utilisent déjà les API OpenAI ou Anthropic en modifiant l’URL de base du client et en fournissant une clé d’API Liquid Inference.

“Monétisation de la capacité d’inférence”

Les opérateurs disposant de déploiements de modèles peuvent les proposer sur la place d’échange, fixer leurs prix en fonction de la capacité disponible et être rémunérés pour les jetons traités dans le cadre des requêtes remportées.

Questions fréquentes

Comment Liquid Inference choisit-il un fournisseur ?

Vous définissez des paramètres de routage tels que les modèles, les régions, la vitesse et la qualité minimale. Les fournisseurs qui les respectent sont mis en concurrence, puis l’offre admissible la moins chère traite la requête.

Que paie un acheteur ?

Le site indique que les acheteurs paient les jetons qu’ils utilisent. Son affichage tarifaire distingue le prix des jetons de sortie de celui des jetons d’entrée, et la facturation détaillée indique le coût des requêtes.

Puis-je limiter le coût d’une requête ?

Oui. Liquid CLI prend en charge un plafond, et le service indique que les prix sont plafonnés avant le démarrage du modèle lorsqu’un fournisseur est sélectionné.

Les outils d’IA existants peuvent-ils se connecter à Liquid Inference ?

Le service documente une modification de l’URL de base pour les clients compatibles avec les API OpenAI ou Anthropic et répertorie des intégrations incluant des agents de programmation, des SDK et des outils de workflow.

Comment un fournisseur de modèles peut-il rejoindre le service ?

Un fournisseur crée un compte, enregistre un déploiement, attend l’examen et la mise en ligne par un opérateur, puis connecte un agent pour commencer à proposer des tarifs. Le site indique qu’aucuns frais d’inscription ni de transaction ne sont facturés aux fournisseurs.

Informations rapides

Catégorie
Routage et place de marché pour l’inférence de LLM
Fournisseur
Architect
Utilisateurs principaux
Équipes développant des applications d’IA, développeurs et fournisseurs de modèles
Interface acheteur
API, Liquid CLI et Liquid MCP
Modèle de routage
Enchère par requête fondée sur les exigences définies par l’acheteur
Site web
liquidinference.ai

Analyse du trafic de Liquid Inference

Les données de trafic sont fournies à titre indicatif uniquement.

Visites mensuelles
0
Classement mondial
-
Taux de rebond
0.00%
Durée moyenne de visite
00:00
Pages par visite
0.00
Évaluation du domaine
20

Tendances du trafic

Sources de trafic

Direct0.0%
Recherche0.0%
Recherche organique0.0%
Recherche payante0.0%
Réseaux sociaux0.0%
Réseaux sociaux organiques0.0%

Principales régions

Les analyses de trafic ne sont pas encore disponibles.

Alternatives à Liquid Inference

Hugging Face Inference Providers logo

Hugging Face Inference Providers

huggingface.co

Hugging Face Inference Providers aide les développeurs et les équipes à comparer les fournisseurs d’un même modèle selon le prix, le contexte, la latence, le débit et les capacités prises en charge.

PiAPI logo
PiAPI

piapi.ai

PiAPI réunit des modèles de génération vidéo, image, audio, 3D et de langage dans une interface commune. Les développeurs, agents IA et workflows automatisés peuvent les utiliser via le playground, l’API, la CLI ou le serveur MCP.

Any Router logo
Any Router

anyrouter.top

Any Router est un service de routage d’API pour les outils de programmation en ligne de commande, comme Claude Code, OpenAI Codex et OpenClaw.

Router by Ramp logo

Router by Ramp

router.com

Router by Ramp fournit un point d’accès API unique pour connecter une application à des modèles de plusieurs fournisseurs. Il oriente les requêtes selon le coût, la qualité et la disponibilité, et permet de suivre l’usage et les dépenses.

Crun logo

Crun

crun.ai

Une API unique pour intégrer des modèles d’IA vidéo, image, audio et texte, avec suivi de l’utilisation et tarification par crédits.


Découvrir plus d’outils

FiloMail logo

FiloMail

filomail.com

FiloMail est un espace de travail IA pour les e-mails et les applications connectées, qui aide à résumer, rédiger, organiser et traiter les messages sur ordinateur et mobile. Il propose une offre gratuite et une formule Plus payante avec davantage d’utilisation de l’IA et de fonctions d’automatisation.

Pizi logo

Pizi

pizi.app

Pizi transforme les photos de produits en fiches avec tags SEO

Paperpal logo

Paperpal

paperpal.com

Outil de rédaction académique par IA et assistant de recherche

SwiftXR logo

SwiftXR

home.swiftxr.io

SwiftXR permet aux marques, distributeurs et designers de créer, publier et mesurer des expériences produit interactives en 3D, en réalité augmentée et en réalité virtuelle. Les visiteurs peuvent explorer les produits sur les sites web et les boutiques en ligne.

OC Maker logo

OC Maker

oc-maker.org

Créateur de personnages originaux par IA à partir de textes et d’images de référence, avec offres gratuites et payantes.

Recraft logo

Recraft

www.recraft.ai

Plateforme de génération d’images et de design par IA