
Salida en texto, Markdown y HTML
Convierte una URL en texto sin formato, Markdown o HTML para pegar el resultado en otro flujo de trabajo o herramienta.

Convierte URL de páginas web en texto limpio, Markdown o HTML para copiarlo en herramientas de IA y editores, con opciones para páginas dinámicas, YouTube y extracciones avanzadas.
URLtoText es una herramienta web que convierte la URL de una página web en texto limpio, Markdown o HTML. Su función principal es eliminar los elementos de navegación y presentación de la página y devolver contenido que se pueda copiar en un editor, una nota o un flujo de trabajo con IA.
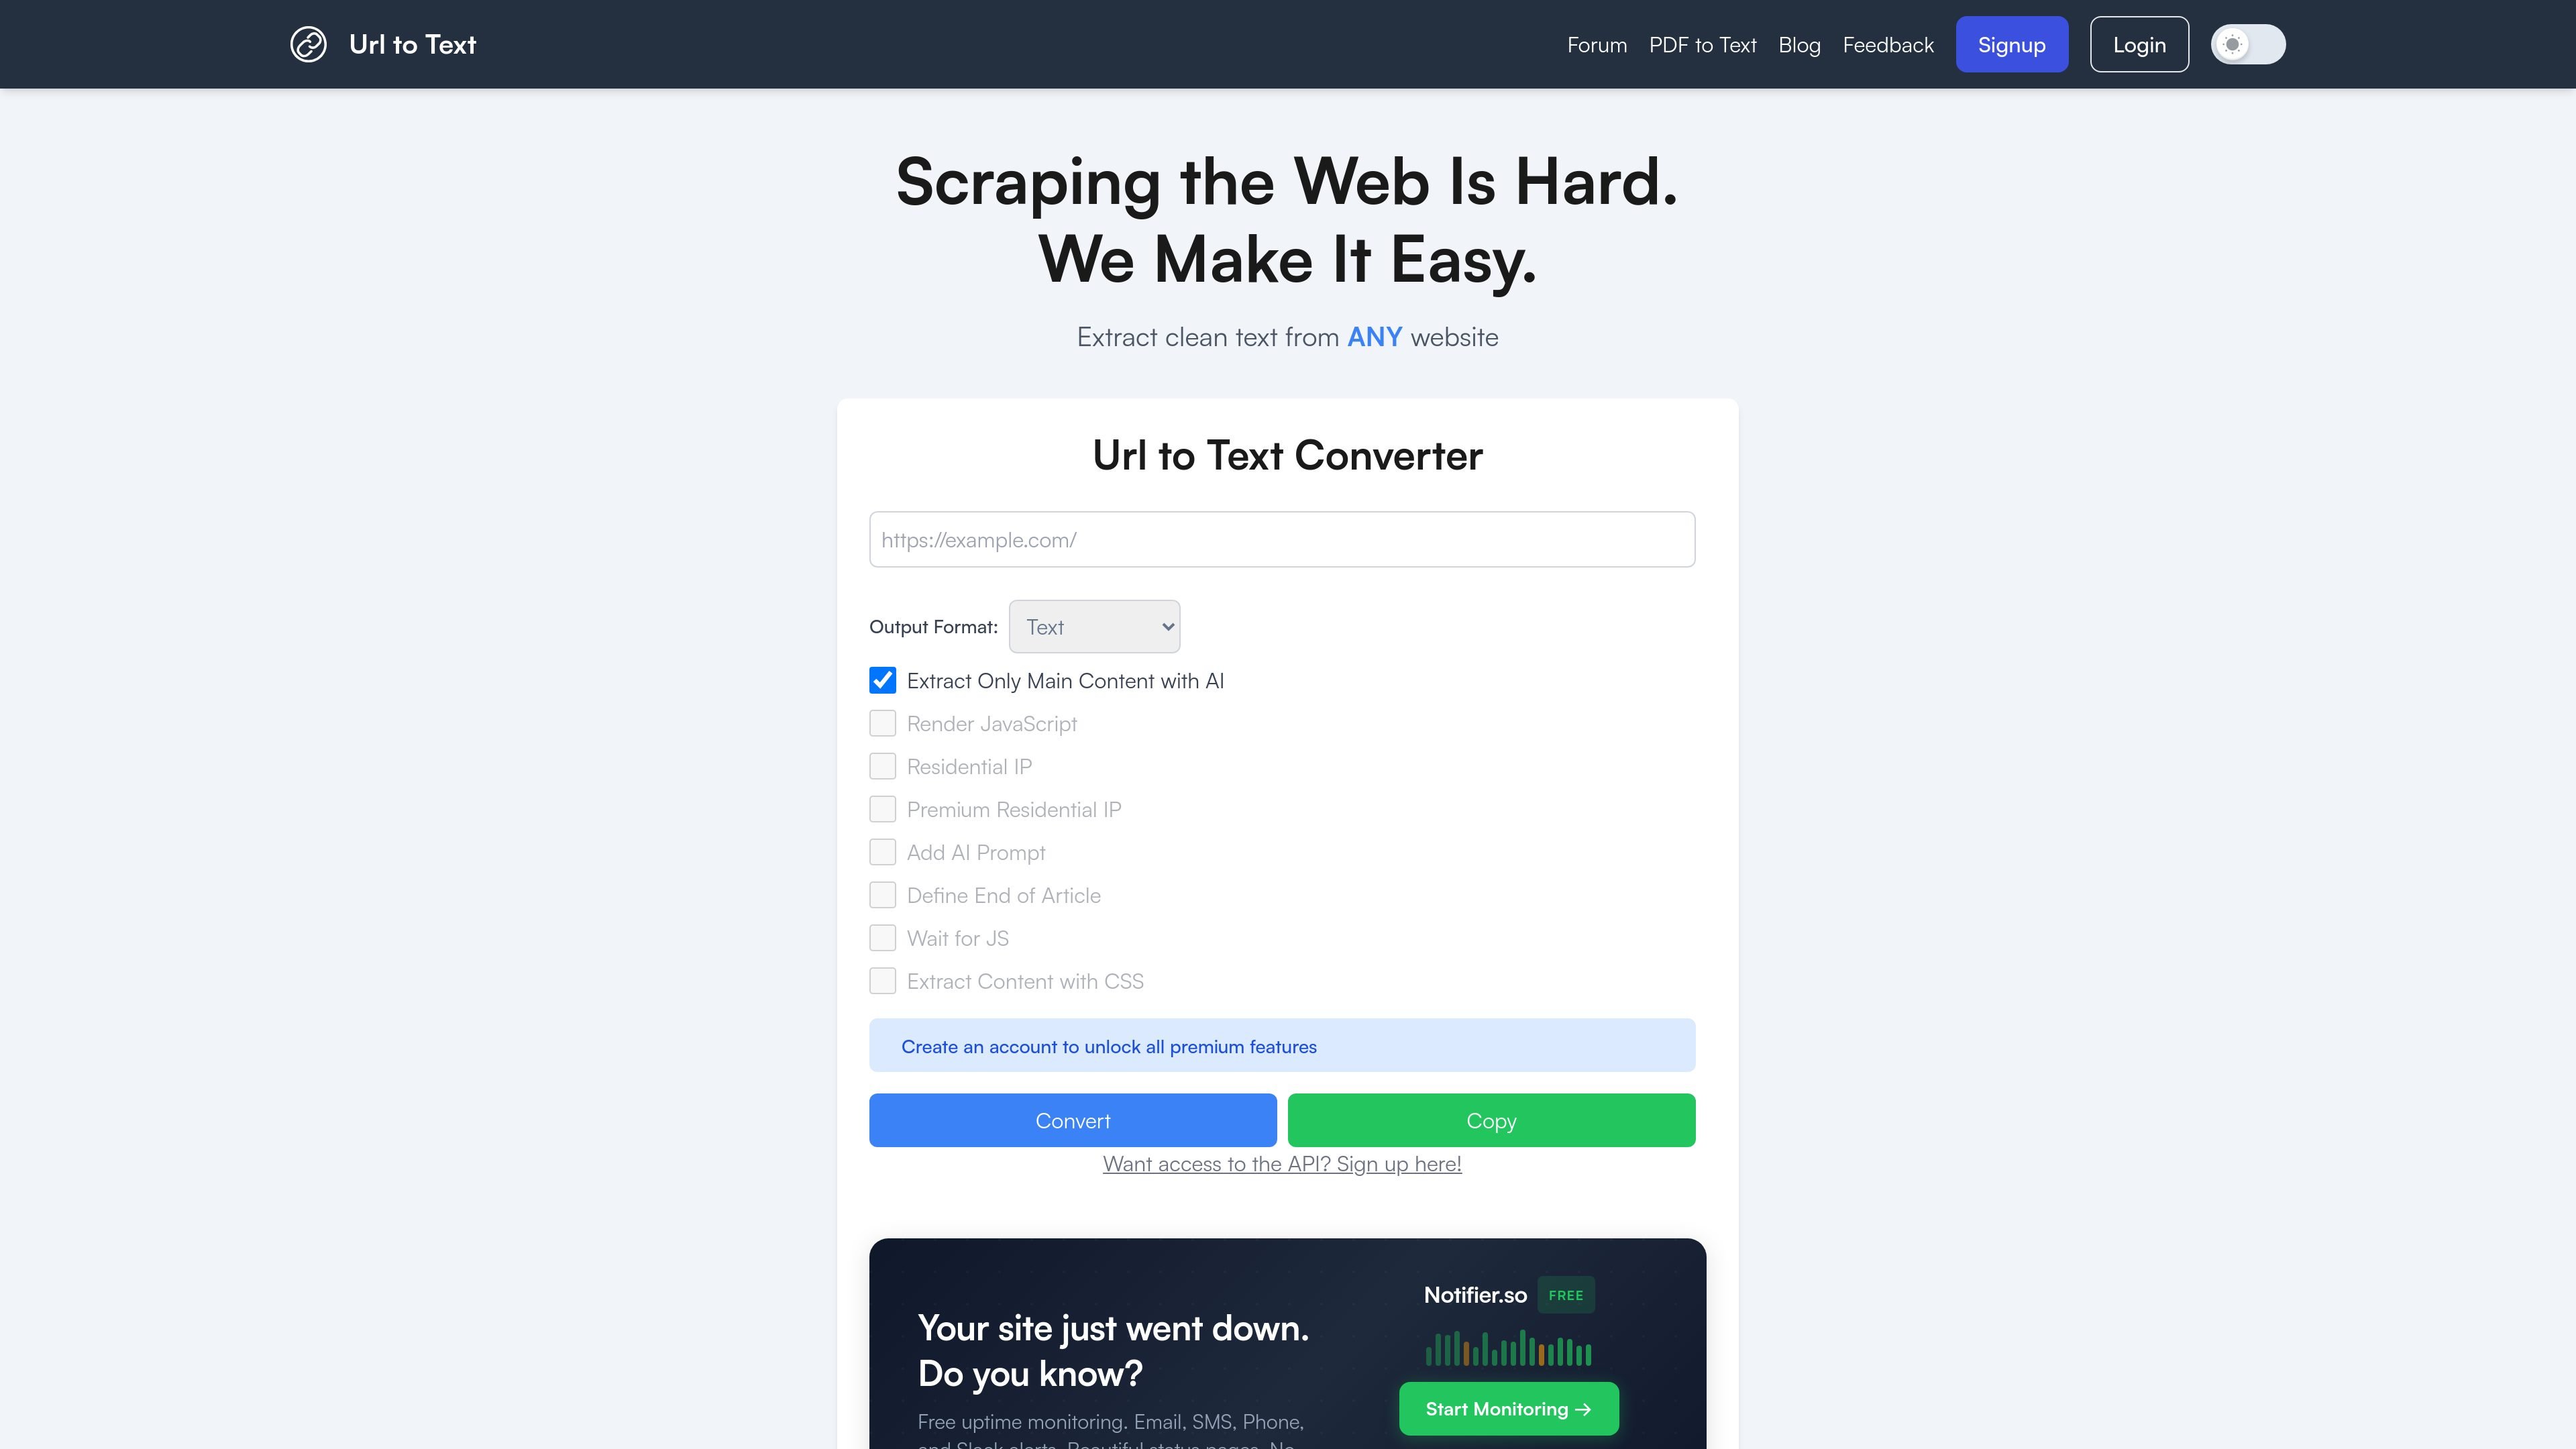
La página de inicio presenta URLtoText como una forma de facilitar la extracción de contenido de la web y añade controles para los casos en que la obtención simple no es suficiente. Estos controles incluyen la extracción del contenido principal con asistencia de IA, la renderización de JavaScript, el acceso mediante IP residencial, los prompts personalizados, la detención al final del artículo, la espera de JavaScript y la extracción mediante selectores CSS.
Convierte una URL en texto sin formato, Markdown o HTML para pegar el resultado en otro flujo de trabajo o herramienta.
Opcionalmente, solicita al servicio que extraiga únicamente el contenido principal relevante de una página mediante un filtrado basado en IA.
Renderiza JavaScript antes de la conversión para páginas que dependen de contenido del lado del cliente.
Usa una dirección IP residencial para la solicitud, teniendo en cuenta que solo se puede seleccionar una opción de proxy a la vez.
Añade un prompt personalizado generado con IA para la extracción al iniciar sesión y desbloquear funciones avanzadas.
Detén la extracción en un límite indicado, como el final de un artículo, o especifica un selector CSS para dirigir el contenido.
Extrae el contenido legible de una noticia, entrada de blog o página de documentación y pégalo en un asistente de IA o una herramienta de escritura.
Convierte páginas con mucho JavaScript después de activar la renderización para capturar en el resultado el contenido que se carga del lado del cliente.
Extrae únicamente la parte relevante de una página extensa mediante la opción de contenido principal, un límite al final del artículo o un selector CSS.
Procesa una URL de YouTube cuando quieras obtener un resultado de texto orientado a una transcripción en lugar de una extracción estándar de página web.
Utiliza controles disponibles solo para cuentas, como IP residenciales o prompts personalizados, cuando una página necesite ayuda adicional para la extracción o un resultado más adaptado.
La herramienta acepta una URL y devuelve el contenido de la página como texto sin formato o Markdown. La página de inicio también incluye controles de extracción opcionales, como la extracción del contenido principal con IA, la renderización de JavaScript, el uso de IP residencial, los prompts personalizados de IA, la detención al final del artículo, la espera de JavaScript y la extracción mediante selectores CSS.
La página de inicio muestra un flujo sencillo: introduce una URL, elige un formato de salida y las opciones disponibles, y luego haz clic en Convertir para copiar el resultado. También indica que las URL de YouTube se detectan y se tratan de forma especial, y que las opciones adicionales se desactivan cuando no son aplicables.
Los formatos de salida que se muestran en la página de inicio son Texto, Markdown y HTML.
El sitio indica que la versión gratuita tiene límites de uso, mientras que la versión de pago ofrece funciones adicionales, más funcionalidades y una API robusta sin límites de uso. La página de precios devolvió un error, por lo que no hay detalles exactos de los planes disponibles.
El sitio afirma que prioriza la seguridad de los datos, utiliza analítica web básica para aplicar límites de uso y proteger el servicio, y no vende a terceros los datos de las URL enviadas.
Los datos de tráfico son solo como referencia.

mrscraper.com
Plataforma de web scraping con extracción basada en IA, proxies residenciales y un navegador de scraping alojado para recopilar datos estructurados de sitios web públicos y gestionar páginas dinámicas o bloqueadas.
pandaextract.com
Ultimate Web Scraper es una extensión de Chrome que ayuda a extraer datos estructurados de sitios web, como listas, tablas, correos electrónicos, imágenes, enlaces y texto de páginas. Admite uso local en el navegador y ejecuciones en la nube para programación, colaboración e integraciones.

oxylabs.io
Plataforma de datos web para recopilar datos públicos con proxies, API de scraping, herramientas de navegador y conjuntos de datos personalizados.

browse.ai
Plataforma de scraping web y monitorización de sitios web sin código para extraer datos estructurados, seguir cambios y conectarlos con API y otras herramientas.

octoparse.com
Plataforma de extracción web sin código para recopilar datos estructurados de sitios web, con flujos visuales, ejecución local y en la nube y exportación a formatos y herramientas habituales.

octen.ai
Infraestructura de búsqueda en tiempo real para aplicaciones de IA, con herramientas de búsqueda web, generación de respuestas y extracción de contenido para agentes, copilotos y chatbots que necesitan contexto web actualizado.