
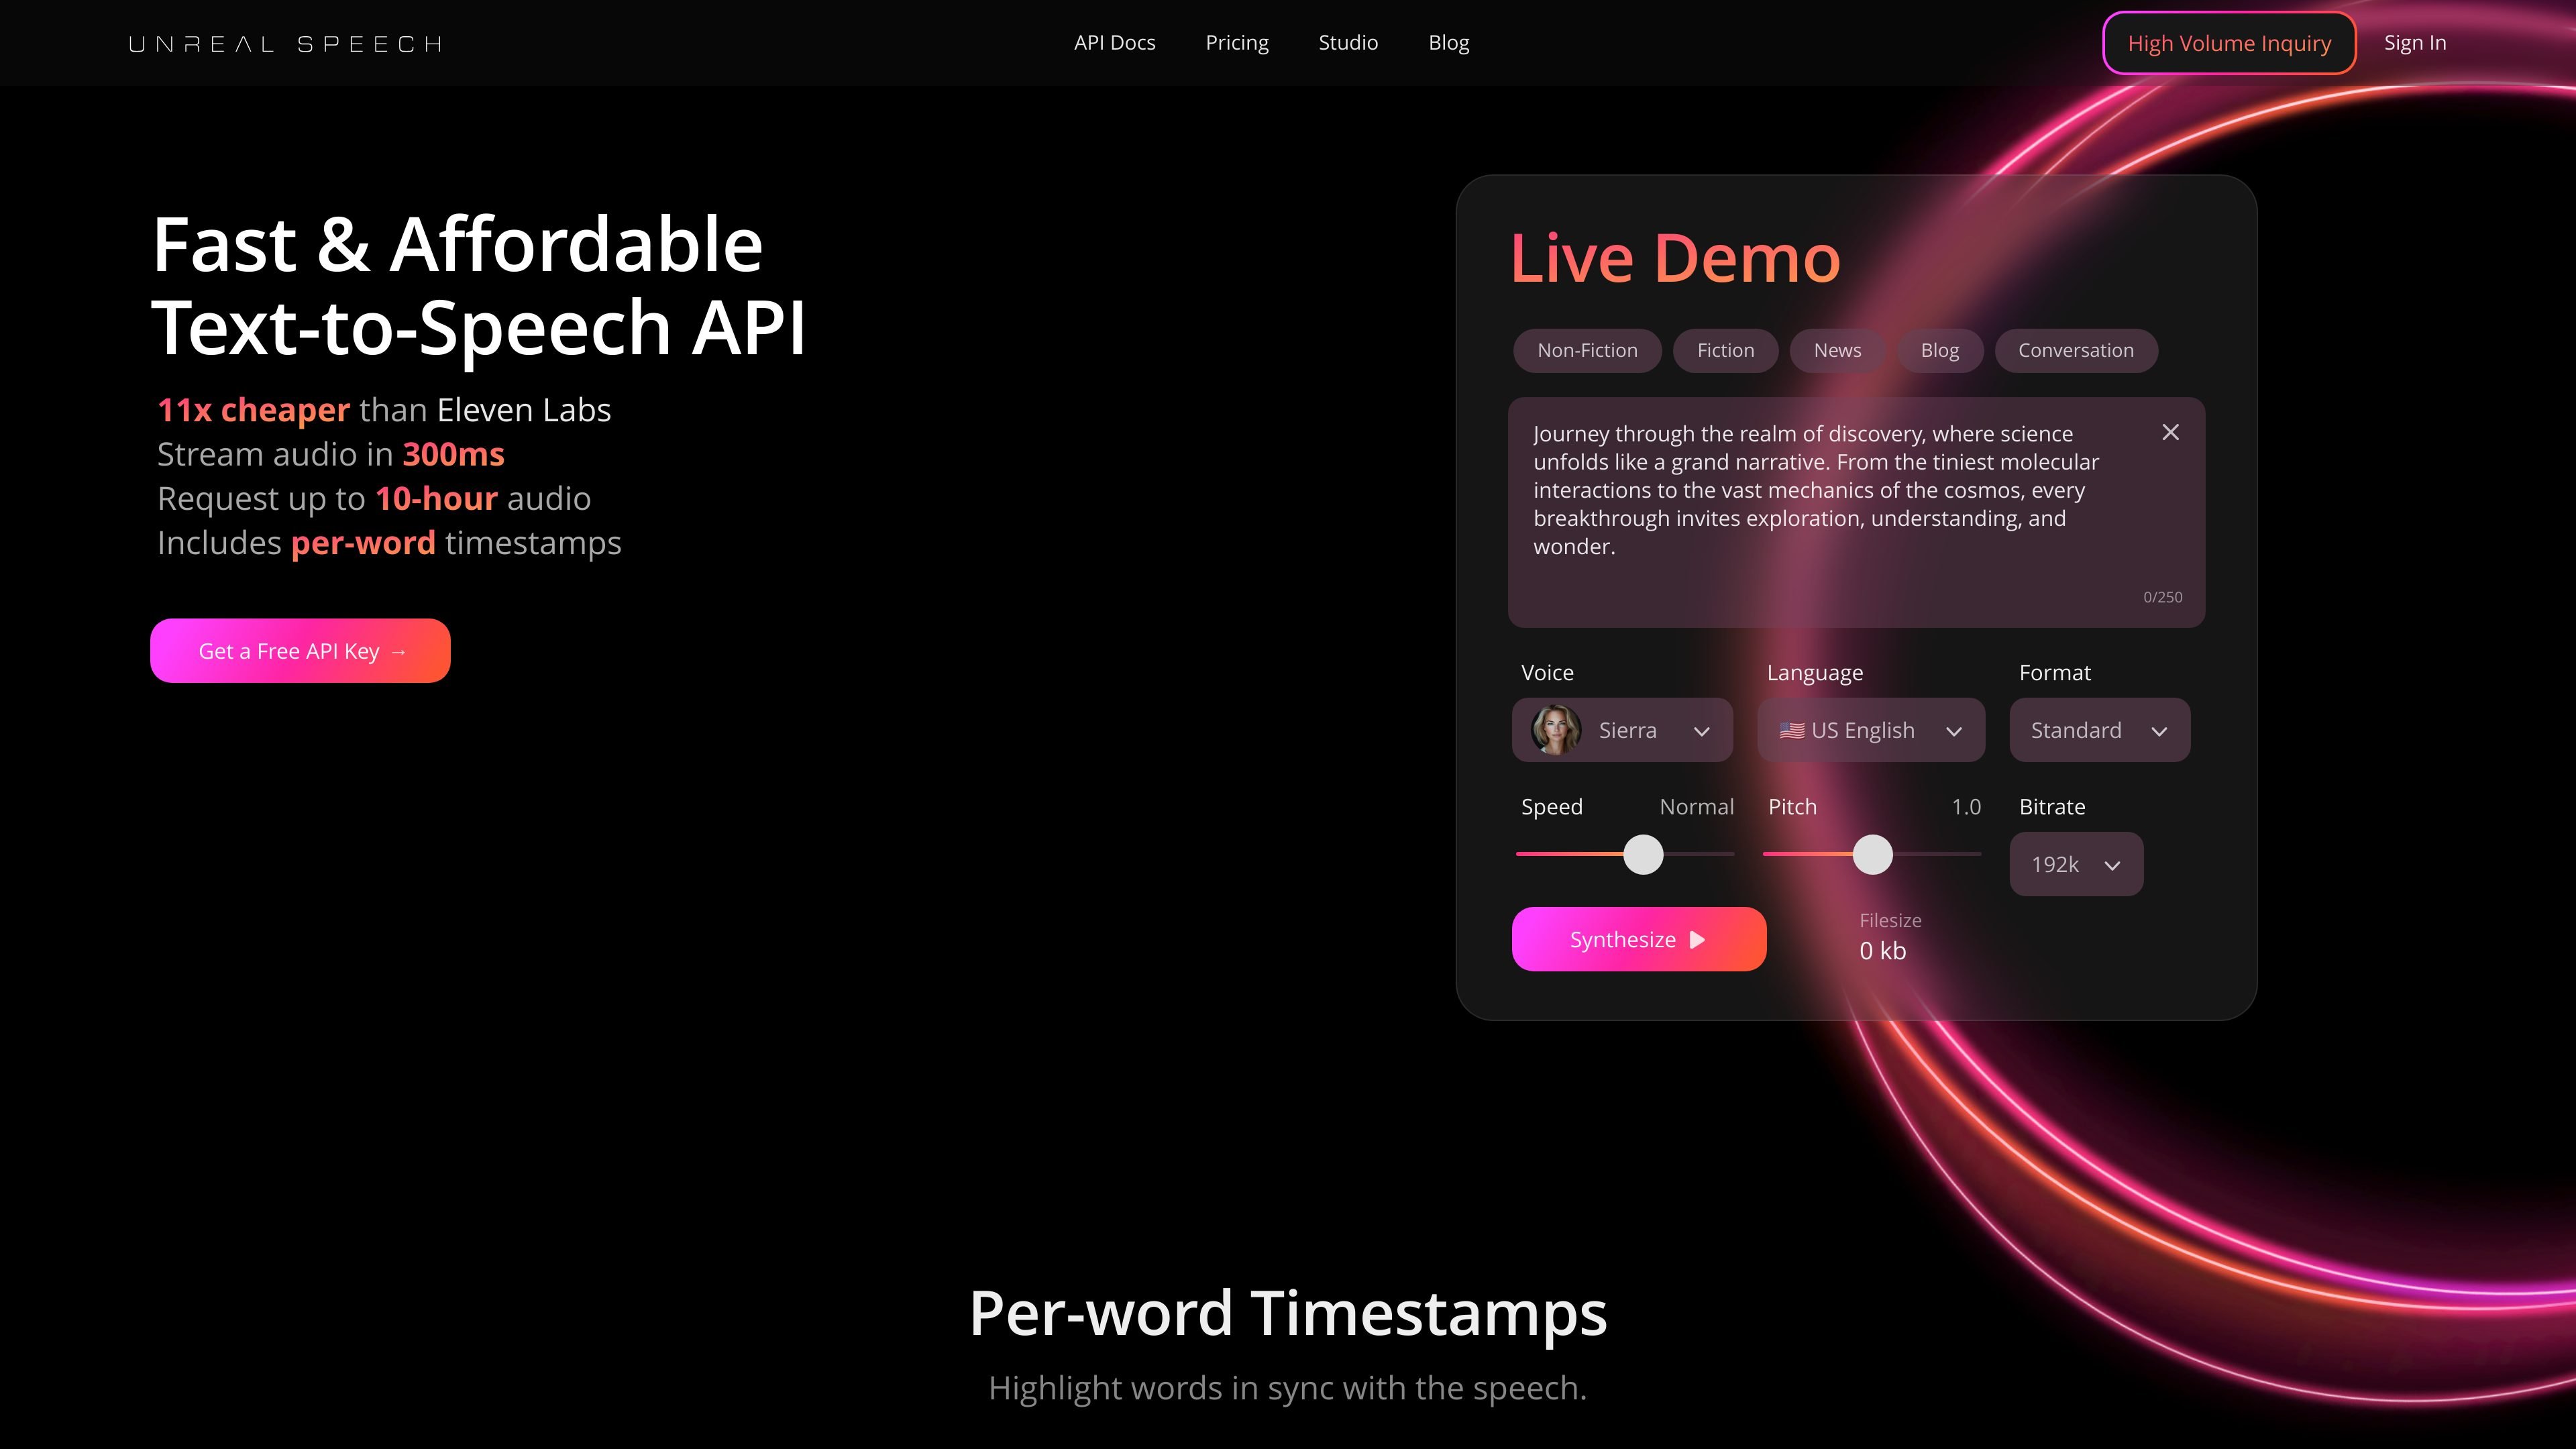
Síntesis rápida mediante streaming
La página de inicio y la documentación muestran una vía rápida de streaming para la salida de texto a voz, con audio disponible en aproximadamente 300 ms para el endpoint `/stream`.

API de texto a voz para desarrolladores que necesitan generación rápida, marcas de tiempo, varios flujos de API y una demo gratuita en el navegador con voces Kokoro TTS.
Unreal Speech es una API de texto a voz creada para desarrolladores que necesitan convertir texto escrito en audio hablado con baja latencia y opciones de salida flexibles. El sitio la presenta como un servicio listo para producción, con síntesis mediante streaming, compatibilidad con marcas de tiempo y una demo en el navegador para realizar pruebas rápidas.
El sitio del producto muestra varias formas de usar la plataforma: un endpoint /stream rápido, un endpoint /speech que puede devolver MP3 y URL de marcas de tiempo, un flujo asíncrono /synthesisTasks para textos más largos y un endpoint WebSocket para transmitir audio junto con marcas de tiempo a nivel de palabra. La página del estudio añade una demo online gratuita basada en Kokoro TTS, con 48 voces en 8 idiomas para generar y descargar audio desde el navegador.
La página de inicio y la documentación muestran una vía rápida de streaming para la salida de texto a voz, con audio disponible en aproximadamente 300 ms para el endpoint `/stream`.
La API admite varios patrones de salida: streaming síncrono, asíncrono y basado en WebSocket, para que los equipos puedan elegir el flujo que mejor se adapte a la longitud del texto y a sus necesidades de latencia.
El sitio documenta marcas de tiempo a nivel de palabra o de oración, incluido un flujo WebSocket `/streamWithTimestamps` para datos de sincronización en tiempo real.
La demo del estudio ofrece 48 voces en 8 idiomas, lo que brinda a los usuarios una amplia variedad de opciones de voz e idioma para probar.
La página de precios indica que el servicio puede generar audio de hasta 10 horas y ofrece planes que escalan según el volumen de caracteres, incluido un nivel gratuito y planes de pago de mayor volumen.
El estudio del navegador permite escribir texto, generar voz y descargar grabaciones directamente desde el navegador para realizar evaluaciones rápidas.
Usa el endpoint `/stream` de baja latencia cuando quieras que la salida hablada comience rápidamente, por ejemplo, para respuestas de aplicaciones interactivas o previsualizaciones de narración en tiempo real.
Usa `/speech` o `/synthesisTasks` cuando necesites archivos de audio generados para clips cortos o pasajes más largos, incluido contenido extenso que supera las posibilidades del flujo síncrono.
Usa marcas de tiempo a nivel de palabra o de oración cuando tu aplicación necesite resaltado, sincronización de subtítulos o reproducción de narración alineada con el texto.
Usa la demo del estudio para probar voces en el navegador, comparar opciones de idioma y descargar grabaciones de muestra antes de integrar la API.
Usa los niveles de precios para adaptar el volumen de caracteres a tus patrones de uso, empezando por el nivel gratuito y pasando a planes de mayor volumen a medida que crece la demanda.
Sí. La página de precios incluye un nivel gratuito y planes de pago, y el sitio también ofrece una demo activa del estudio para probar la generación de texto a voz en el navegador.
La documentación que se muestra en la página de inicio incluye `/stream`, `/speech`, `/synthesisTasks` y `/streamWithTimestamps`. El sitio indica que `/stream` es síncrono y rápido, `/speech` devuelve MP3 y URL de marcas de tiempo, `/synthesisTasks` es asíncrono para textos más largos y `/streamWithTimestamps` transmite audio con sincronización a nivel de palabra.
El sitio indica que las marcas de tiempo se pueden solicitar con `TimestampType` configurado como `word` o `sentence`, y también menciona un flujo WebSocket para transmitir tanto el audio como las marcas de tiempo.
La página del estudio indica que Kokoro TTS Studio admite 48 voces en 8 idiomas, incluidos inglés estadounidense y británico, francés, hindi, español, japonés, chino, italiano y portugués.
El sitio presenta Unreal Speech para uso comercial mediante su documentación de API, mientras que la página del estudio describe la demo del navegador como una experiencia online gratuita de texto a voz para probar el modelo y descargar audio.
Los datos de tráfico son solo como referencia.

ttsmaker.com
TTSMaker es una herramienta web gratuita de texto a voz y generación de voces con IA que convierte texto en audio hablado en más de 100 idiomas, con descarga de archivos de audio, exportación de subtítulos y una opción Pro para un mayor uso.

revocalize.ai
Generación y clonación de voz con IA desde el navegador para creadores, músicos, productores y desarrolladores, con modelos licenciados, conversión de voz y planes desde una opción gratuita hasta soluciones empresariales.

naturalreaders.com
NaturalReader es una herramienta de texto a voz con IA para escuchar documentos, PDF, sitios web y libros con voces naturales, además de ofrecer funciones para educación y generación de voz comercial.

fish.audio
Plataforma de voz con IA para convertir texto en voz, clonar voces, transcribir audio y crear flujos de trabajo con agentes de voz.

ttsreader.com
Herramienta de texto a voz en el navegador para leer textos, documentos, PDF, libros electrónicos y páginas web en voz alta, con exportación a MP3, voces multilingües y controles de pronunciación.

ttsmaker.cn
TTSMaker (Ma Ke Pei Yin) es una plataforma gratuita en línea de texto a voz para convertir texto en audio, reproducirlo en línea o descargarlo, con opciones multilingües y de varios hablantes.