
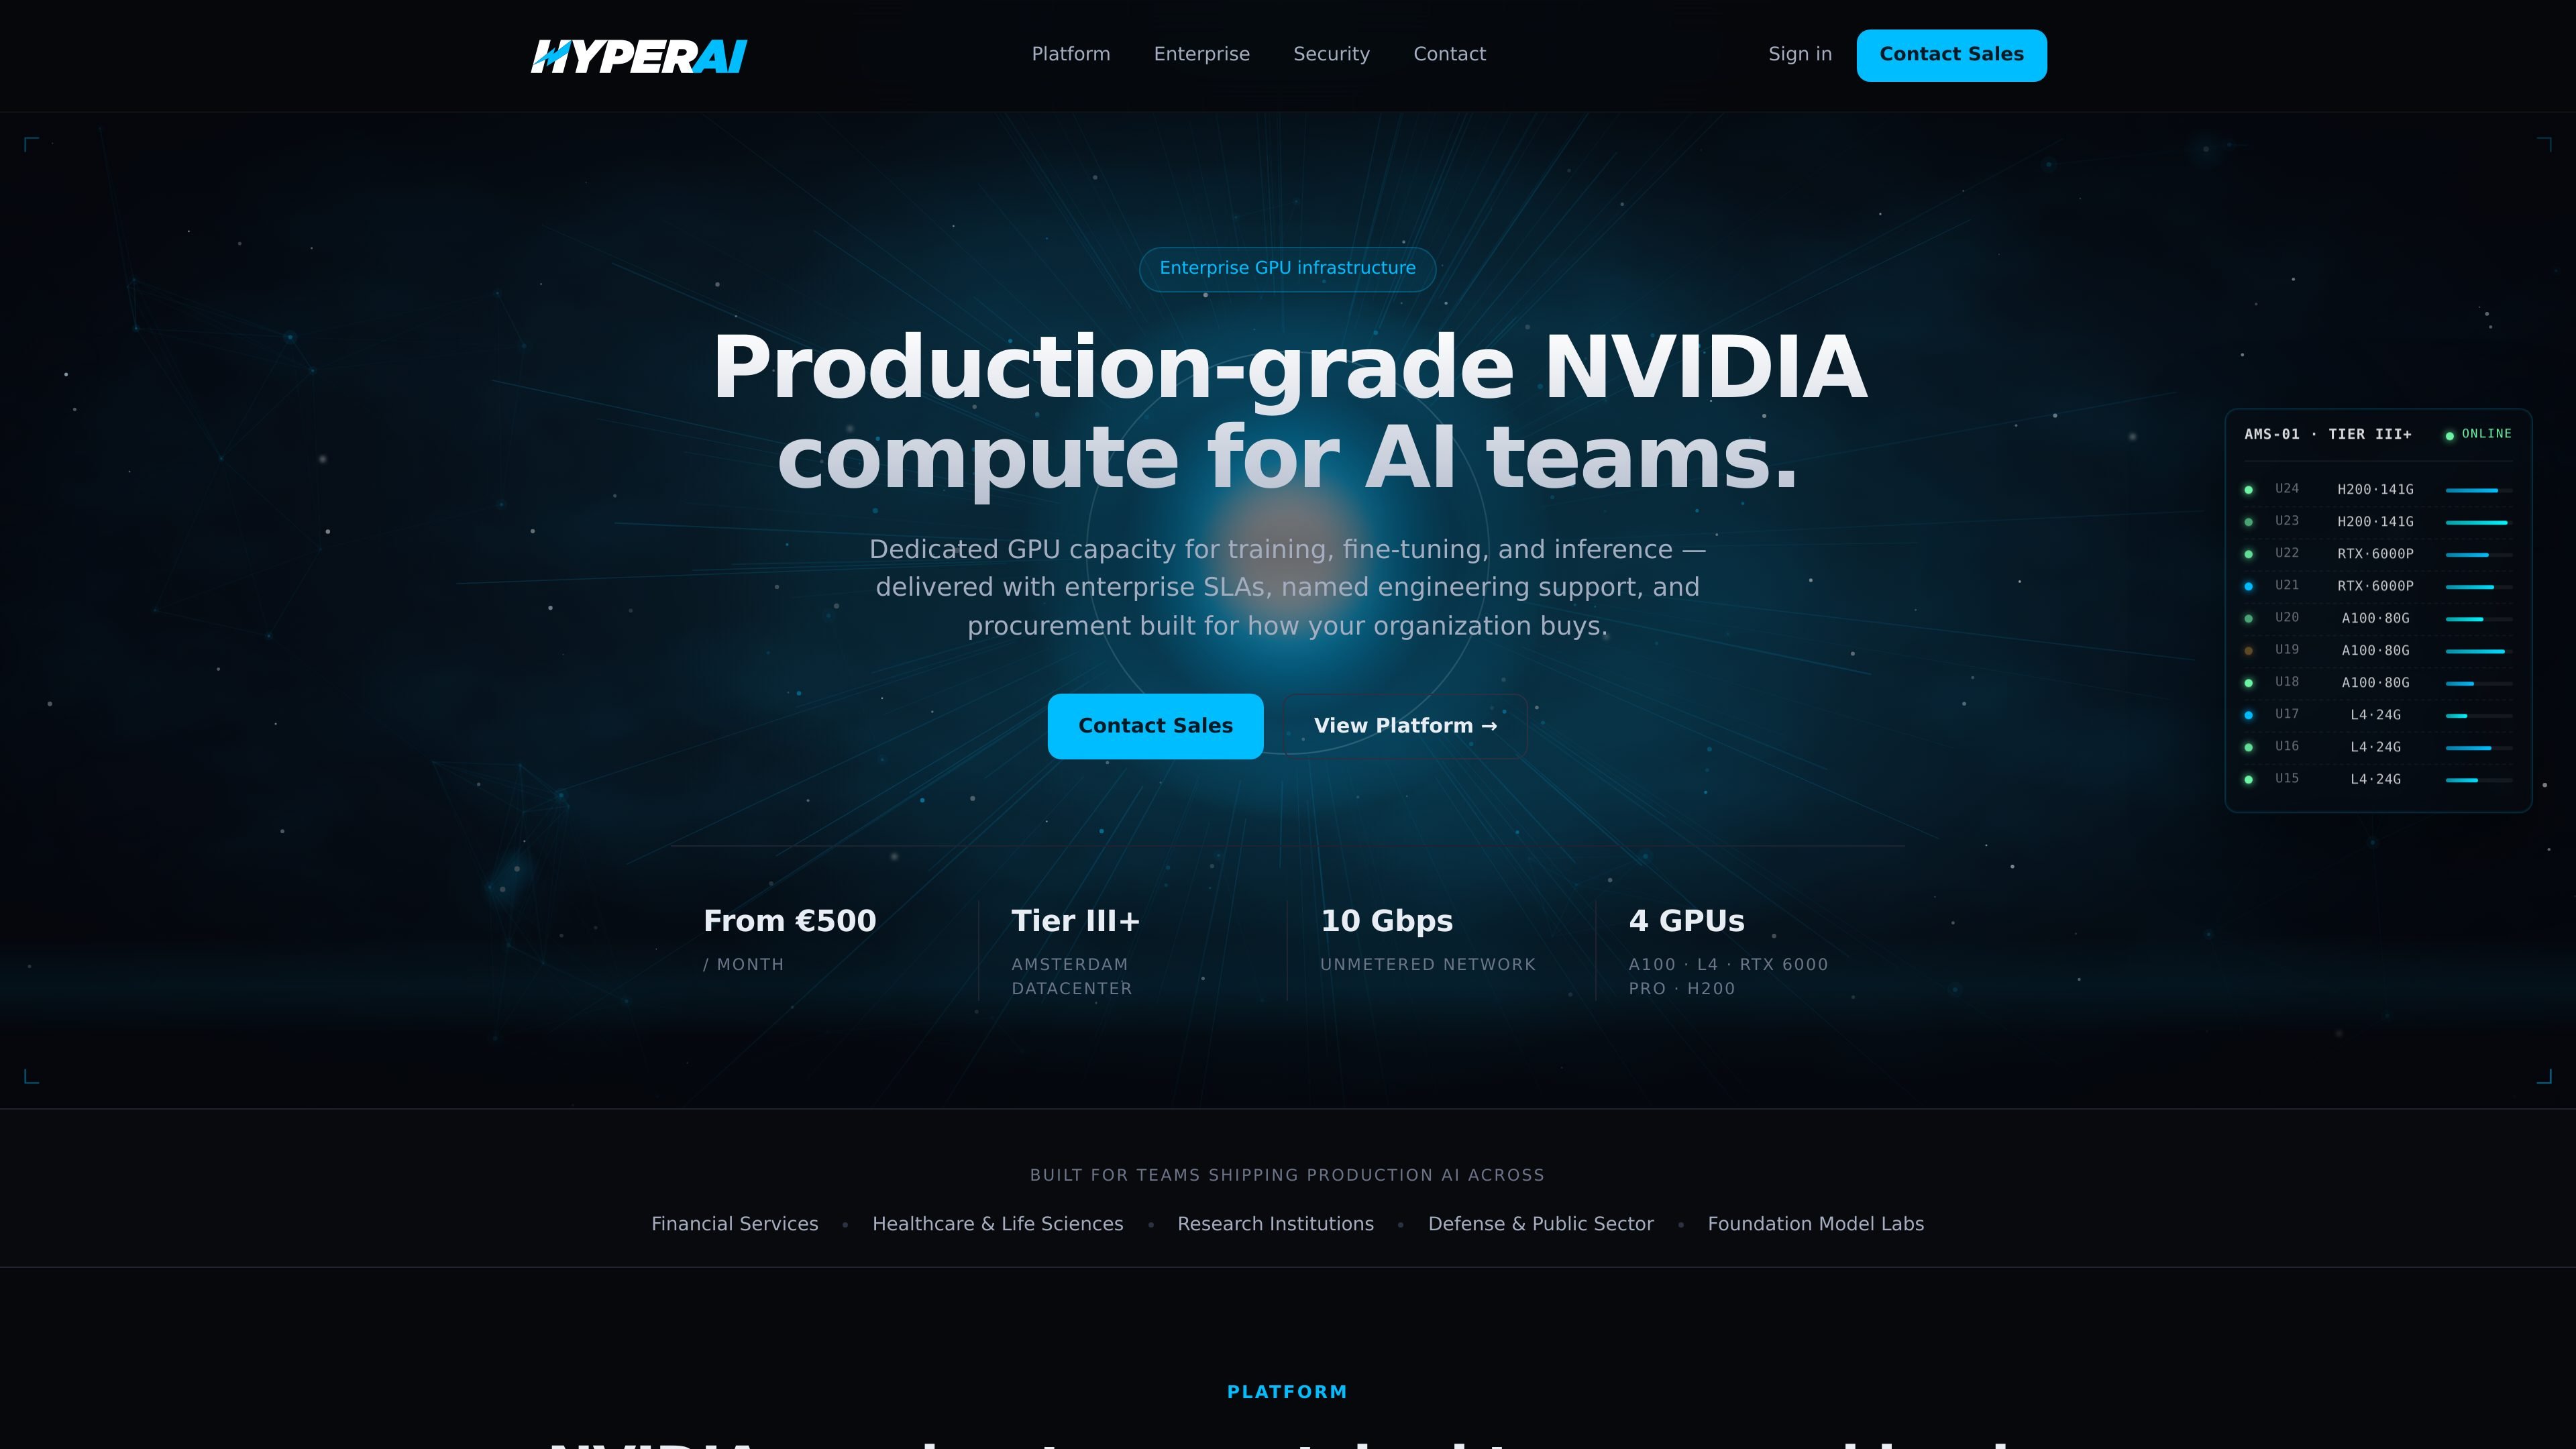
Varias familias de GPU NVIDIA
HyperAI ofrece configuraciones con GPU A100, L4, RTX 6000 Pro y H200 para que los equipos elijan el hardware adecuado para entrenamiento, inferencia o ventanas de contexto más amplias.
HyperAI ofrece infraestructura empresarial con GPU NVIDIA para equipos de IA que necesitan capacidad de cómputo dedicada para entrenamiento, ajuste fino e inferencia.
HyperAI es un servicio empresarial de infraestructura con GPU para equipos de IA que necesitan capacidad de cómputo NVIDIA dedicada en lugar de instancias de nube compartidas. El sitio lo presenta como infraestructura de nivel de producción para entrenamiento, ajuste fino e inferencia, con opciones de hardware que incluyen A100, L4, RTX 6000 Pro y H200.
Sus páginas públicas destacan opciones de implementación adaptadas a las compras empresariales: nodos de un solo inquilino o clústeres aislados, disponibilidad respaldada por SLA, soporte de ingeniería personalizado y contratos de capacidad reservada. Cada nivel incluye una base de infraestructura gestionada en un centro de datos Tier III+ de Ámsterdam, con redes de 10 Gbps y almacenamiento NVMe local.
HyperAI ofrece configuraciones con GPU A100, L4, RTX 6000 Pro y H200 para que los equipos elijan el hardware adecuado para entrenamiento, inferencia o ventanas de contexto más amplias.
La página de inicio describe nodos de un solo inquilino y clústeres aislados, dirigidos a entornos que necesitan capacidad de cómputo dedicada sin compartir nodos con otros clientes.
Cada implementación incluye un centro de datos Tier III+ en Ámsterdam, un vPort de 10 Gbps y tráfico no medido sujeto a condiciones de uso razonable, lo que proporciona una base de infraestructura fija.
Las configuraciones combinan la GPU con procesadores AMD EPYC, almacenamiento NVMe y niveles definidos de RAM y vCPU, lo que permite dimensionar las implementaciones según los requisitos de la carga de trabajo.
El sitio indica que la capacidad reservada está disponible mediante contratos anuales y plurianuales, con asignación garantizada y precios fijos previa solicitud.
HyperAI incluye soporte técnico personalizado, con un gerente técnico de cuenta dedicado e ingenieros de guardia las 24 horas, los 7 días de la semana, en lugar de una cola de tickets genérica.
Usa las configuraciones A100 y H200 para entrenamiento, ajuste fino y trabajo con LLM de vanguardia que requieren mucha memoria, cuando la capacidad de NVLink o HBM es importante.
Usa L4 para cargas de trabajo de inferencia en producción, como chatbots, embeddings y canalizaciones de vídeo, cuando son importantes la eficiencia energética y una capacidad de GPU dimensionada adecuadamente.
Usa RTX 6000 Pro para inferencia con gran contexto o entrenamiento denso en un solo nodo cuando quieras una GPU de clase Blackwell con 96 GB de memoria.
Usa el modelo de tenencia dedicada y clústeres aislados para organizaciones que desean capacidad de GPU reservada, precios fijos previa solicitud y contratos adaptados a las compras empresariales.
Usa la infraestructura basada en Ámsterdam y el modelo de soporte personalizado para equipos que necesitan una implementación gestionada con una responsabilidad operativa clara.
HyperAI es un servicio gestionado de infraestructura empresarial con GPU para cargas de trabajo de IA. La página de inicio lo posiciona para entrenamiento, ajuste fino e inferencia en GPU NVIDIA, con cargas de trabajo distribuidas entre configuraciones A100, L4, RTX 6000 Pro y H200.
El sitio muestra nodos dedicados de un solo inquilino y clústeres aislados, pero no documenta los pasos de configuración de autoservicio. Las páginas públicas presentan un proceso de adquisición guiado por ventas, con enlaces a la plataforma y a la ficha técnica, en lugar de un asistente de incorporación documentado.
HyperAI enumera una infraestructura base que incluye un centro de datos Tier III+ en Ámsterdam, red no medida de 10 Gbps, almacenamiento NVMe y CPU AMD EPYC adaptadas a cada GPU. Las páginas públicas proporcionadas no describen integraciones de software ni herramientas de orquestación específicas.
La página de inicio indica que cada implementación incluye soporte de ingeniería personalizado, incluido un gerente técnico de cuenta dedicado e ingenieros de guardia las 24 horas, los 7 días de la semana. También menciona disponibilidad respaldada por SLA, con un compromiso de disponibilidad del 99,9 % y créditos de servicio.
El sitio público no muestra una página de precios verificada. La página de inicio enumera precios mensuales iniciales para cada configuración de GPU e indica que hay descuentos anuales y plurianuales disponibles previa solicitud, sin IVA.
Los datos de tráfico son solo como referencia.

crusoe.ai
Infraestructura cloud de IA, inferencia gestionada y capacidad de centros de datos para entrenar y servir cargas de trabajo de IA a escala.
fluidstack.io
Fluidstack construye y opera infraestructura de IA a gran escala, incluida la adquisición de energía, la construcción de centros de datos y su operación, con el objetivo declarado de entregar capacidad de cómputo más rápido que los plazos habituales del sector.

humaans.io
Humaans es un HRIS con inteligencia artificial para equipos en crecimiento que centraliza los datos de personal, automatiza los flujos de trabajo de RR. HH. y ofrece asistencia basada en IA para políticas, documentos y consultas sobre la plantilla.

bulbthings.com
Bulbthings es una plataforma de gestión de activos que permite controlar equipos, inventario, mantenimiento y flujos de trabajo relacionados desde un solo sistema. Ofrece un plan gratuito para equipos pequeños y planes de pago y servicios adicionales para necesidades mayores o más específicas.
lopus.ai
Plataforma de analítica empresarial para equipos de RevOps y BizOps que unifica datos de CRM, ingresos, clientes y almacenes, con consultas, paneles, informes, hojas y alertas de métricas transparentes.

www.mindcase.co
Mindcase ofrece API de datos web y acceso mediante prompts para extraer datos estructurados de LinkedIn, Google Maps, Amazon, Instagram, Reddit y más. Los equipos y agentes pueden recopilar registros listos para analizar mediante scrapers prediseñados, ejecuciones de API y conectividad MCP.