
Catálogo de modelos compatibles
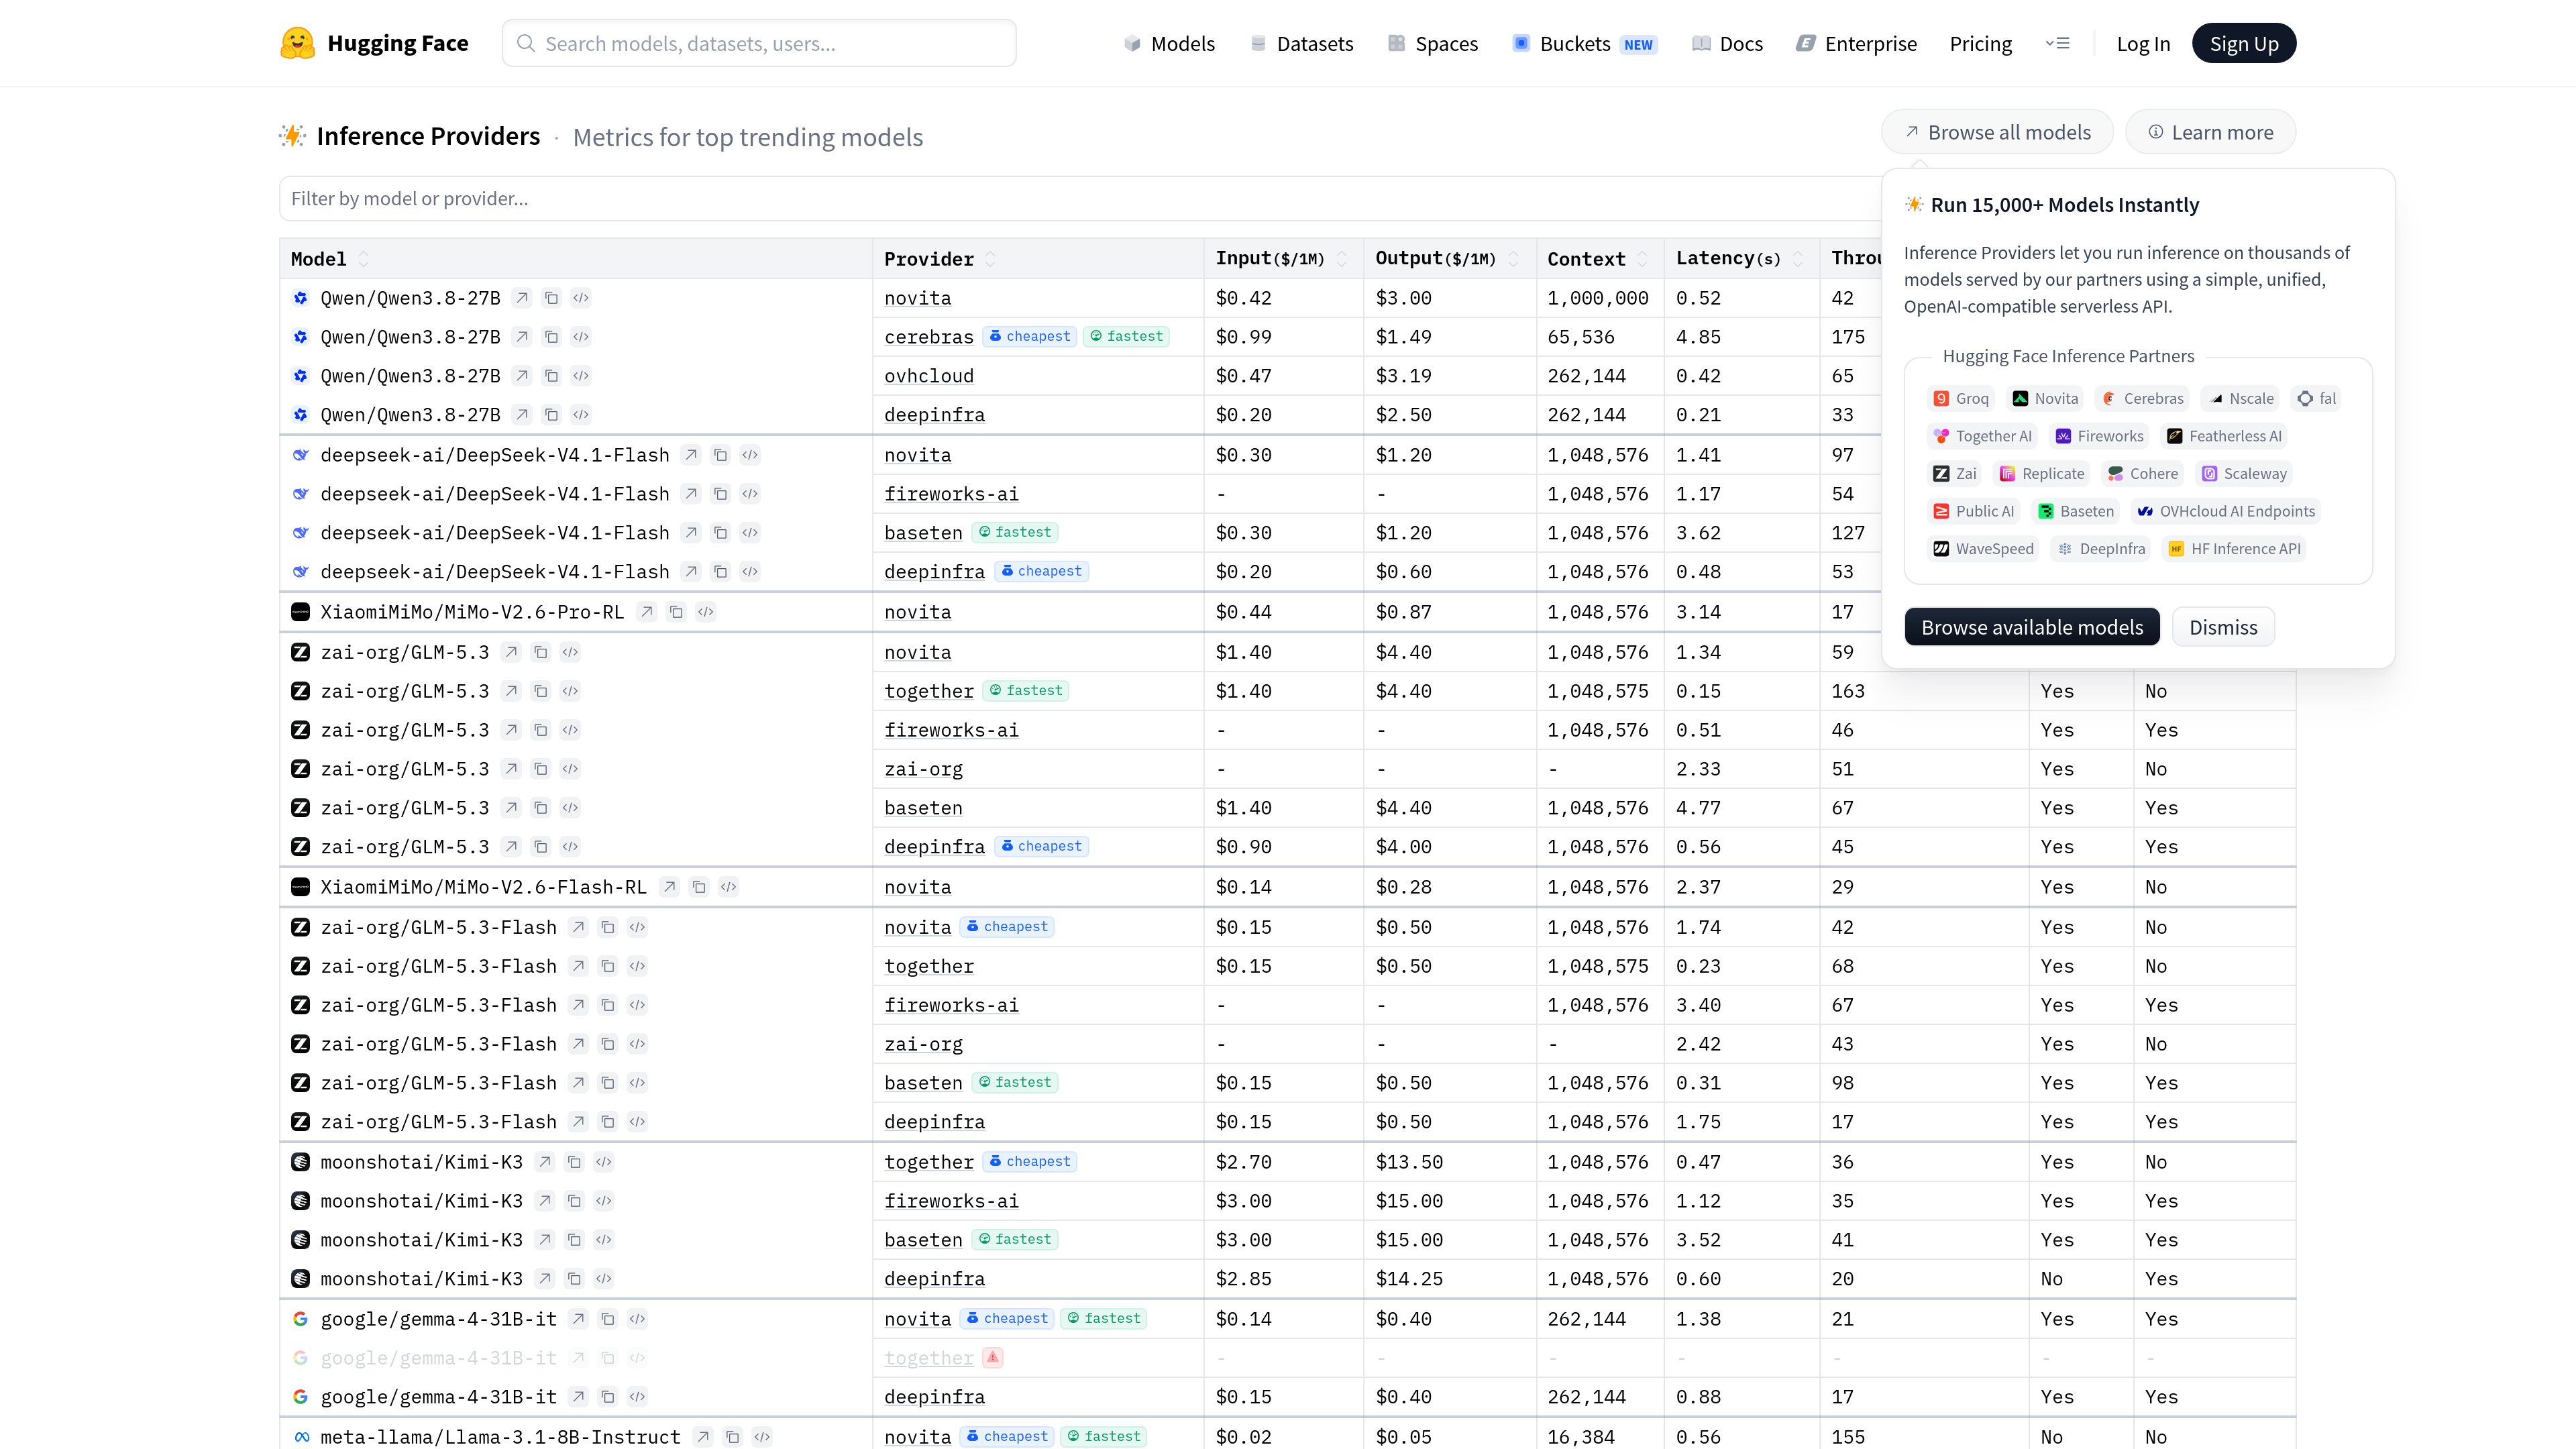
Explora entradas de modelos asociadas con los proveedores de infraestructura que indican compatibilidad con ellos, incluidos modelos como Qwen3.8-27B, DeepSeek-V4.1-Flash, GLM-5.3 y gpt-oss-120b.

Compara modelos compatibles entre proveedores de infraestructura según disponibilidad, precios, límites de contexto, latencia, rendimiento y capacidades.
Hugging Face Inference Providers es una capa de servicio de modelos y comparación de proveedores asociada con Hugging Face Hub. Su catálogo de modelos compatibles muestra qué proveedores de infraestructura ofrecen determinados modelos y presenta datos operativos para comparar esas opciones. El catálogo está dirigido principalmente a desarrolladores y equipos que evalúan la inferencia alojada para aplicaciones basadas en modelos de Hugging Face.
El objetivo principal del catálogo es comparar opciones específicas de cada proveedor para un mismo modelo. Muestra los precios de entrada y salida cuando están disponibles, los límites de contexto, la latencia, el rendimiento, la compatibilidad con herramientas y la compatibilidad con salidas estructuradas. Como estos valores pueden variar entre proveedores, la combinación de modelo y proveedor —no solo el nombre del modelo— es la unidad relevante para la evaluación.
Inference Providers debe distinguirse de Hugging Face Inference Endpoints. El producto Endpoints se presenta como una forma de implementar cualquier modelo de IA de Hugging Face Hub, mientras que Inference Providers presenta opciones de proveedores alojados compatibles y sus métricas comparativas.
Explora entradas de modelos asociadas con los proveedores de infraestructura que indican compatibilidad con ellos, incluidos modelos como Qwen3.8-27B, DeepSeek-V4.1-Flash, GLM-5.3 y gpt-oss-120b.
Compara los precios de entrada y salida mostrados por cada millón de tokens cuando hay precios disponibles. Algunas filas muestran un guion en lugar de un precio, por lo que la disponibilidad no es uniforme entre proveedores.
Consulta la latencia indicada en segundos y el rendimiento en tokens por segundo para combinaciones individuales de modelo y proveedor, en lugar de basarte únicamente en especificaciones del modelo.
Comprueba el valor de contexto indicado para cada fila. El catálogo incluye límites considerablemente diferentes entre modelos y proveedores, y algunas entradas no muestran un valor de contexto.
La tabla indica si una entrada de proveedor es compatible con herramientas y salidas estructuradas, lo que permite filtrar opciones según los requisitos de la aplicación.
El directorio general de Hugging Face Tasks organiza modelos en tareas de texto, visión, audio, vídeo, multimodales, tabulares y aprendizaje por refuerzo; el catálogo de proveedores se centra en entradas de inferencia alojada compatibles.
Un desarrollador puede revisar varias filas de proveedores para el mismo modelo y sopesar el coste, la latencia, el rendimiento, el contexto y los indicadores de capacidades mostrados antes de seleccionar una ruta de inferencia.
Un equipo cuya aplicación necesita usar herramientas o generar salidas estructuradas puede utilizar los indicadores correspondientes de la tabla para acotar las combinaciones disponibles de proveedor y modelo.
Un equipo de ingeniería puede comparar los precios de los tokens de entrada y salida con la latencia y el rendimiento, por ejemplo, al decidir entre un proveedor de menor coste y una opción indicada como más rápida.
Los usuarios pueden utilizar el directorio general de Hugging Face Tasks para orientar el descubrimiento de modelos en tareas de lenguaje, visión por ordenador, audio, vídeo, multimodales, tabulares y aprendizaje por refuerzo antes de examinar las opciones alojadas.
Los equipos pueden utilizar el catálogo de proveedores para comparar las opciones alojadas indicadas y considerar Inference Endpoints por separado cuando su requisito sea implementar un modelo de Hugging Face Hub.
Compara combinaciones compatibles de modelo y proveedor mediante los precios de entrada y salida mostrados cuando están disponibles, los límites de contexto, la latencia, el rendimiento, la compatibilidad con herramientas y la compatibilidad con salidas estructuradas.
No. Algunas filas omiten los precios, los valores de contexto o los valores de rendimiento, y los indicadores de capacidades pueden variar entre proveedores para el mismo modelo.
La página presenta la latencia y el rendimiento como métricas de comparación para sus entradas indicadas. Deben considerarse valores del catálogo para esas entradas, no garantías universales de rendimiento.
Inference Providers presenta opciones de proveedores alojados compatibles y datos comparativos. Inference Endpoints se presenta por separado como un producto para implementar cualquier modelo de IA de Hugging Face Hub.
El directorio Tasks incluye áreas de tareas de lenguaje, visión por ordenador, audio, vídeo, multimodales, tabulares y aprendizaje por refuerzo. El catálogo de proveedores es una superficie de comparación de modelos compatibles y proveedores, por lo que la compatibilidad con tareas debe comprobarse para cada modelo específico.
zenmux.ai
Plataforma empresarial de LLM con una API unificada para acceder a múltiples proveedores de modelos, enrutamiento automático de prompts, seguimiento de costes y precios por uso o suscripción.

router.com
Router by Ramp es una puerta de enlace para LLM que ofrece un único endpoint de API para acceder a modelos de varios proveedores y enruta las solicitudes según el coste, la calidad y la disponibilidad, con visibilidad del uso y el gasto.

eachlabs.ai
each::labs ofrece una API única para orquestar más de 600 modelos de IA, con enrutamiento, gestión de fallos, observabilidad y precios basados en el uso.

wiro.ai
Wiro AI es una API unificada y un marketplace de modelos para ejecutar modelos de imagen, vídeo, audio, lenguaje y otras capacidades de IA.

aihubmix.com
AIHubMix ofrece una puerta de enlace API y un catálogo para conectar con modelos de distintos proveedores mediante una interfaz común. Los desarrolladores pueden probar modelos y gestionar claves con restricciones configurables.

zro.moonmath.ai
Endpoint privado de inferencia para agentes de programación con modelos de código de pesos abiertos en infraestructura europea.