
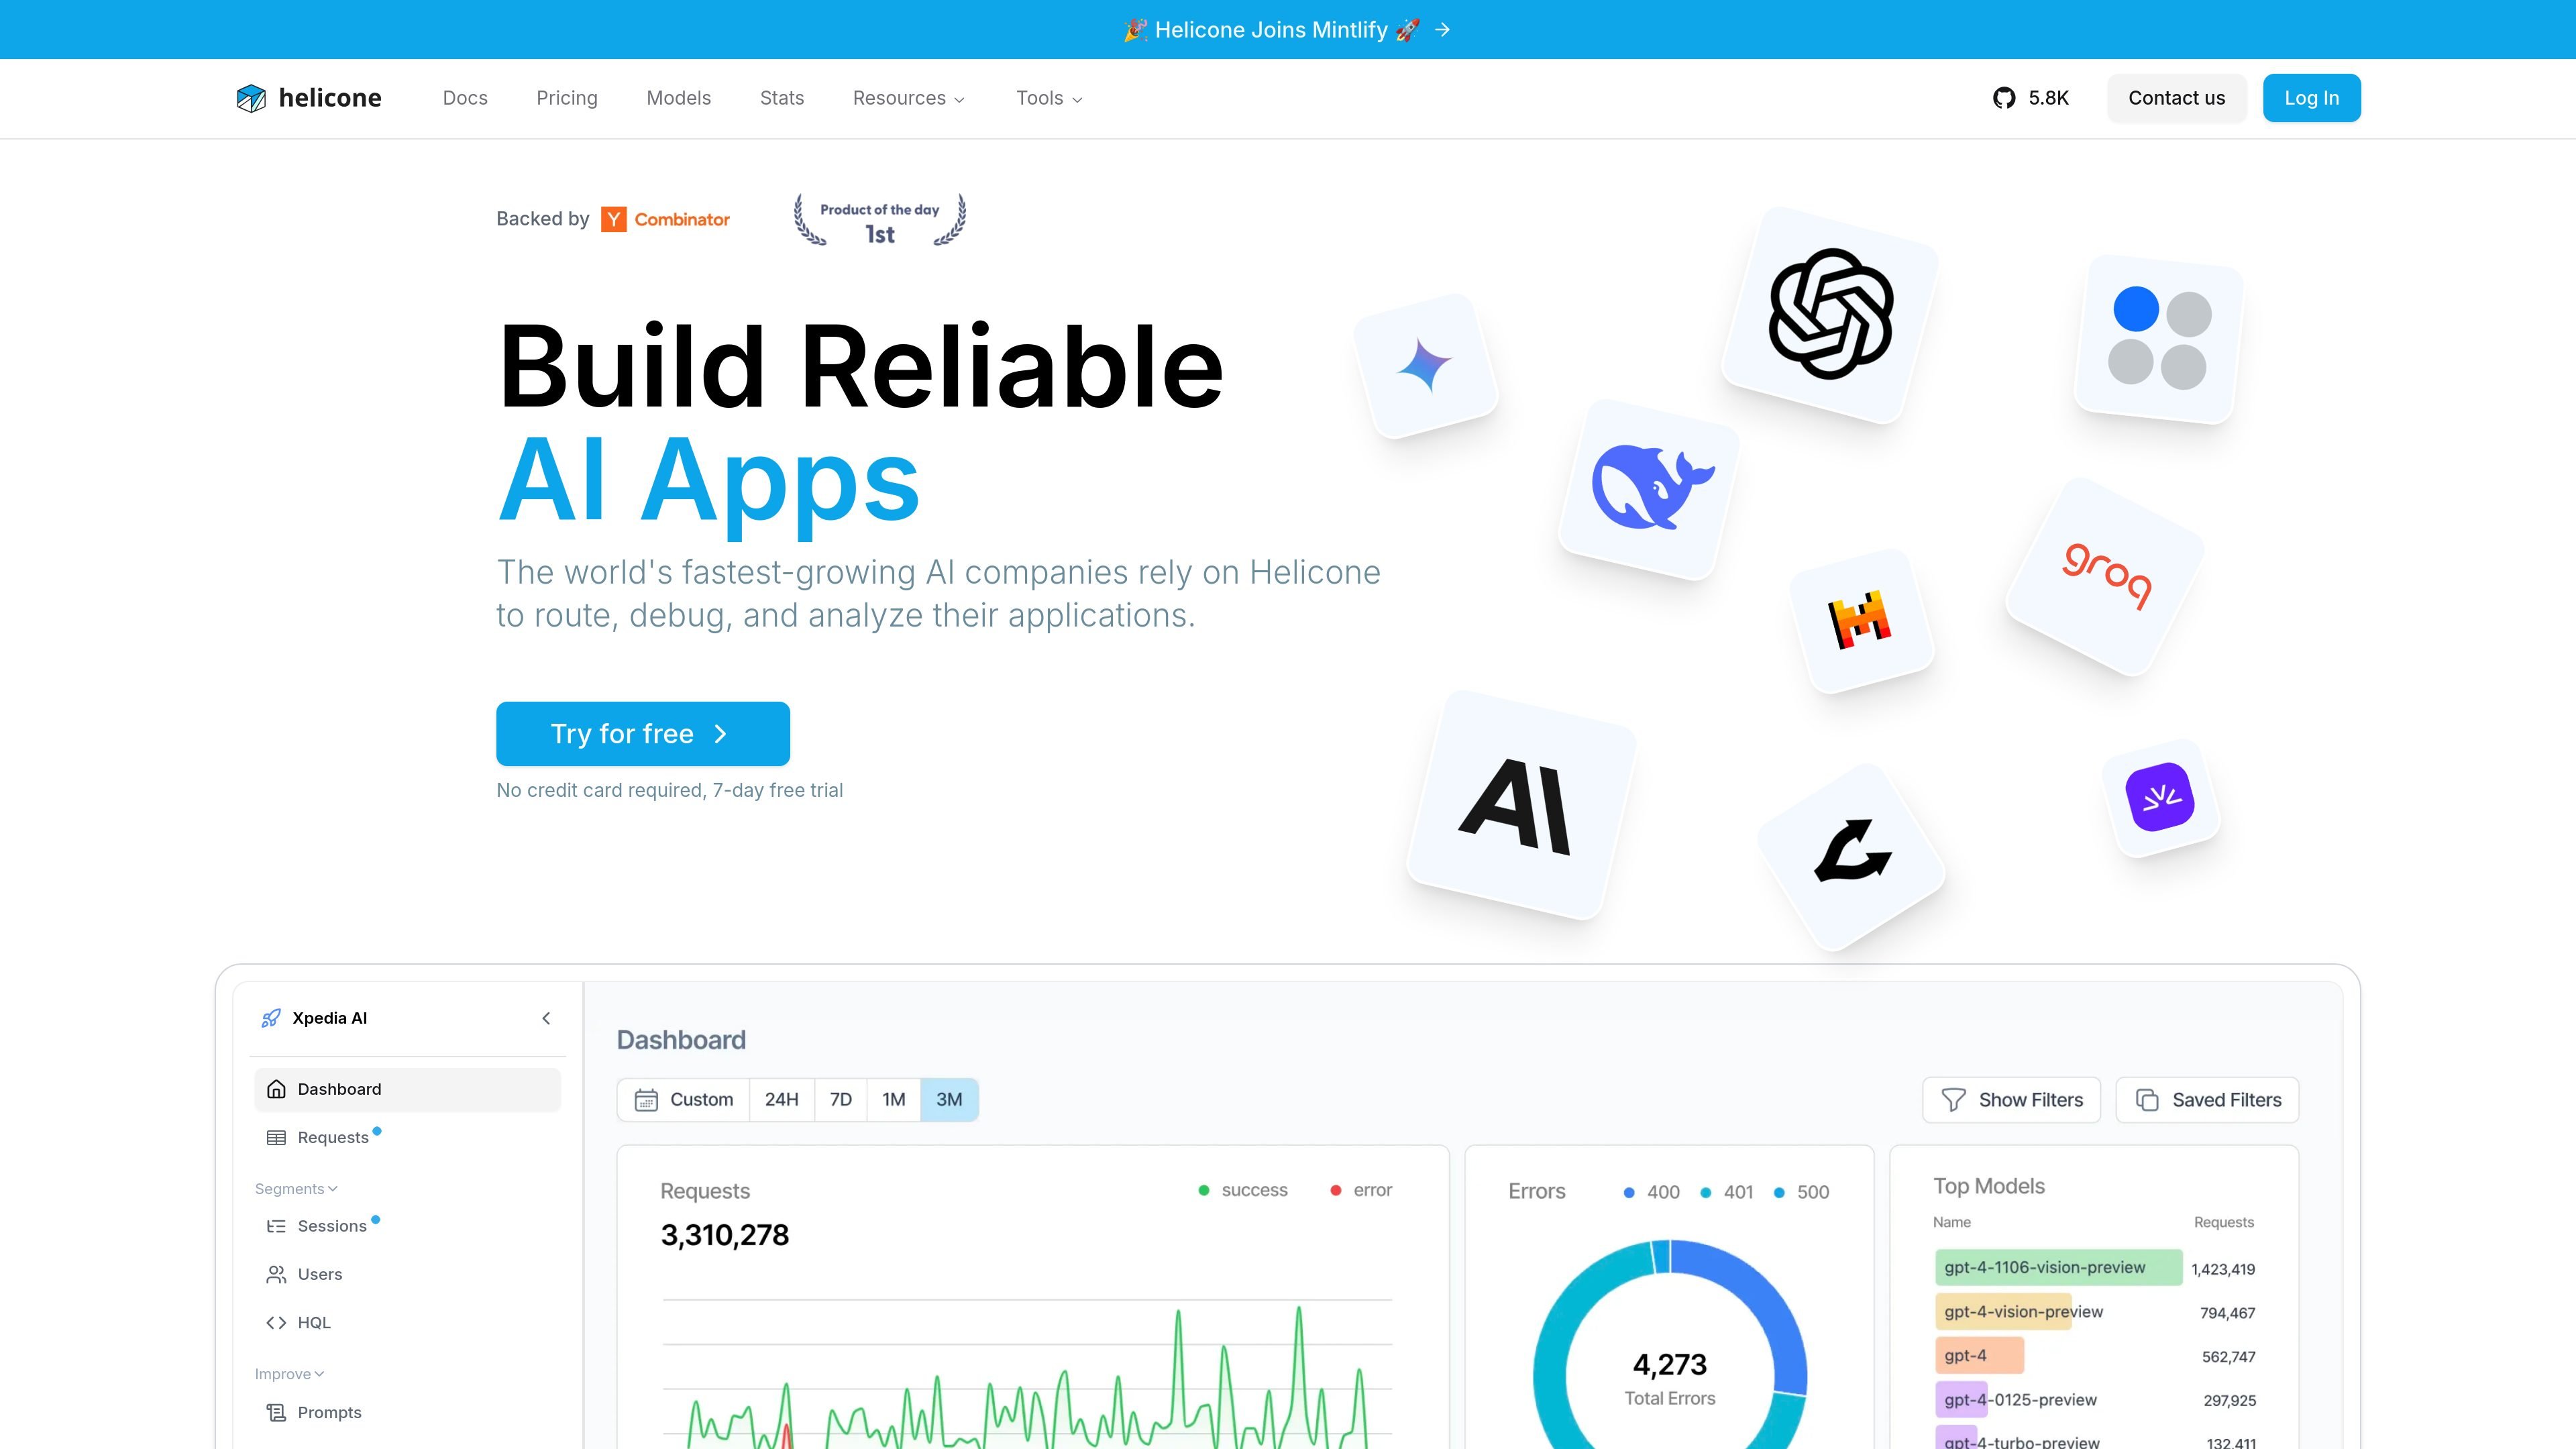
Monitorización del uso, los costes y la latencia
Realiza un seguimiento del uso de los modelos, el gasto y la latencia de las respuestas para identificar cargas de trabajo costosas y cuellos de botella de rendimiento.

Pasarela de IA y plataforma de observabilidad de código abierto para que desarrolladores monitoricen el uso, los costes y la latencia de modelos de lenguaje en sus aplicaciones.
Helicone es una pasarela de IA y plataforma de observabilidad de código abierto para aplicaciones que utilizan modelos de lenguaje de gran tamaño. Ayuda a los desarrolladores a enrutar solicitudes a modelos, investigar el comportamiento de las aplicaciones y comprender el uso, la latencia y los costes en varios modelos de IA.
Los equipos pueden integrar Helicone en sus flujos de trabajo de IA existentes, incluido su uso como proxy para solicitudes a modelos. Sus herramientas de monitorización, control de solicitudes y pruebas permiten realizar análisis y optimizaciones continuos. Helicone ofrece un servicio basado en la nube y asistencia para implementaciones autohospedadas.
En su anuncio de adquisición del 3 de marzo de 2026, Helicone indicó que sus servicios seguirían activos en el futuro previsible en modo de mantenimiento, con actualizaciones de seguridad, nuevos modelos y correcciones de errores y rendimiento. Ten en cuenta este estado de mantenimiento al planificar una dependencia a largo plazo.
Realiza un seguimiento del uso de los modelos, el gasto y la latencia de las respuestas para identificar cargas de trabajo costosas y cuellos de botella de rendimiento.
Enruta las solicitudes a modelos a través de una pasarela con almacenamiento en caché, límites de velocidad y alternativas automáticas. Las capacidades de cambio de modelo permiten modificar los modelos utilizados por una aplicación.
Añade propiedades personalizadas a las solicitudes para realizar un análisis más detallado de la actividad de la aplicación. Las sesiones y los análisis de usuarios ofrecen formas adicionales de examinar el uso.
Pro incluye Helicone Query Language (HQL), alertas e informes para investigar la actividad registrada y monitorizar las operaciones en curso.
Utiliza el área de pruebas para probar prompts, sesiones y trazas, y trabaja con prompts, puntuaciones y conjuntos de datos para inspeccionar el comportamiento de los modelos.
La retención, según el plan, va de siete días en Hobby a indefinida en Enterprise. La comparación de precios también incluye el acceso a la API y la exportación de datos.
Cuando una aplicación se ralentiza, los desarrolladores pueden examinar la latencia junto con las solicitudes registradas y la actividad de las sesiones para localizar las cargas de trabajo que requieren atención.
Utiliza propiedades personalizadas para distinguir las cargas de trabajo y examinar su uso de modelos y costes, lo que ayuda a los equipos a decidir dónde centrar los esfuerzos de optimización.
Utiliza el almacenamiento en caché de la pasarela para las solicitudes repetidas y configura límites de velocidad y alternativas automáticas como parte del flujo de gestión de solicitudes de una aplicación.
Los equipos que necesitan controlar la infraestructura pueden explorar el autoalojamiento. Los paquetes Enterprise incluyen implementación local, SAML SSO y un MSA personalizado.
Hobby incluye 10.000 solicitudes al mes, 1 GB de almacenamiento, un puesto y una organización. La retención de datos indicada es de siete días. Se trata de una asignación para observabilidad; la inferencia de modelos a través de la pasarela requiere créditos y debe presupuestarse por separado.
Pro cuesta 79 $ al mes y Team cuesta 799 $ al mes, con cargos basados en el uso aplicables a ambos. Ambos ofrecen una prueba gratuita de siete días. El precio de Enterprise está disponible a través del equipo de ventas.
Helicone permite integrarse en flujos de trabajo de IA existentes, incluido un proxy de pasarela para solicitudes a modelos de IA. Su documentación ofrece una guía de inicio rápido, instrucciones de integración de la pasarela, orientación sobre propiedades personalizadas y detalles de autenticación.
Pro incluye puestos ilimitados y una organización. Team añade cinco organizaciones y un canal de Slack exclusivo. Enterprise incluye organizaciones ilimitadas, SAML SSO, implementación local y un MSA personalizado.
Los datos de tráfico son solo como referencia.

konghq.com
Kong AI Gateway centraliza la gobernanza del tráfico de LLM, MCP y agente a agente dentro de la plataforma de conectividad de IA de Kong, con controles de seguridad, observabilidad, enrutamiento y costes para cargas de trabajo de IA en producción.

featherless.ai
Plataforma de inferencia de IA sin servidor para acceder mediante API a modelos de pesos abiertos, explorar el catálogo y crear aplicaciones sin gestionar servidores propios.
zenmux.ai
Plataforma empresarial de LLM con una API unificada para acceder a múltiples proveedores de modelos, enrutamiento automático de prompts, seguimiento de costes y precios por uso o suscripción.
piapi.ai
PiAPI es una plataforma unificada para generar videos, imágenes, audio, recursos 3D y resultados de LLM mediante un catálogo de modelos, un entorno de pruebas, API, CLI y servidor MCP. Está diseñada para desarrolladores, agentes de IA y flujos de automatización que necesitan acceder a varios modelos generativos.

pydantic.dev
Stack de ingeniería de IA para apps seguras por tipos, observabilidad, evaluación y enrutamiento de modelos

portkey.ai
Plataforma de IA para producción para equipos de IA generativa, con gateway unificado, observabilidad, controles de seguridad y gestión de prompts.